新しいLLM(大規模言語モデル)のリリース記事や技術論文を読むたびに、「MMLUが〇%」「GSM8kで新記録」「HumanEvalで大幅向上」「MT-Benchで最高スコア」といった無数のベンチマーク結果が並んでいて、頭がクラクラした経験はありませんか?
「略称が多すぎて何が何だか分からない」「自社の業務に組み込むなら、どの数字を信じればいいの?」「そもそもチャット性能とコーディング性能って同じテストで測れるものなの?」と疑問に思うのは、現場でAI活用を進めるエンジニアとしてごく自然なことですし、私も日々頭を悩ませてきたテーマです。
結論から言えば、カオスに見えるLLMの評価指標は、「①基礎言語処理(NLP)」「②学術知識・論理推論」「③対話・指示追従・主観評価」「④ドメイン特化(コード・RAG)」「⑤事実性・安全性」「⑥システム運用・コスト」という6つのカテゴリに整理して俯瞰すると、スッキリと全体像が掴めるようになります。
以前当ブログで執筆したLLMのトークン節約術でも触れましたが、どんなに高性能なモデルであっても、自社のユースケースやコスト感に適合していなければ実用には耐えません。この記事では、これから始まる「LLM評価指標の個別深掘り連載」の出発点として、多種多様な評価指標を体系的に整理した全体マップと、目的別の選び方を一挙に解説していきますね!
LLM評価はなぜ複雑なのか?「3つの軸(What・Where・How)」で捉える
そもそも、なぜLLMの性能評価は従来のソフトウェアテストや機械学習モデルの精度測定と比べてこれほど難しく、複雑怪奇なのでしょうか?その背景には、LLMが単なる「特定の計算機」ではなく、極めて人間に近い汎用的な言語能力と推論力を持っているという本質的な難しさがあります。
単一のスコアでは測れないLLMの多面性
従来の機械学習モデルであれば、画像分類ならTop-1 Accuracy、回帰分析ならRMSE(二乗平均平方根誤差)といった単一の指標でモデル間の勝敗が明確に判定できました。しかし、LLMは文章の要約、コード生成、雑談、複雑な論理パズル、専門的な医学問答まで、あらゆるタスクをこなす汎用AIです。
数学の難問が解けるモデルが、必ずしもビジネスメールを親しみやすく書けるとは限りませんし、学術的な知識が豊富なモデルが社内RAG(検索拡張生成)のルールを忠実に守れるとも限りませんよね。つまり、「総合力」という単一の数字は存在せず、評価の目的ごとに異なる定規を当てる必要があるのです。
評価の全体像を捉える「What・Where・How」の視点
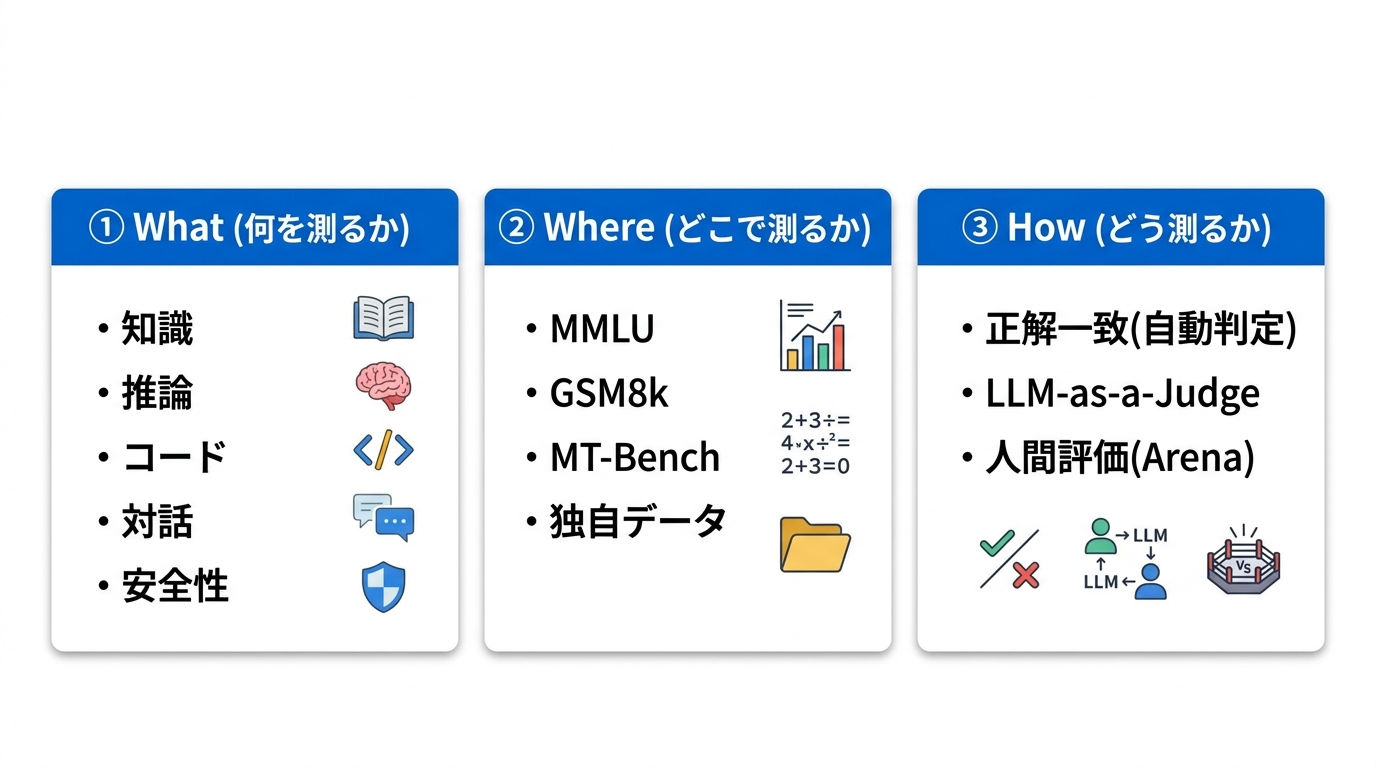
近年のサーベイ論文などでは、LLMの評価体系を整理するために「What(何を測るか)」「Where(どこで測るか)」「How(どうやって採点するか)」という3つの直交する軸で分類するフレームワークが提唱されています。
- What(評価対象の能力): 知識の広さ、論理推論、プログラミング、対話の自然さ、ハルシネーションの少なさ、安全性など、モデルのどのスキルを測りたいのかを定義します。
- Where(テストデータセット・環境): MMLU、GSM8k、MT-Bench、あるいは社内で作成した業務ログなど、どのベンチマークデータセット上でモデルを試すかを決定します。
- How(採点・判定の手法): 正解との完全一致(Exact Match)、正解選択肢の一致、強力なLLMによる自動採点(LLM-as-a-Judge)、あるいは人間によるブラインド投票(Arena方式)など、どうやって合否やスコアをつけるかを決めます。
この3つの軸を頭の片隅に置いておくだけで、新しい指標やベンチマークが登場した際にも「これはWhereが新しいのか、Howの手法が画期的なのか」が瞬時に見抜けるようになりますよ。
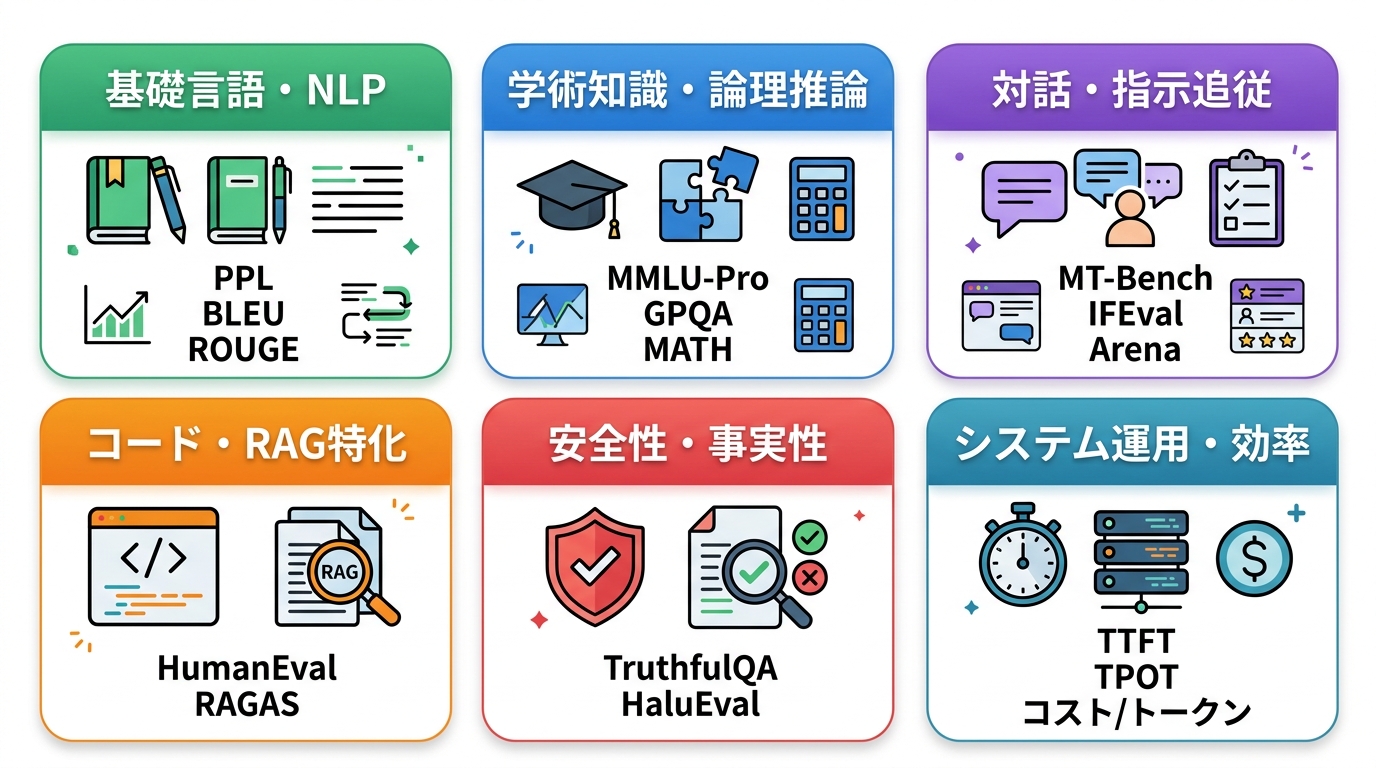
【完全一覧】LLM評価指標・ベンチマークの6大カテゴリマップ
ここからは、現在世界中で広く用いられている主要な評価指標とベンチマークを、エンジニアが実務で活用しやすい6つのカテゴリに分けて一挙に整理していきます。まずは下の全体像を眺めて、気になるカテゴリの概要を掴んでみてください。
① 基礎言語能力・NLP指標(モデル内部の言語適合度)
自然言語処理(NLP)の古典的・基礎的な指標群です。主にモデルの事前学習時やファインチューニング直後の品質チェックに用いられます。
- Perplexity(PPL: パープレキシティ): 次に来る単語をどれだけ正確に予測できているかを示す「予測の迷いやすさ」。値が小さいほど言語モデルとしてテキストを自然に学習・モデリングできていることを示します。
- BLEU / ROUGE: 機械翻訳や文章要約の評価に使われる指標です。模範解答テキストとモデル生成テキストの間で、単語の重複率(N-gramの一致度)を統計的に算出します。
② 学術知識・論理推論ベンチマーク(頭脳の地頭力)
フロンティアモデルの発表会で最も華々しく競い合われる、いわば「知能テスト」に該当する領域です。Hugging FaceのOpen LLM Leaderboardなどでも中核を成しています。
- MMLU / MMLU-Pro: 初等数学から歴史、法律、コンピュータサイエンスまで全57分野の多肢選択式問題。最近は難易度を上げ選択肢を10択に拡張した「MMLU-Pro」が主流になりつつあります。
- GSM8k / MATH: 小学校レベルの算数文章題(GSM8k)や、高校数学オリンピックレベルの超難問(MATH)。多段階の論理ステップを踏めるか(思考力)を試します。
- GPQA: 博士課程レベルの物理・化学・生物などのGoogle検索では簡単に答えが出ない難問集(Google-Proof Q&A)。最先端モデルの推論限界を測る指標です。
- BBH(Big-Bench Hard): 人間には解けるが従来の言語モデルが極めて苦手としていた論理・アルゴリズム推論タスク23種を集めた難関テストです。
③ 対話品質・指示追従・主観評価(チャットの実力)
選択式テストが満点でも、ユーザーとの会話が噛み合わなければチャットボットとしては失格ですよね。対話の自然さやフォーマット指示を正しく守る能力を測る指標です。
- MT-Bench: 複数ターンの会話シナリオを通じて、文脈維持力や柔軟な指示対応力を測定するベンチマーク。GPT-4などの強力なモデルを審判(LLM-as-a-Judge)として採点します。
- LMSYS Chatbot Arena(Eloレーティング): 2つの匿名モデルに同じ質問を投げ、人間ユーザーが良いと感じた方に投票するブラインドテスト。現在最も人間の主観満足度に近い指標とされています。
- IFEval(Instruction Following Evaluation): 「400文字以上で書け」「カンマを使うな」「JSON形式で出力せよ」といった客観的なフォーマット制約を厳密に守れるかを検証するルール追従テストです。
④ 特化領域・実務タスク指標(コード・RAG)
特定の実務作業を代替させるために不可欠な実践的ベンチマーク群です。
- HumanEval / EvalPlus(Pass@k): Pythonの関数仕様からコードを生成させ、用意されたユニットテストをパスできるか(機能的正確性)を判定するコーディング指標です。
- SWE-bench: 実際のGitHubリポジトリに投稿されたバグIssueを読み解き、プルリクエストを作成してテストを通過できるかを評価する「AIソフトウェアエンジニア」向けの最難関テストです。
- RAGAS(RAG特化指標): 社内文書検索QAなどのRAGシステムを評価するためのフレームワーク。検索精度を測る「Context Precision」「Context Recall」と、回答品質を測る「Faithfulness(ハルシネーションなし度)」「Answer Relevance(回答関連性)」の4つのメトリクスが有名です。
💡 あわせて読みたい
⑤ 事実性・安全性・ハルシネーション(信頼性の担保)
企業導入で最もトラブルになりやすい「嘘の出力(ハルシネーション)」や「有害コンテンツの生成」を検知するための指標です。
- TruthfulQA: 人間が信じがちな迷信や誤解を誘うトラップ質問に対して、モデルが事実に基づいた真実を答えられるかを検証するベンチマークです。
- HaluEval: テキスト要約やQA、対話においてモデルが勝手に事実無根の内容をでっち上げていないかを検出するハルシネーション評価スイートです。
- ToxiGen / SafetyBench: ヘイトスピーチ、差別的表現、攻撃的な発言を誘発するプロンプトに対する防御力(セーフガード)を測定します。
⑥ システム運用・効率性指標(スピードと費用)
どれほど賢くても、1回の回答に30秒かかったり莫大なクラウド代がかかってはビジネスになりません。運用エンジニアが最も注視すべき実用指標です。
- TTFT(Time to First Token): プロンプトを送信してから最初の1トークンが出力されるまでの時間(初期応答レイテンシ)。対話アプリの体感速度を直撃します。
- TPOT(Time Per Output Token): 2トークン目以降が1トークンあたり何ミリ秒で生成されるか(ストリーミングのスムーズさ)。
- スループット(Tokens/sec): サーバー全体で1秒間に処理できる総トークン数。同時アクセス耐性の指標です。
- コスト効率($/1M Tokens): 入力・出力100万トークンあたりの利用料金。ROI(投資対効果)を計算する上での必須メトリクスです。
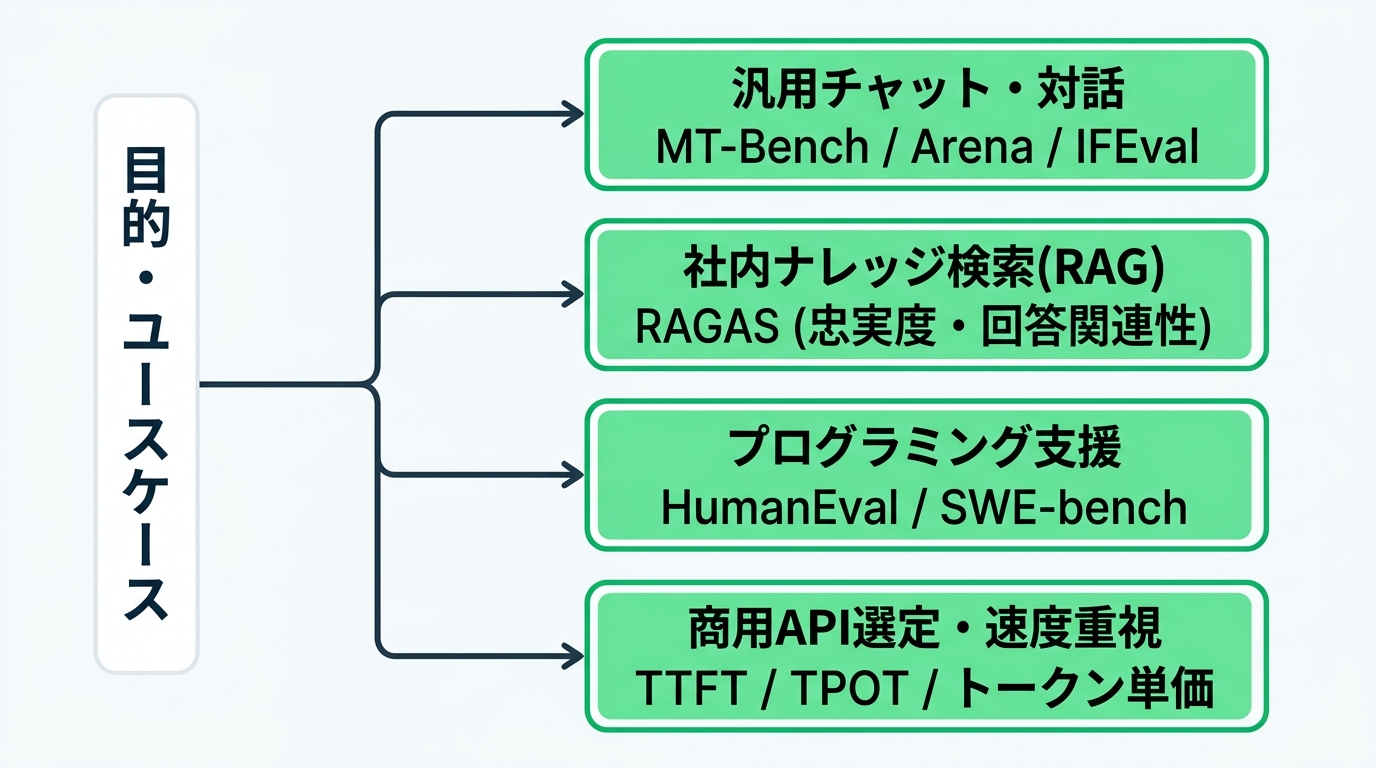
現場で迷わない!目的別の評価指標選定フローと注意点
これだけ多くの指標が揃っていると、「結局、自分のプロジェクトではどれを見ればいいの?」と迷ってしまいますよね。ここでは、現場の開発フェーズで失敗しないための選定フローと、ベンチマークを見る際の重要な注意点を整理しておきます。
ユースケース別のベスト指標選定ルール
基本ルールはシンプルで、「エンドユーザーが触れる体験に最も近い指標をプライマリ(主指標)に据える」ことです。
- カスタマーサポート・汎用AIアシスタント: 一般会話の満足度や人間ウケが最優先されるため、LMSYS Chatbot ArenaのEloレーティングとMT-Bench、そして指示を守らせるためのIFEvalを軸に選定します。
- 社内文書・マニュアル検索QA(RAGシステム): 独自の社内データを参照させる場合、一般教養のMMLUスコアはほとんど参考になりません。RAGASのFaithfulness(文書から逸脱していないか)とContext Precision(正しい箇所を検索できているか)を計測するのが鉄則です。
- 自社開発ツールのコード自動生成: 単にコードを書くだけならHumanEval、既存リポジトリの複数ファイルを横断してバグ修正させるエージェントならSWE-benchのスコアを重視します。
- 大量バッチ処理や高負荷APIサービス: 知能スコアの足切りラインを設けた上で、TTFT / TPOTとトークン単価($/1M tokens)のトレードオフ曲線を引いてモデルを選びます。
ベンチマーク飽和と「データ汚染(Contamination)」の罠
評価指標を見る上で、エンジニアが絶対に知っておくべき落とし穴が「データ汚染(Data Contamination)」と「ベンチマーク飽和」です。
公開されている有名なテスト問題(初代MMLUやGSM8kなど)は、Web上の膨大な学習データの中に問題文と正解が含まれてしまっているケース(カンニング状態)が多々あります。「MMLUで90%を超えた!」と謳うオープンモデルを実際に使ってみると、少し聞き方を変えただけで急に珍回答を連発する……という現象は、この過学習が原因であることが少なくありません。
そのため、Hugging Faceも「Open LLM Leaderboard v2」へと移行し、より問題文が新しくカンニングが困難なMMLU-ProやGPQAへとテストを刷新しました。カタログスペックの数値を鵜呑みにせず、「そのスコアは汚染対策されたベンチマークか?」「自社の独自プロンプトでも同等の精度が出るか?」を常に疑う姿勢が大切ですね。
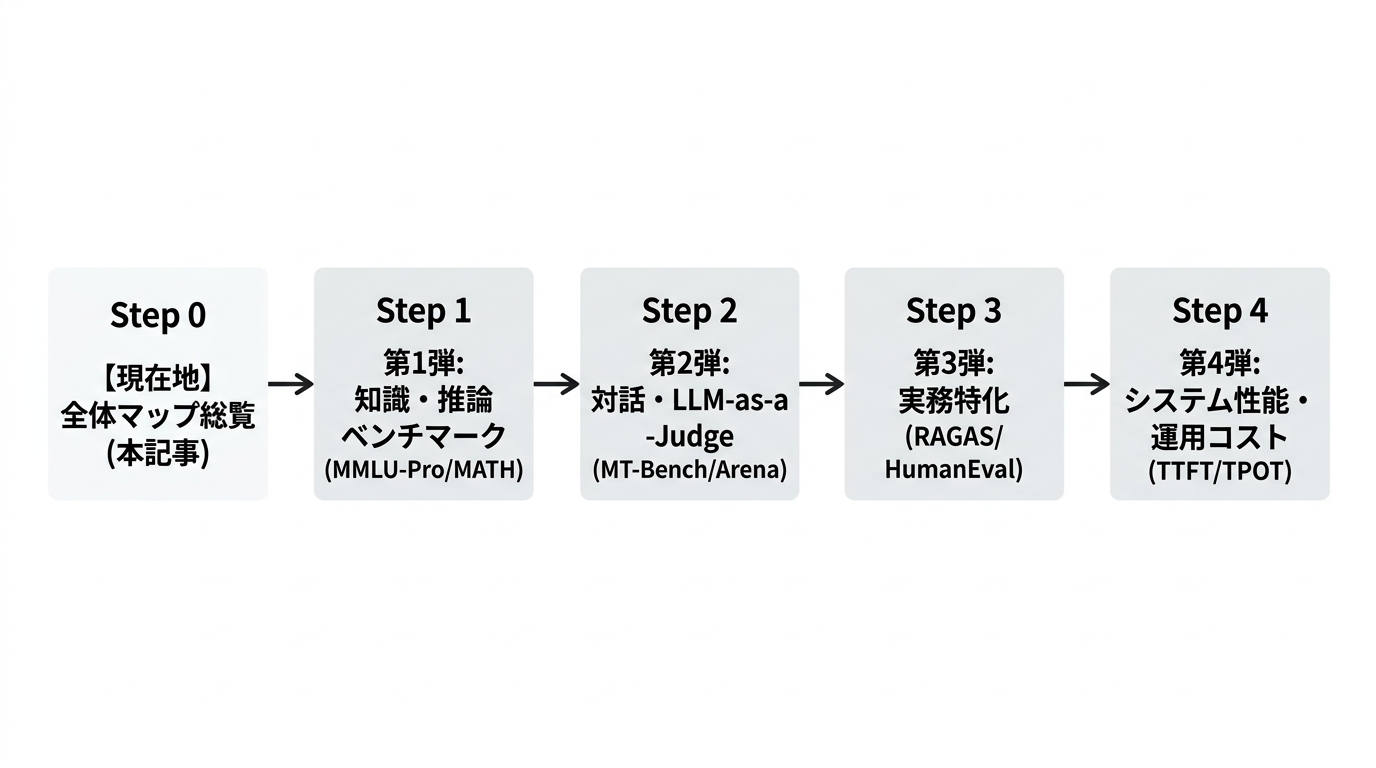
今後の連載ロードマップとエンジニアとしての向き合い方
今回は「全体マップ」として主要なカテゴリと代表指標を俯瞰してきましたが、いかがでしたでしょうか?それぞれの指標が生まれた背景や、テストの具体的な仕組み、自前で評価スクリプトを動かす方法などは、まだまだ語り尽くせないほど奥が深い世界です。
個別解説連載の今後のステップ
当ブログでは、今回の全体マップを「Step 0」として位置づけ、今後以下のようなステップで各評価指標を徹底解説していく予定です!
- 第1弾: 知識・論理推論ベンチマークの正体(MMLU-Pro、GPQA、MATHの出題ロジックと各モデルの得手不得手を分析)
- 第2弾: 対話品質とLLM-as-a-Judgeの仕組み(MT-BenchやChatbot Arenaの採点プロンプト設計、審判モデルのバイアス問題と対策)
- 第3弾: 実務直結!RAGASとコーディングベンチマーク入門(社内RAGの自動テスト環境構築手順とHumanEval・SWE-benchの読み解き方)
- 第4弾: システムレイテンシと運用コストの最適化(TTFT・TPOTの測定方法と、モデル選定における費用対効果の最適解)
連載記事が公開されたら、本記事にも順次各詳細記事へのリンクを繋ぎ込み、「LLM評価の総合リファレンス」としてアップデートしていきますので楽しみにしていてくださいね。
単一の指標に踊らされない「自前の評価環境」を育てよう
最後にエンジニア目線での所感を述べると、公開ベンチマークはあくまで「モデル選びの初期スクリーニング(候補絞り込み)」のための道具に過ぎません。
現場で本当に価値を生むのは、「自社の実際の業務ログやユーザー入力から集めた、数十〜数百件の独自テストセット」です。公開ベンチマークで上位のモデルを2〜3個ピックアップし、最後は自前の評価セットでRAGASやLLM-as-a-Judgeを回して決める。この「二段構え」の評価パイプラインを構築することこそが、ブレないAI開発の近道ですよ!
まとめ
今回は、無数に存在するLLMの評価指標を6大カテゴリに分類し、全体像を体系的に把握するための完全マップをお届けしました。要点を振り返ってみましょう。
- LLM評価の3つの軸: 「What(能力)」「Where(ベンチマーク)」「How(判定手法)」を意識すると混乱を防げる。
- 評価指標の6大カテゴリ: ①基礎NLP、②知識・推論、③対話・指示、④コード・RAG特化、⑤事実性・安全性、⑥システム運用の6つに大別される。
- ユースケース別の選定: チャットならArena/MT-Bench、RAGならRAGAS、コードならHumanEval、運用ならTTFT/コストを主軸にする。
- データ汚染への警戒: 単一の公開スコアを過信せず、自前の評価データセットと組み合わせて多面的に検証することが極めて重要。
今後予定している各指標の詳細解説記事もぜひチェックして、現場でのモデル選定やプロンプト改善に役立ててくださいね!
あわせて読みたい