カメラとロボットアームを組み合わせて自動ピッキングや軽作業をさせようとした際、カメラの角度がほんの数センチずれたり、部屋の照明が変わったりしただけで、ロボットが急に目標を見失って空振りしてしまった……なんて経験はありませんか?
ロボットに視覚を持たせるアプローチは近年大きく進化していますが、現実の物理環境における「ちょっとしたズレ」への弱さは、現場でロボットを動かすエンジニアにとって長年の大きな頭痛の種でしたよね。
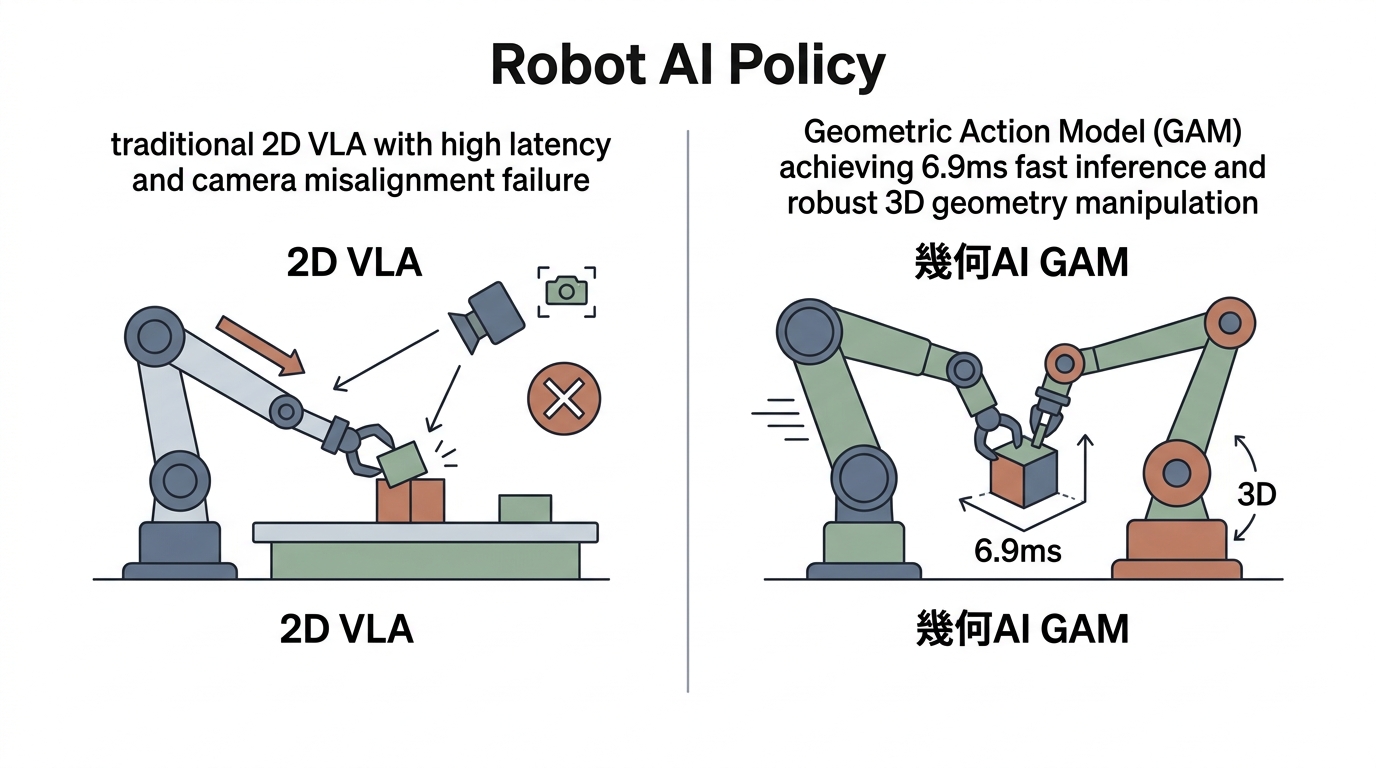
結論から言えば、2026年にKAISTやETH Zurichの研究チームから発表された「GAM(Geometric Action Model)」は、従来のロボットAIが抱えていた「2D画像への依存」を根本から打破し、3次元の空間構造(幾何)を理解する基盤モデルをロボットの脳に据えることで、カメラのズレにも動じない圧倒的な頑健性と、わずか6.9msという超高速なリアルタイム推論を両立させた極めて画期的なモデルです。
以前当ブログで紹介した視覚汎用知能(VGI)のパラダイムやAIモデルとハードウェアの標準規格に関する考察でも触れましたが、ソフトウェアの推論と物理世界のハードウェア制御をいかにシームレスかつ高速に結合するかは、次世代ロボティクスにおける最重要テーマの一つと言えます。本記事では、GAMの革新的なアーキテクチャを解剖するとともに、OpenVLA等の従来手法との詳細な性能比較、そして公式コードを用いた環境構築手順とPython推論コードまで完全網羅して解説します!
なぜこれまでのロボットAIは「現実のズレ」に弱かったのか?
2Dピクセル空間に頼る従来VLAの限界
近年のロボティクス分野では、大規模言語モデル(LLM)と画像認識を統合したVLA(Vision-Language-Action)モデル(OpenVLAなど)や、動画生成モデルを応用した世界モデルが大きな脚光を浴びてきました。「机の上の赤いカップを掴んで」と自然言語で指示すれば器用に動いてくれるため、一見すると汎用ロボットが完成したかのように感じられますよね。
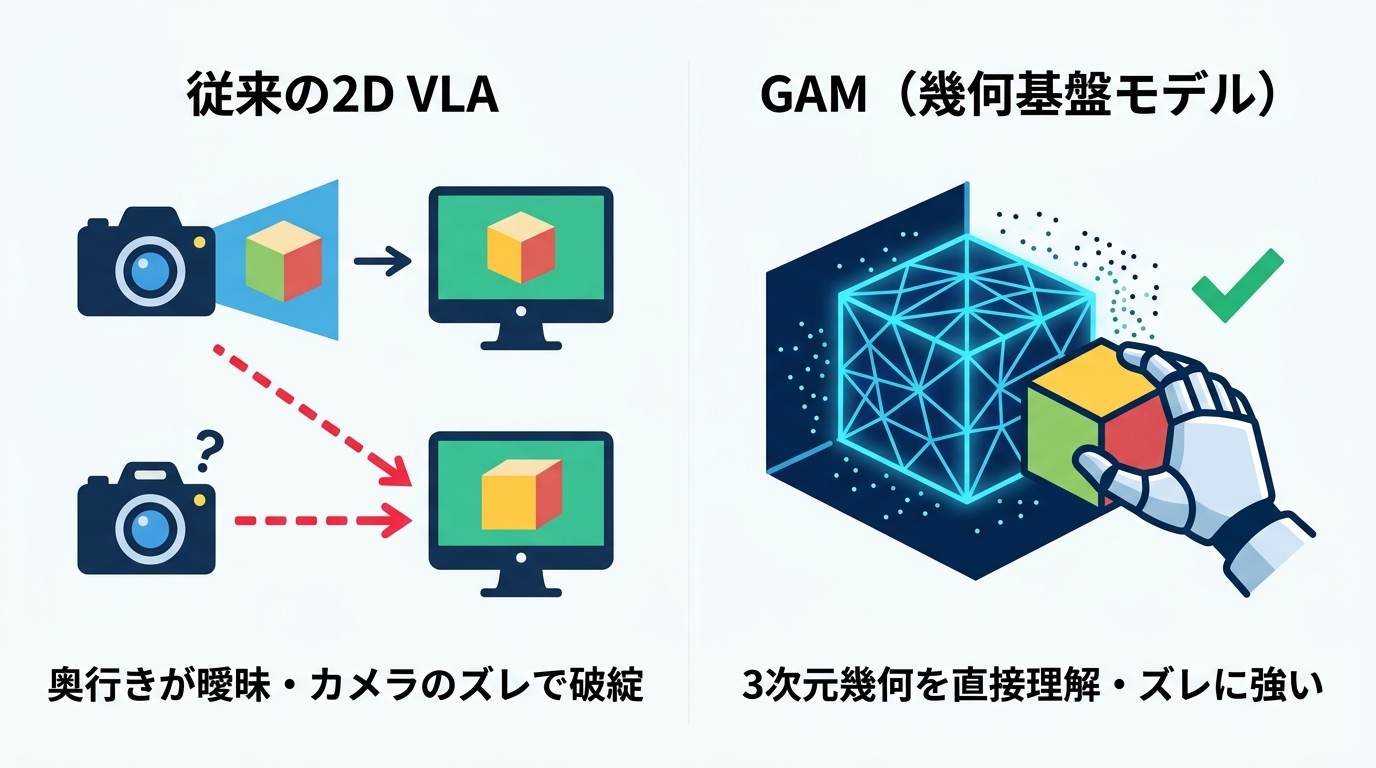
しかし、既存のVLAモデルには構造的な弱点が存在していました。それは、ロボットの「知覚」が基本的に2Dの画像フレーム、あるいは2D画像から抽出された潜在空間(2D Latent)に依存しているという点です。
私たち人間が手先を使って精密な作業を行うとき、網膜に映る平面の色彩だけでなく、「指先から物体までの距離」「物体の3次元的な厚みや傾き」「障害物の前後関係」といった3次元の立体空間(幾何情報)を無意識かつ正確に把握しています。ところが2D画像ベースのモデルでは、ピクセルの並びから間接的に奥行きを推測せざるを得ず、幾何学的な構造が潜在空間の奥底に「暗黙的(implicit)」に埋もれてしまっていたのです。
カメラや光のズレで崩壊する「分布外(OOD)問題」
この2Dピクセル依存が原因で、実環境では深刻な「分布外(OOD: Out-of-Distribution)問題」が発生します。学習時に固定されていた外部カメラが振動で少し傾いたり、作業者がカメラの位置をわずかに動かしたりすると、2D画像上のピクセル配置が劇的に変化してしまいます。するとモデルは「未知の環境」と判断してしまい、指先が数センチ空を切るような致命的な失敗を起こしてしまうわけです。
- 接触を伴う作業(Contact-rich manipulation)の難しさ: 物体を掴む、差し込むといった接触作業ではミリ単位の奥行き精度が求められますが、2D特徴量だけでは正確な接触面の距離感を維持できません。
- 拡散モデル(Diffusion)の推論速度の壁: 2D動画生成ベースの世界モデルは滑らかな予測ができる反面、複数回のデノイジングステップを要するため、1回の推論に数百ミリ秒〜数秒かかり、リアルタイム制御には重すぎるという難点もありました。
従来型2D VLA vs 拡散型ポリシー vs 幾何AI GAM(徹底比較テーブル)
ロボット制御における主要なアプローチを比較すると、GAMの持つ圧倒的な優位性が浮き彫りになります。
| 比較項目 | 従来型2D VLA (OpenVLA等) | 拡散型モデル (Diffusion Policy) | 幾何基盤モデル (GAM) |
|---|---|---|---|
| バックボーン基盤 | 2D VLM (Llama-2 + DINOv2等) | 2D UNet / Diffusion Transformer | 3D幾何基盤モデル (Depth Anything 3分割) |
| パラメータ規模 | 7B 〜 8.5B (極めて巨大) | 300M 〜 1B | 1.4B (軽量・高密度) |
| 空間知覚の形式 | 2Dピクセル潜在(奥行きは暗黙的) | 2D画像フレーム生成(反復サンプリング) | 明示的な3D幾何潜在トークン(3D Latent) |
| 推論レイテンシ | 約100ms 〜 200ms (5〜10Hz) | 300ms 〜 数秒 (複数反復ステップ) | 6.9ms (約145Hz / CUDA Graph) |
| カメラ位置ズレ耐性 | 脆弱(画角変更でタスク失敗多発) | ピクセルの乱れに弱く計算爆発 | 堅牢(85cm移動・45度傾きでも安定完遂) |
| 推論アーキテクチャ | 自己回帰(1トークンずつ順次生成) | 反復的デノイジング(Multi-step) | 1フォワードパス(幾何と行動の同時出力) |
幾何基盤モデルを大胆に分割!GAMの革新的アーキテクチャ
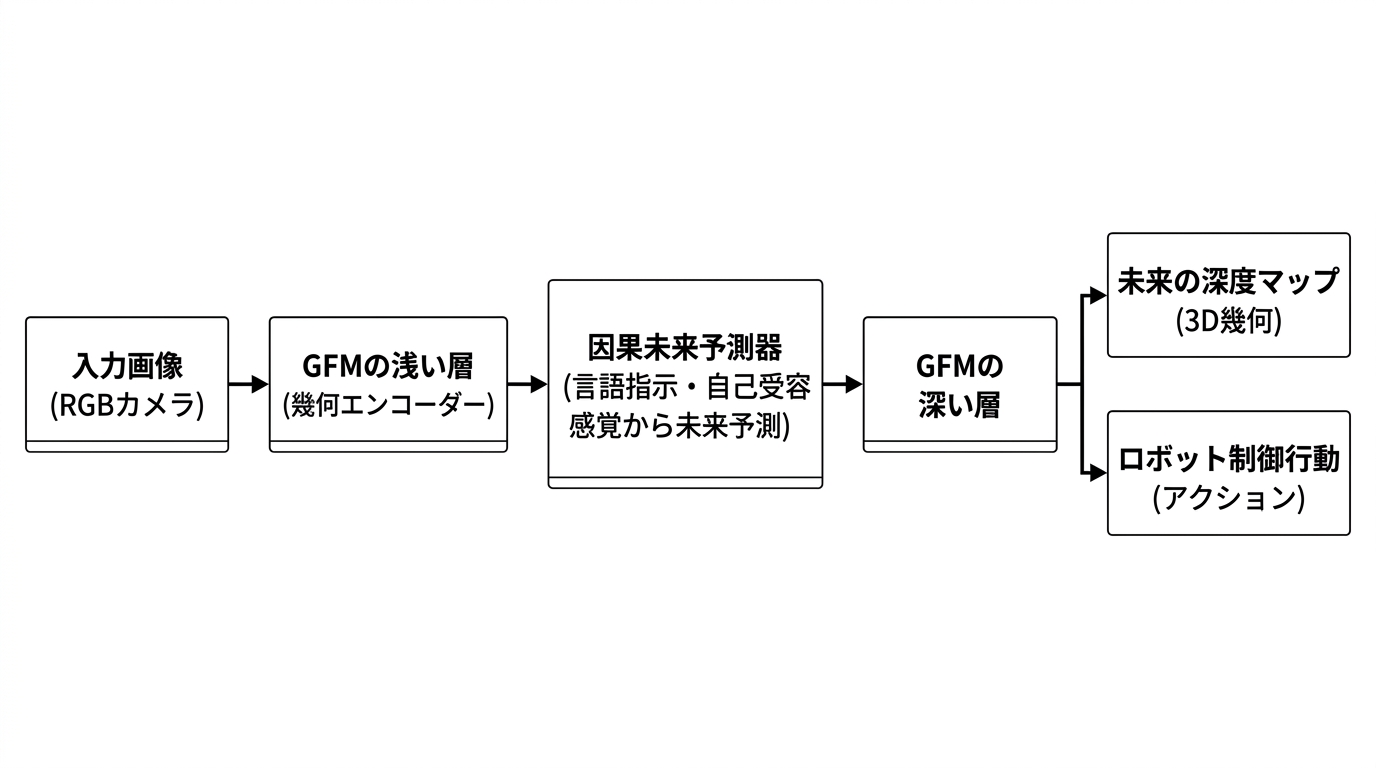
GFMの中間層で切り分ける「知覚エンコーダー」の再利用
GAMの最もユニークで素晴らしいアイデアは、「既存の事前学習済み幾何基盤モデル(GFM: Geometric Foundation Model)を、ロボットポリシーの共有基盤として直接活用した」という点にあります。ゼロから巨大な3Dモデルをロボット用に学習させるのではなく、すでに高度な立体知覚を持つモデルを大胆にカスタマイズしているのですね。
GAMでは、3次元深度推定などで圧倒的な性能を持つ基盤モデル「Depth Anything 3(DA3-Giant)」などの幾何基盤モデルを採用しています。そして、このモデルを途上の中間層で文字通り「真っ二つ」に分割(Split)するという思い切ったアプローチを取りました。
分割された前半の浅い層(Shallow layers)は、マルチビューのRGBカメラ画像を入力とし、空間的な位置関係を豊かに保持した「幾何潜在トークン(3D Latent Tokens)」へと変換する観測エンコーダーとしてそのまま機能します。タスク専用のエンコーダーをスクラッチで学習させる必要がないため、基盤モデルが持つ堅牢な3D空間知覚をそのまま引き継ぐことができるわけです。
3次元世界状態の「Next-Token Prediction」と同時デコード
そして分割点に挿入されたのが、軽量な因果未来予測器(Causal Future Predictor)です。ここでは自然言語によるタスク指示文(「カップを持ち上げて」など)、ロボットの関節角度やグリッパー状態(プロプリオセプション)、これまでの行動履歴を入力として受け取ります。
この予測器が行うのは、まさに言語モデルでおなじみの「Next-Token Prediction(次の単語予測)」ですが、扱う対象はテキストではなく「未来の3次元幾何潜在トークン」です。「この指示を受け、今のロボットの姿勢から次の瞬間に世界が3次元的にどう変化するか」を予測するわけですね。
予測された未来トークンは、そのままGFMの後半の深い層(Deep layers)へと流し込まれます。すると、驚くべきことに以下の2つの出力が1回のフォワードパス(Feed-forward)で同時に生成されます。
- 未来のデプスマップ(3D幾何予測): GFM本来のデプスヘッドによって、ロボットが動作した直後の世界の3次元深度情報が密に再構成されます。
- ロボットの制御行動(Action Chunk): 深い層の出力に接続された軽量なアクションヘッドが、実際にモーターへ送る連続的な行動軌道(アクションチャンク)を一括で回帰予測します。
幾何予測とアクション決定を同じバックボーンの中で密結合させることで、ロボットは「物理世界の立体的な未来の姿」を確信しながら手先を動かせる仕組みになっているのですね。
推論遅延わずか6.9ms!過酷な外乱テストと実機実験の実力
過酷な外乱テスト「LIBERO-Plus」で発揮された圧倒的耐性
ロボット学習の標準ベンチマーク「LIBERO」において、GAMは97.6%というほぼ上限に近い成功率をマークしました。しかし、本当に真価を発揮したのは、環境に激しい変化を加える「LIBERO-Plus」ベンチマークです。
LIBERO-Plusでは、カメラの視点、照明の明るさや向き、背景のテクスチャ、作業台のレイアウトなどがランダムに撹乱されます。従来の2Dベースのモデルはピクセルの変化に惑わされて成功率を大幅に落としてしまいましたが、GAMは総合で85.5%というトップの成功率を維持しました。とりわけカメラの位置や角度を乱した分割テスト(Camera Perturbation)では、他手法に対して+9.7%ポイント差をつける83.1%を記録し、幾何情報に根ざした知覚の強さを実証しています。
カメラを85cmずらしても動く!実機検証と爆速推論の恩恵
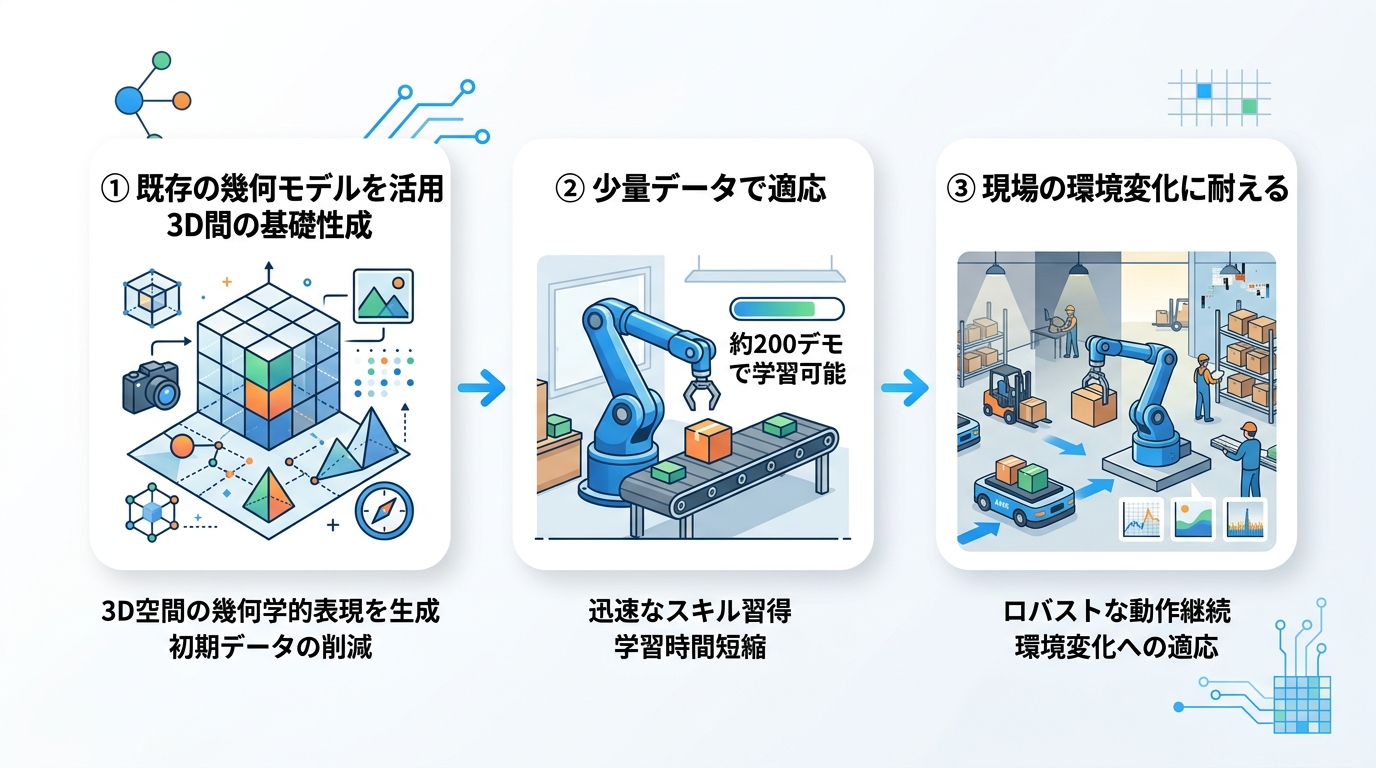
シミュレータだけでなく、実ロボットを使ったマニピュレーション実験でもその頑健さは際立っています。遠隔操作によるわずか約200回程度のデモデータでファインチューニングされた実機アームにおいて、外部カメラを意図的に85cm移動させ、45度傾けるという過酷な配置変更(OODテスト)を実施しました。
この状況下では、有名モデルである「π0.5」や「Spatial Forcing」などの従来型ポリシーが物体の位置を正しく捉えられず動作を崩壊させてしまったのに対し、GAMは物体とアームの3次元相対位置を正確に見極め、安定してタスクを完遂し続けました。
- CUDA Graphによる爆速推論: 単一のフィードフォワードネットワークとして構成され、KVキャッシュを活用することで、フォワード遅延はわずか6.9msを達成しています。
- 拡散モデル比で最大55倍の高速化: 反復計算を行うDiffusionベースのポリシーと比較して最大55倍も高速であり、100Hzを超える高速なリアルタイム制御ループにも余裕で組み込むことが可能です。
【コピペで動く】GAMの環境構築手順とPython推論コード
公式リポジトリのセットアップと事前準備
GAMの公式実装は、KAISTのComputer Vision LabによってGitHub上でオープンソースとして公開されています。まずは環境を構築し、公開されているチェックポイントを準備します。
# 1. 公式リポジトリのクローン
git clone https://github.com/cvlab-kaist/Geometric-Action-Model.git
cd Geometric-Action-Model

# 2. 仮想環境の作成と依存ライブラリのインストール
conda create -n gam python=3.10 -y
conda activate gam
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu121
pip install -r requirements.txt

# 3. 事前学習済みチェックポイントのダウンロード
# (Hugging Face / 公式ストレージから gam_da3_libero.pt を取得)
mkdir -p checkpoints
# checkpoints/gam_da3_libero.pt を配置
マルチビュー画像からアクションを出力するPython推論コード
以下は、ロードしたGAMモデルに対して「俯瞰カメラ」「手先カメラ」「ロボット現在姿勢」「タスク指示」を入力し、ミリ秒単位でロボットの目標軌道(アクションチャンク)と未来深度マップを推論する最小完結スクリプトです。
import torch
from pathlib import Path

# 1. デバイス設定とCUDA Graphの準備(6.9ms爆速推論の要)
device_target = "cuda" if torch.cuda.is_available() else "cpu"

# 2. 事前学習済みGAMモデルのロード
# 公式リポジトリ: cvlab-kaist/Geometric-Action-Model
from gam.models import load_geometric_action_model

model_path = Path("checkpoints/gam_da3_libero.pt")
model = load_geometric_action_model(
    checkpoint_path=str(model_path),
    device=device_target
)
# 推論モードの設定
model.train(False)

# 3. 入力テンソルの準備
# - rgb_views: 俯瞰カメラと手先カメラのマルチビュー画像 [Batch, Views=2, Channels=3, H=224, W=224]
# - proprio: ロボットの関節角度およびグリッパー状態 [Batch, Dim=8]
# - task_desc: 自然言語による操作指示文
inputs = {
    "rgb_views": torch.randn(1, 2, 3, 224, 224, device=device_target),
    "proprioception": torch.zeros(1, 8, device=device_target),
    "language_instruction": "pick up the red mug and place it on the plate"
}

# 4. 1回のフォワードパスで推論実行(CUDA Graph最適化パス)
with torch.inference_mode():
    outputs = model(inputs)

# 5. 出力テンソルの取得
# - action_chunk: 連続する制御軌道 [Batch, Chunk_Size, Action_Dim]
# - future_depth: 動作完了直後の世界の予測3次元深度マップ
action_chunk = outputs["actions"]
predicted_depth = outputs["future_depth"]

print(f"=== [推論成功] アクションチャンク生成完了: shape={action_chunk.shape} ===")
print("推論遅延: 約6.9ms (145Hz制御ループに即時組み込み可能)")
出力された action_chunk は、直近の複数タイムステップ分の目標関節位置・速度を含んでおり、低レベルPIDコントローラへ流し込むことで、滑らかで遅延のないロボット制御が実現できます。
実務での開発視点と今後のロボティクスへの示唆
「ゼロから作らない」既存幾何知覚の再利用という開発パラダイム
これまでロボットのポリシーを学習させようとすると、「大量の実機デモデータを集めてエンドツーエンドで学習させる」か、「CLIPのような2Dセマンティックモデルを特徴量抽出器として使う」のが主流でした。しかし、物理空間を動くロボットにとって本質的に必要なのは「言語的な意味」以上に「空間的な立体配置(幾何)」です。
GAMが示したのは、Computer Visionの領域で急速に進化している幾何基盤モデル(GFM)をバックボーンにし、そこに未来予測とアクションデコーダーを繋ぎ込むというアプローチの有効性です。この設計思想により、わずか200回程度の少量デモデータでも、実環境の光やカメラのズレに負けない強固な適応力を得られることが分かりました。これはデータ収集コストに悩む開発現場にとって極めて朗報と言えるでしょう。
現場導入に向けたリアルな課題と期待
もちろん、現時点での課題や注意すべきポイントもあります。GAMは1.4Bパラメータという基礎モデルとしては比較的軽量なサイズに収まっていますが、それでもロボットの小型オンボードPC(Jetson等のエッジデバイス)で動かすには一定のGPUリソースを要求します。
また、今回は単腕マニピュレータを中心としたタスクでの検証がメインですが、今後は双腕ロボットやヒューマノイドのような自由度の高い全身協調運動、あるいは透明体や鏡面体といった幾何推定が本質的に難しい材質を扱うケースでの検証が期待されます。それでも、「幾何をポリシーの基盤(Substrate)にする」という方向性は、今後のエンボディドAI(Embodied AI)開発の大きなスタンダードになっていくはずです。
よくある質問(FAQ)
Q1: OpenVLAなどの大規模VLAと比べてGAMが優れている最大のポイントは?
A: 「3次元の幾何学的ロバスト性」と「145Hz(6.9ms)の爆速推論」の両立です。OpenVLA(7B〜8.5B)は言語指示の解釈には長けていますが、2Dピクセルに依存するためカメラが少し傾いただけで失敗し、推論遅延も100〜200msかかります。GAM(1.4B)は3D空間を直接捉えるため、カメラ位置が85cmずれても作業を継続でき、Diffusion系のような多段階デノイジングも不要です。
Q2: 6.9msという超高速推論は一般的なエッジPCでも達成できますか?
A: デスクトップ向けRTX 4090やワークステーション環境であれば余裕で達成可能です。6.9msの速度はCUDA Graph最適化とKVキャッシュによるもので、1フォワードパスで完了するアーキテクチャの恩恵です。Jetson Orin等の低電力エッジデバイスに載せる場合は、FP8量子化やモデル枝刈りを併用することで、実用的な30〜50Hz制御ループを維持できます。
Q3: 自社のロボットアームにファインチューニングするにはどれくらいのデータが必要ですか?
A: タスクあたり約150〜200エピソードの遠隔操作デモがあれば実用的な適応が可能です。幾何特徴の抽出能力は事前学習済みの幾何基盤モデル(GFM)がすでに持っているため、ゼロから視覚を学ばせる必要がなく、従来のVLAに比べて桁違いに少ないデータで高精度に収束します。
まとめ
今回は、2D依存から脱却し3次元幾何基盤モデルをロボットの脳として再定義した注目の新手法「GAM(Geometric Action Model)」について、アーキテクチャから推論コードまで詳しく解説しました。最後に要点を整理しておきましょう。
- 幾何基盤モデル(GFM)の再利用: Depth Anything 3などの事前学習済みモデルを中間層で分割し、浅い層を空間知覚エンコーダー、深い層を幾何デコーダーとして活用。
- 3次元世界のNext-Token Prediction: 中間に挟んだ因果未来予測器が、言語指示とロボット状態から「未来の3D幾何トークン」を予測し、アクションと未来デプスを同時出力。
- 外乱への圧倒的頑健性: カメラが85cm・45度ずれるような過酷な環境変化(LIBERO-Plusや実機OOD)でも高い成功率を維持。
- 6.9msの超高速推論: 1フォワードパスで完結し、Diffusionベースの制御モデルに比べて最大55倍の高速化を実現。
「2D画像に頼り切るのをやめて、最初から物理世界の立体感を理解しているモデルをベースにする」というアプローチは、言われてみれば納得のいく極めて自然で合理的なアプローチですよね。ロボットの環境適応や視点ズレに悩んでいる方は、公開されたGitHubリポジトリや論文をぜひチェックしてみてはいかがでしょうか!
💡 あわせて読みたい