AI開発

AI活用

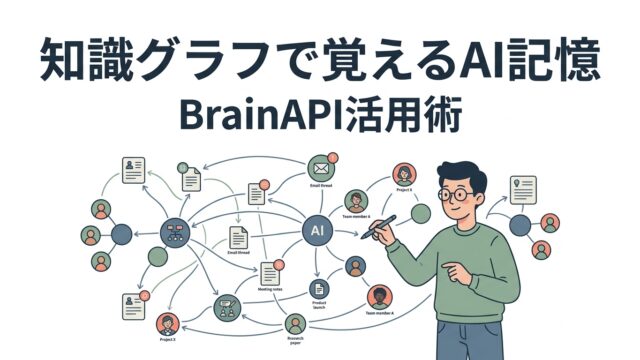
BrainAPIで実現するAIの長期記憶 — 知識グラフによる根拠追跡と実務活用術

テキストから自動でナレッジグラフを構築し、AIに根拠追跡可能な長期記憶を付与する「BrainAPI」の解説。従来のベクトル検索RAGとの構造的な違い、4体のエージェントによるグラフ構築の仕組み、障害履歴追跡やMCP連携の実務シナリオを紹介します。
AI・機械学習

フレームワークなしで作る!PythonとFunction Callingによる自作AIエージェント入門

LangChain等の高レベルフレームワークを使わず、公式OpenAI SDKと素のPythonのみでReAct型AIエージェントをゼロから構築する入門ガイド。AST解析による安全なツール実装、ループ遮断ハーネス、実機実行ログを網羅します。
AI・機械学習

ハーネスエンジニアリングとは?AIエージェントを実務で動かす「制御基盤」の設計論

自律型AIエージェントの無限ループやコンテキスト劣化を防ぐ制御基盤「ハーネスエンジニアリング」の設計論。ツール接続・状態永続化・ガードレール・実行監視・自己修復の5大コア要素と、導入前後の実測比較データを詳しく解説します。
AI・機械学習

Jev徹底解剖|BERTとの違い・System 1の仕組みと導入手順

文章生成を捨てたAI「Jev」を徹底解剖!エンコーダ型BERTとの決定的な違いや並列サンプラーの仕組み、実務ユースケース、Pythonでの導入手順と最小実行コードまで現役エンジニアがわかりやすく解説。判断処理の高速化に必見です。
AI・機械学習

GSM8kとMATHで測るLLMの思考力!小学校算数から数学難問までの解法ステップ検証

LLMの思考力を測る「GSM8k」と「MATH」を徹底比較。算数文章題から難関数学まで、CoT(思考の連鎖)の役割や、計算ミスを防ぐ「LLM立式+Python実行」の実務アーキテクチャを分かりやすく解説します。
AI・機械学習

BLEUとROUGEの違いとは?LLM評価指標の計算式と使い分け

テキスト生成AIの品質を数値化するBLEUとROUGEの算出アルゴリズムを比較。適合率を測るBLEUと再現率を重視するROUGEの計算ロジック、Brevity Penalty、日本語形態素解析によるスコア変動の注意点を整理します。
AI・機械学習

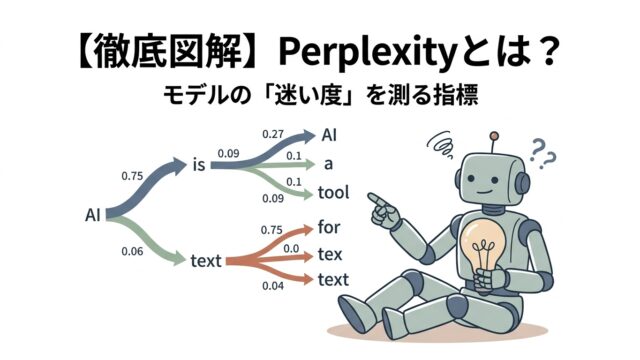
Perplexity(PPL)とは?計算方法と具体例でわかるLLM評価指標

LLMの予測性能を測る基本指標Perplexity(PPL)の数学的定義と直感的意味を図解解説。モデル比較での見方や注意点をエンジニア向けに整理。
AI・機械学習

GPT-6 Astra自律エージェントの衝撃!実践事例から学ぶ設計論と実装術

自律型AIエージェントとしての飛躍が期待されるGPT-6 Astraの構造と革新性。長期推論と自己修正能力がもたらす開発・業務の変化を解説。
AI・機械学習

言語モデルの限界を越える「VGI(視覚汎用知能)」とは?世界的AI研究者21名が提唱する新パラダイム

単一VLMの限界を超える「VGI(視覚汎用知能)」の構造と可能性。複数エージェントが協調して高度な視覚認識を実現する新パラダイム。
AI・機械学習

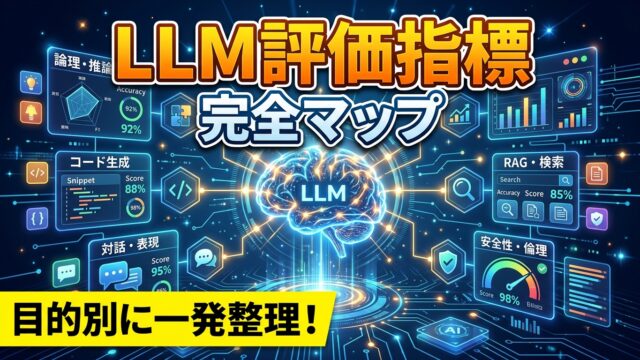
LLMの評価指標・ベンチマーク完全総覧!目的別カテゴリマップと実務での選び方【全体俯瞰編】

LLMベンチマークの全体像を体系化。知識・推論・対話・コードなど目的別の評価指標マップと、自社開発での評価指標の選び方を網羅した完全ガイド。