大規模言語モデル(LLM)は高度なコード生成や文書要約を正確にこなす一方、3次元空間における物体の重なり・奥行き関係や物理的な重力挙動の推論において基礎的な誤りを生じやすいという課題を抱えています。
当ブログのLLMの推論能力の限界と課題に関する考察でも触れたように、テキスト記号の確率予測のみに依存したモデルには物理世界との「幾何学的接地(Geometric Grounding)」が欠如しています。この限界を突破する新パラダイムとして、産総研やスタンフォード大学、Google DeepMind等の世界的AI研究者21名が共同提唱した「Visual General Intelligence(VGI:視覚汎用知能)」が注目を集めています。
本記事では、VGIホワイトペーパーが定義する3つの柱を解説するとともに、テキストLLMが空間認識で失敗する具体例の実験検証、およびオープンソースの空間知覚モデル「Depth Anything v2」をPythonで動かす実装コードの手順を詳しく解説します。
なぜ「言語モデル(LLM)だけではAGIに到達できない」と言われるのか?
カンブリア爆発に学ぶ「眼」の誕生と知能の起源
生命の進化の歴史を振り返ると、生物に高度な「眼(視覚システム)」が誕生したのは、今から約5億年前のカンブリア紀にまで遡ります。眼の誕生によって生物は周囲の空間、光、障害物、捕食者の動きを瞬時に知覚できるようになり、これが生命の爆発的な多様化(カンブリア爆発)を駆動したと言われていますよね。
一方で、人類が文字や体系的な文法、自然言語を操るようになったのは、生物の歴史から見ればごく最近(数万年〜数千年前)の出来事に過ぎません。私たち人間も、言葉を1語も話せない赤ん坊のころから、手足をバタつかせ、物を落とし、見つめるという「視覚と身体の相互作用」を通じて、重力や奥行き、物体の永続性といった物理世界の基本ルールを自然に体得しています。
言語は人間が圧縮した記号に過ぎないという決定的な壁
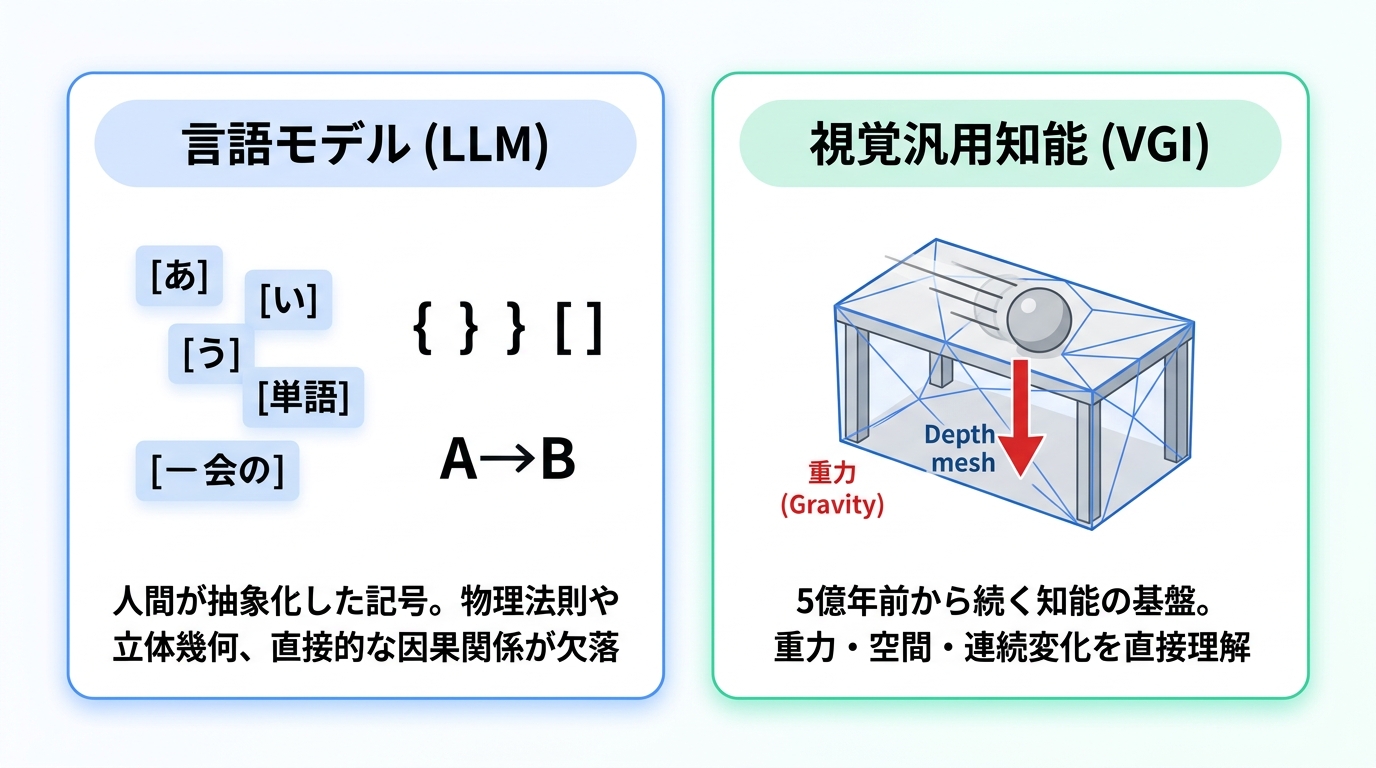
つまり、自然言語とは「人間が認知した物理世界の膨大な情報の中から、ごく一部を抽出して圧縮したシンボル体系」に過ぎないのです。テキストの中には、3次元の幾何構造やミリ単位の連続的な力加減、光と影の相互作用といった生々しい物理現実そのものは存在しません。
- 言語の限界(圧縮の代償): 言語は高度に抽象化されているため論理や要約には強い反面、物理世界の立体構造や空間的因果関係を直接表現することができません。
- 視覚の豊かさ(非記号の連続信号): 視覚はピクセルという膨大な連続データであり、言語のように都合よく定義されたトークン階層を持ちません。だからこそ、視覚から直接学習することでしか得られない「世界の内部モデル」が存在するのです。
言語モデル(LLM)と視覚汎用知能(VGI)の対比マトリクス
両者の思想と能力の差を整理すると、以下の対比テーブルのようになります。知能の基盤をどこに置くかという前提が根本から異なっています。
| 比較項目 | 言語モデル (LLM / 従来VLM) | 視覚汎用知能 (VGI) |
|---|---|---|
| 学習の中心信号 | 離散的なテキストトークン(離散記号列) | 連続的なピクセル・動画フレーム・3D幾何信号 |
| 世界理解の手法 | 単語の共起関係・確率的次単語予測 | 物体の永続性、幾何学、物理法則の内部シミュレーション |
| 空間・奥行きの認識 | 不得手(2D画像の錯視や影に騙されやすい) | 得意(ピクセルごとの深度・3Dメッシュを直接復元) |
| 時間的因果関係 | 論理的な推論(テキスト上の因果関係) | 運動方程式・慣性・遮蔽(動画予測を通じた物理因果) |
| 主な活躍領域 | コード生成、文章要約、対話、論理推論 | 人型ロボット、自動運転、空間コンピューティング |
【実験検証】テキストLLMの限界 vs 空間視覚モデルの実力
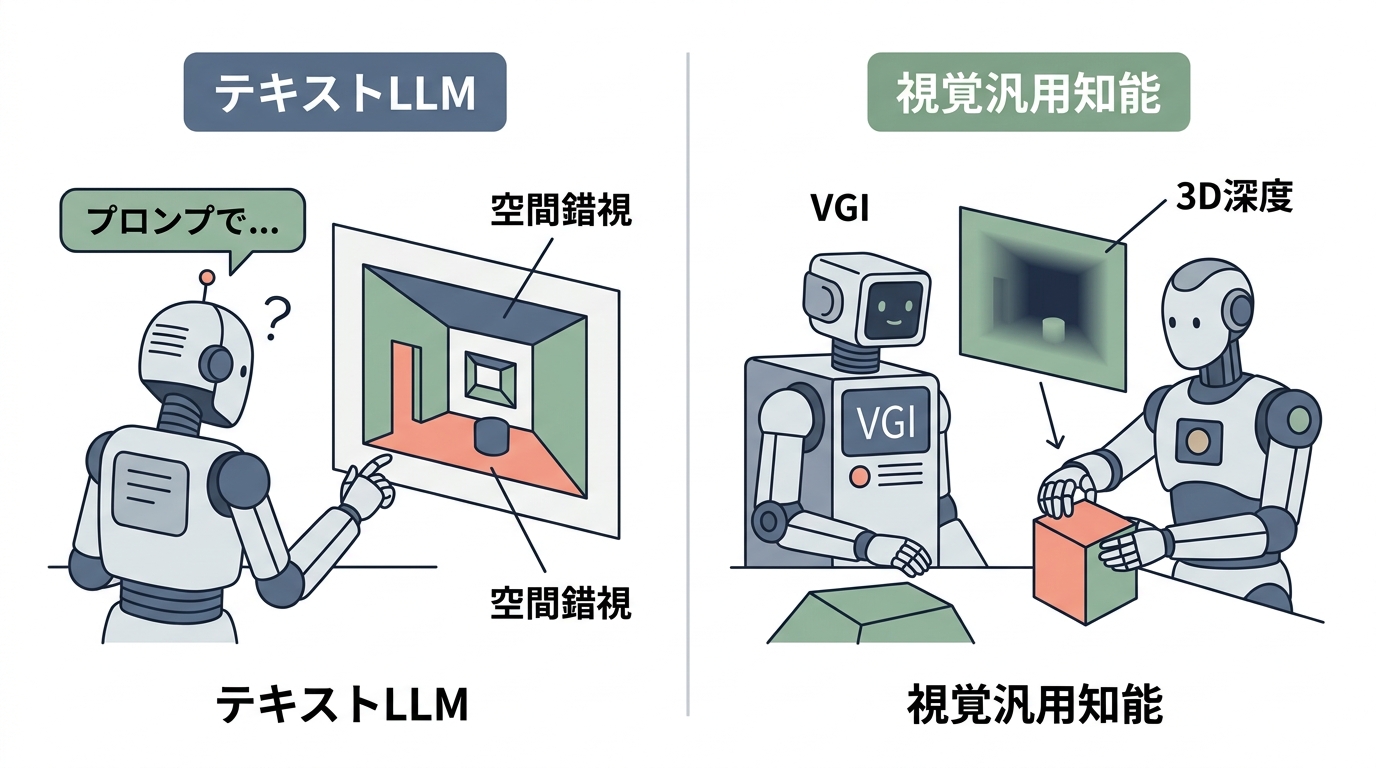
錯視と前後関係:テキストLLMが呆気なく引っかかる「空間認識の罠」
「LLMは画像も見られるマルチモーダル(GPT-4o等)に進化したのだから、視覚も理解できているのでは?」と疑問に思うかもしれません。しかし、実際に手元で実験してみると、決定的な「知能の質の差」が浮き彫りになります。
たとえば、「遠近法によって小さく見える本物のトラック」と「カメラの手前に置かれたミニカー」が写った室内写真を最先端のマルチモーダルLLMに見せ、「どちらの車が手前にありますか?」と尋ねてみてください。多くのモデルは、トラックの細部ディテールに引きずられたり、影の濃淡を誤認して「トラックが手前にある」と自信満々に誤答(ハルシネーション)してしまいます。
さらに、「机の上のマグカップの裏側に隠れているペン」や「斜めに立てかけられた本の支持関係」など、3次元空間における幾何学的な前後・接触関係を問うタスクを与えると、テキストベースのモデルは途端に正答率を落とします。言語トークンに翻訳された情報だけでは、3次元の奥行き(Z軸)を正しく計算できないからです。
視覚モデルはなぜ解けるのか?幾何学的接地(Geometric Grounding)
これに対し、空間知覚を直接学習したVGIモデル(Depth Anything v2など)は、単一の2D画像からピクセル単位の相対深度(Depth Map)を瞬時に推定します。錯視やペイントのトリックに惑わされることなく、カメラからの絶対的な距離をグラデーションとして正確に炙り出すため、ロボットアームが物体を掴む際もミリ単位で空振りを防ぐことができます。
言葉で「手前」「奥」と論理付けする前に、幾何学的な数値として空間を直接捉える。この「幾何学的接地(Geometric Grounding)」こそが、物理世界で自律的に行動する知能に不可欠なピースなのです。
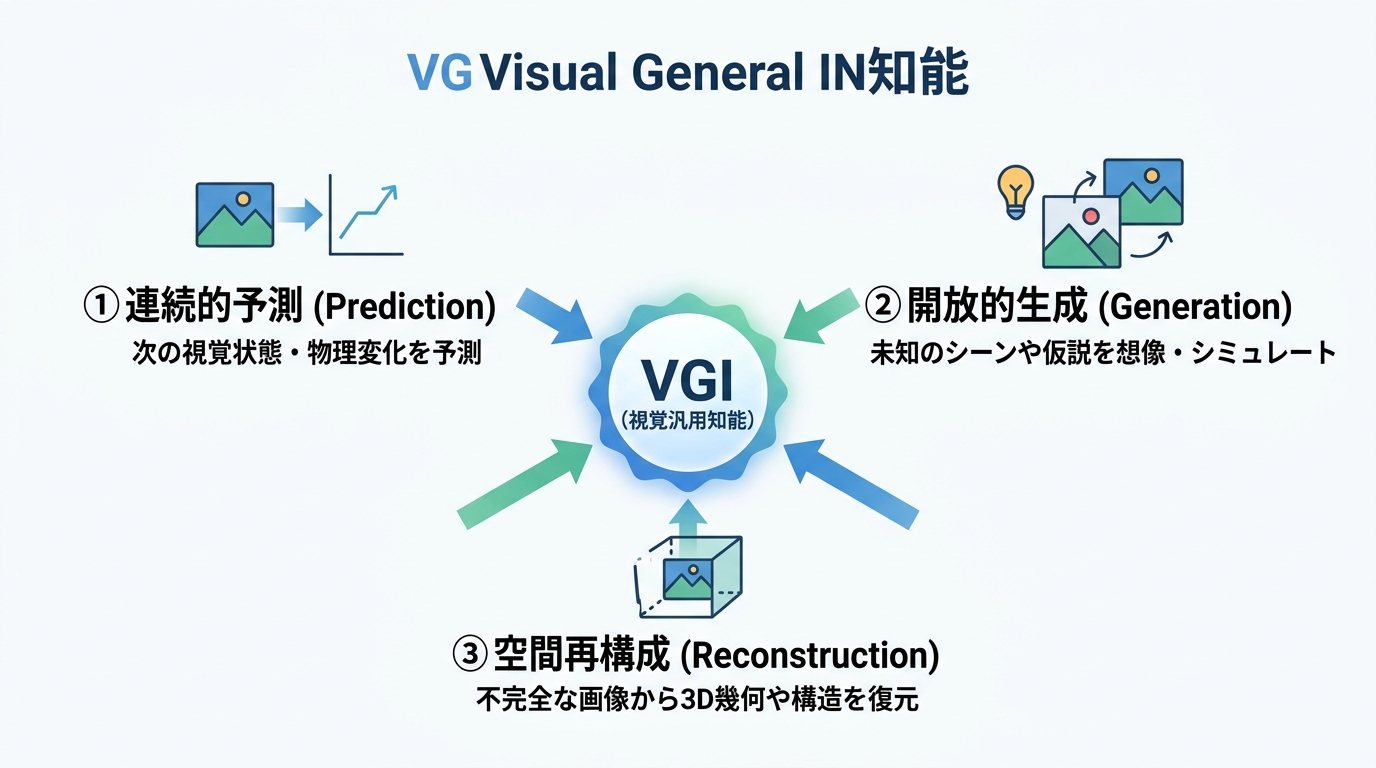
21名の世界的AI研究者が提唱する「VGI(Visual General Intelligence)」とは?
日米欧トップ21名が集結した歴史的ホワイトペーパー
このホワイトペーパーの特筆すべき点は、産総研の片岡裕雄氏らをはじめ、スタンフォード大学のJiajun Wu氏、Meta FAIRのZhuang Liu氏、Google DeepMindのRobert Geirhos氏、カーネギーメロン大学(CMU)のDeva Ramanan氏など、コンピュータビジョン(CV)の歴史を築いてきた最前線の研究者21名が所属の枠を超えて集結した点にあります。
CVPR 2026で開催された「VGI Workshop」での議論をベースにまとめられた本稿は、単一の企業モデルを宣伝するものではなく、「AGI時代においてコンピュータビジョンが目指すべき根本的指針」を体系化したものです。著者らは、VGIを「視覚的な体験を通じて世界の構造を自ら発見・検証し、未来を予測し、未知の可能性を想像し、新しい状況に適応できる知能」と定義しています。
VGIを駆動する3つの柱(連続的予測・開放的生成・空間再構成)
視覚から知能を創発させるための核心的メカニズムとして提示されているのが、以下の3つの相補的な学習オペレーションです。
- ① 連続的予測(Sequential Prediction): 次に来る視覚状態を予測する自己回帰モデル。言語におけるNext-Token Predictionと同様に、「次どうなるか」を正確に予測するためには、物体、動き、遮蔽、物理法則を深く理解しなければならず、これが世界モデルの核となります。
- ② 開放的生成(Open-ended Generation): 未知のシーンやあり得べき未来を想像する生成能力。単なる綺麗な画像出力にとどまらず、エージェントが頭の中で「もしこう動いたらどうなるか?」という反実仮想(Counterfactuals)をシミュレーションするための思考エンジンとなります。
- ③ 空間再構成(Spatial Reconstruction): 不完全な2D画像から、背後にある3次元・4次元の立体構造や物理的因果関係を復元する能力。空間の整合性や物体の実体を捉えるための必須機能です。
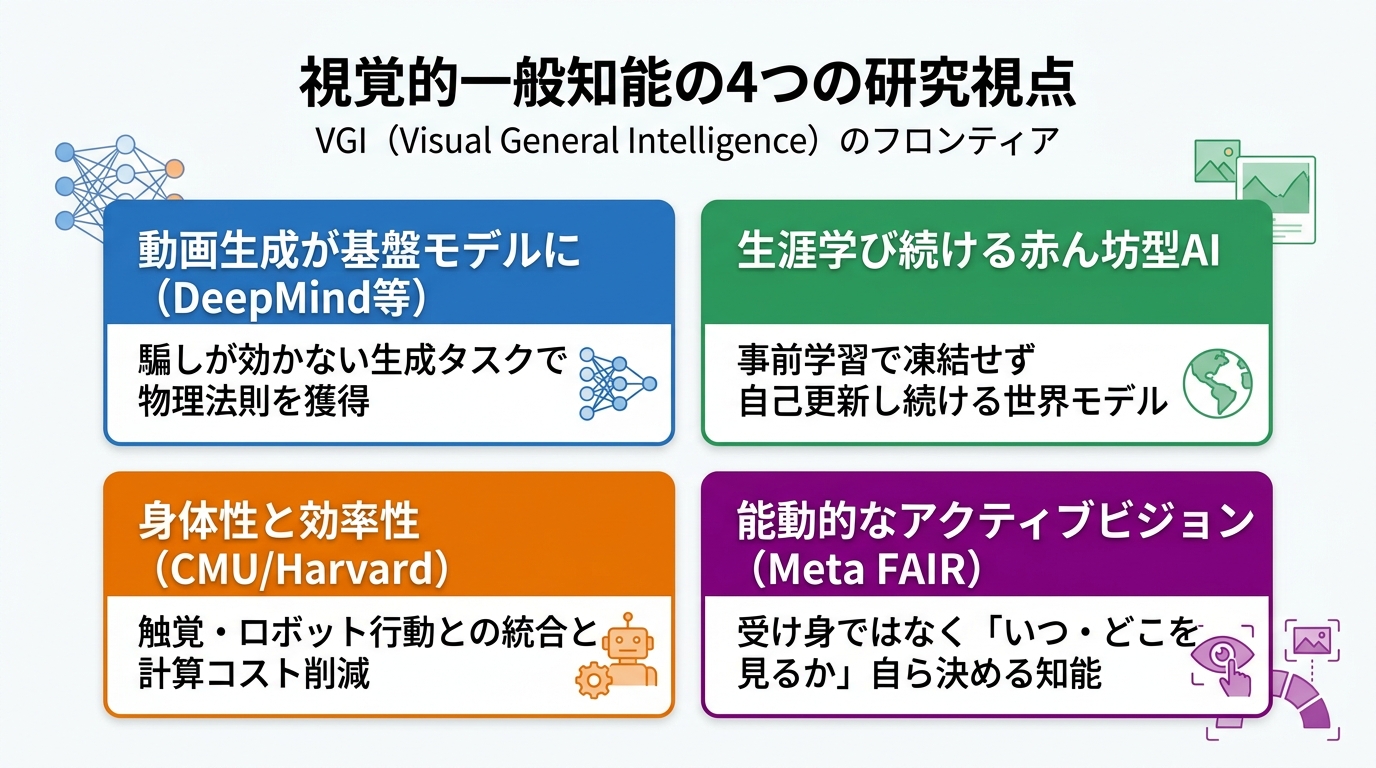
動画生成モデルは「世界モデル」へ進化する?トップ研究者たちの視点
「動画生成」が判別タスクを圧倒する理由(ショートカットの排除)
Google DeepMindのRobert Geirhos氏は、「動画生成モデルこそが次世代の視覚基盤モデルになる」と力説しています。従来の画像分類(ImageNetなど)では、AIは「背景の緑色を見て牛と答える」といった安易なズル(ショートカット学習)をしてしまいがちでした。
しかし、動画生成というタスクではズルが一切通用しません。背景、物体、陰影、テクスチャ、カメラの視点移動、物体の運動を完璧に整合させなければ破綻してしまうため、モデルは学習の過程で「物理法則そのもの」を内包せざるを得ないのです。実際にVeo 3などの最新動画生成モデルでは、明示的に学習させていないセグメンテーションや迷路探索といった視覚推論能力が勝手に創発し始めていることが報告されています。
一度きりの学習から「生涯にわたる自律的適応」へ
また、アムステルダム大学のYuki M. Asano氏やCMUのDeva Ramanan氏、Meta FAIRのZhuang Liu氏らが提起する視点も痛烈です。
- 生涯自律学習(Lifelong Learning): 現在のAIは「巨大データで一度学習して固定(Freeze)する」のが常識ですが、現実世界で動く知能は、赤ん坊のように一生を通じて新しい視覚体験から自己を更新し続けなければならない。
- 身体性と触覚の統合(Embodied AI): ロボティクスにおいて視覚は単独で存在するのではなく、足腰の自己受容感覚や指先の触覚、モーターのトルクと不可分に結びつくことで真の知能になる。
- アクティブビジョン(能動的知覚): 与えられた画像をただ受動的に眺めるのではなく、「次は何を見るべきか」「どこに注目してどの解像度で精査すべきか」をモデル自身が能動的に決めるべきである。
【コピペで動く】VGIの思想を手元で体験するPythonハンズオン
わずか十数行で2D画像から3次元「奥行き(深度マップ)」を復元するコード
「VGIが目指す空間知覚の凄さは分かったけれど、実際にどうやって実装するのか?」と感じたエンジニアのために、オープンソースで公開されている最先端の単眼深度推定モデル「Depth Anything v2」を用いて、一般的な写真から3次元の深度マップを抽出する完全コードを用意しました。
まずは必要なライブラリをインストールします。
pip install torch transformers pillow以下のスクリプトを実行すると、手元の写真からピクセルごとの距離情報を瞬時に推定し、手前にある物体ほど明るく(白く)、奥にある物体ほど暗く(黒く)着色された深度マップ画像を保存できます。
import torch
from transformers import pipeline
from PIL import Image

# 1. Hugging Faceから軽量な空間深度推定モデル(Depth Anything v2 Small)をロード
# 言語モデルと異なり、ピクセルごとの3次元的な「奥行き(Z軸)」を直接出力する
device_target = "cuda" if torch.cuda.is_available() else "cpu"
depth_estimator = pipeline(
    task="depth-estimation",
    model="depth-anything/Depth-Anything-V2-Small-hf",
    device=device_target
)

# 2. テスト用画像の読み込み(作業机や室内のスナップ写真など)
image_path = "workspace_sample.jpg"
raw_image = Image.open(image_path).convert("RGB")

# 3. 深度マップの推論実行(1回のフォワードパスでミリ秒単位で完了)
depth_output = depth_estimator(raw_image)
depth_map = depth_output["depth"]

# 4. 深度マップを画像として保存
# 手前にある物体ほど明るく(白く)、奥にある物体ほど暗く(黒く)可視化される
depth_map.save("workspace_depth_map.png")
print("=== [推論完了] 3次元深度マップを workspace_depth_map.png として保存しました ===")
実務で触るべきオープンソース空間知覚エコシステム比較
VGIの世界に足を踏み入れたいエンジニアが、まず手元で試すべき代表的なオープンソースライブラリを整理しました。目的に応じて使い分けるのが最短の近道です。
| ライブラリ / モデル | 主な得意領域 | 特徴・実務での活用メリット |
|---|---|---|
| Depth Anything v2 | 単眼深度推定(Z軸距離) | 超軽量(Small〜Large)。スマホ写真からでもミリ秒単位で精緻な深度マップを生成可能。 |
| SAM 2 (Segment Anything 2) | 動画・静止画セグメンテーション | Meta公開。点やボックスの指定だけで、動画内の特定物体をリアルタイム追跡・切り抜き。 |
| 3D Gaussian Splatting (3DGS) | リアルタイム3D空間再構成 | 従来のNeRFより圧倒的に高速。複数枚の写真からフォトリアルな3Dシーンを爆速レンダリング。 |
| PyTorch3D | 3Dメッシュ・点群幾何演算 | Meta開発。ディープラーニングと3Dレンダリング・微分可能パイプラインの結合に最適。 |
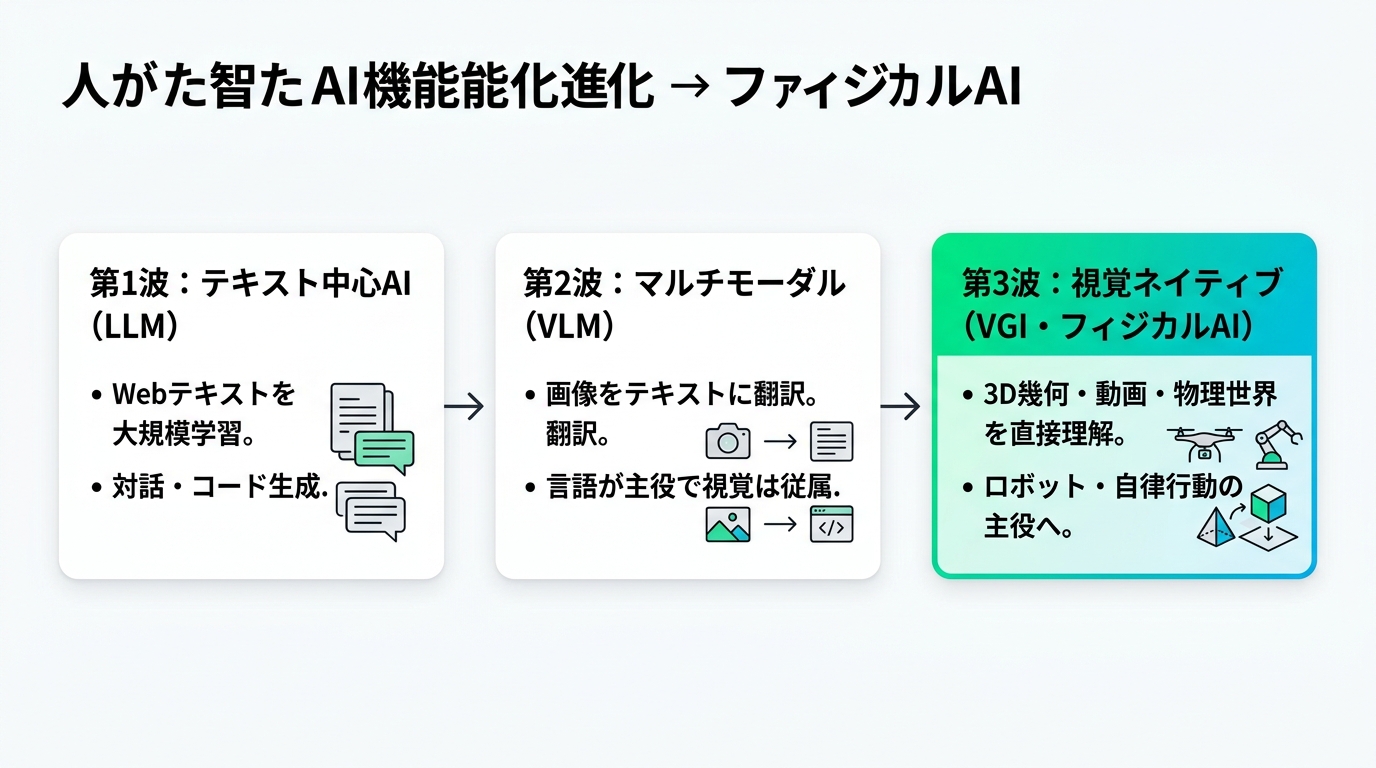
エンジニア視点での示唆:LLMブームの次に来る「フィジカルAI」の波
「言語のオマケとしての画像」から「視覚ネイティブな知能」への逆転
これまでのマルチモーダルAI(GPT-4Vなど)は、基本的に「LLMという巨大なテキスト脳があり、そこに視覚エンコーダー(CLIP等)を後付けして、画像を無理やりテキストトークンに翻訳して流し込む」という主従関係でした。主役はあくまで言語だったのです。
しかしVGIが提唱するのは、この主従関係の完全な逆転です。「物理世界を捉える視覚・空間知覚こそが知能のOS(基本基盤)であり、言語はその上に乗るコミュニケーション用インターフェースに過ぎない」という考え方ですね。3D幾何や動画予測をポリシーの土台にする動きは、まさにこのパラダイムシフトの先駆けと言えます。
実世界応用を見据えたエンジニアの生存戦略
今後、自動運転、人型ロボット、ドローン、スマートグラス(空間コンピューティング)、工場の自動化などを手がけるエンジニアにとって、「プロンプトエンジニアリング」や「テキストRAG」のスキルだけでは差別化が難しくなっていくでしょう。
これからは、「3D点群やデプスマップの扱い」「動画生成モデルを用いた物理シミュレーション」「ロボットアームやエッジデバイスでの超低遅延推論アーキテクチャ」といった、実世界の空間・物理に根ざしたエンジニアリング能力が圧倒的な強みになっていくはずです。AIの評価方法については、以前まとめたLLMの評価指標・ベンチマーク完全総覧やBLEUとROUGEの違いと計算方法もあわせて参照してみてください。
よくある質問(FAQ)
Q1: 従来のVLM(GPT-4o等)とVGI(視覚汎用知能)の根本的な違いは何ですか?
A: 従来のVLMは「言語モデルの頭脳に視覚を外付けし、画像をテキストとして解釈するモデル」です。一方、VGIは「視覚・3D空間そのものを知能の基本OSとし、世界の物理法則や幾何学的因果を直接モデル化する知能」を目指しています。主従関係が完全に逆転している点が最大の違いです。
Q2: 深度推定モデル(Depth Anything v2等)を動かすには高価なGPUが必須ですか?
A: CPUだけでも快適に動作します。特に「Small」モデル(約2,500万パラメータ)であれば、一般的なノートPCのCPUでも1枚あたり数十ミリ秒〜数百ミリ秒で深度マップを出力できます。動画のリアルタイム処理を行う場合でも、RTX 3060クラスのミドルレンジGPUがあれば60FPS以上で推論可能です。
Q3: ソフトウェアエンジニアがフィジカルAIを学ぶなら何から始めるべきですか?
A: まずは本記事で紹介した「Depth Anything v2」で深度マップの出力を体験し、次にMetaの「SAM 2」で動画内の物体追跡を試すのがおすすめです。どちらもHugging Faceから数行のPythonコードで動かせるため、3D空間知覚の直感を養う最初のステップとして最適です。
まとめ
今回は、世界のトップ研究者21名が提示した注目のホワイトペーパー「Visual General Intelligence(VGI: 視覚汎用知能)」の内容と、それが示唆する未来のAIアーキテクチャ、そしてPythonによるハンズオン検証までを解説しました。要点を振り返ってみましょう。
- 言語の壁: テキストは人間が圧縮した記号に過ぎず、3D幾何や物理法則が欠落しているため、LLMのスケールアップだけでは物理世界理解(AGI)に到達できない。
- 幾何学的接地(Geometric Grounding): テキストLLMが錯視や重なり順序で誤答するのに対し、空間モデルはピクセルごとの深度を直接捉えることで正確な物理理解を可能にする。
- VGIの3大オペレーション: 「連続的予測(Next-Frame)」「開放的生成(反実仮想シミュレーション)」「空間再構成(3D復元)」が知能の核となる。
- フィジカルAIへの大転換: 画像が言語のオマケだった時代は終わり、空間知覚を土台にした「視覚ネイティブな知能」へとエンジニアの主戦場がシフトする。
「言葉を覚える前に、まず世界を目で見つめ、手で触れて理解する」。人間の成長と同じプロセスをAIにも辿らせようというVGIのアプローチは、どこか原点回帰のようでありながら、極めて本質的でワクワクさせられますよね。手元にPython環境がある方は、ぜひDepth Anything v2のコードをコピペして、手元の写真から3次元空間が浮き上がる体験を味わってみてください!
💡 あわせて読みたい