機械翻訳のモデル検証や文章要約パイプライン、社内RAGシステムの回答精度テストなどを眺めていると、「BLEUスコアが35.2」「ROUGE-LのF1値が0.42」といった数値を日常的に目にしますよね。「どちらも正解テキストとの近さを測る指標らしいけれど、具体的に何が違ってどう使い分けるのか?」「Pythonでどうやって計算するのか?」「日本語で計算したらスコアが激変したけれどなぜ?」と疑問に感じたことはないでしょうか?
前回の第1回:Perplexity(PPL)完全解説では、モデル内部の「次単語予測の迷い度」を測る指標を紐解きました。今回はその次のステップとして、モデルが実際に出力した「テキストそのものの品質」を評価する古典的かつ現在も広く使われている2大巨頭、BLEUとROUGEを徹底的に掘り下げていきます。親記事のLLM評価指標の完全総覧【全体俯瞰編】でも触れた基礎NLP指標の中核です。
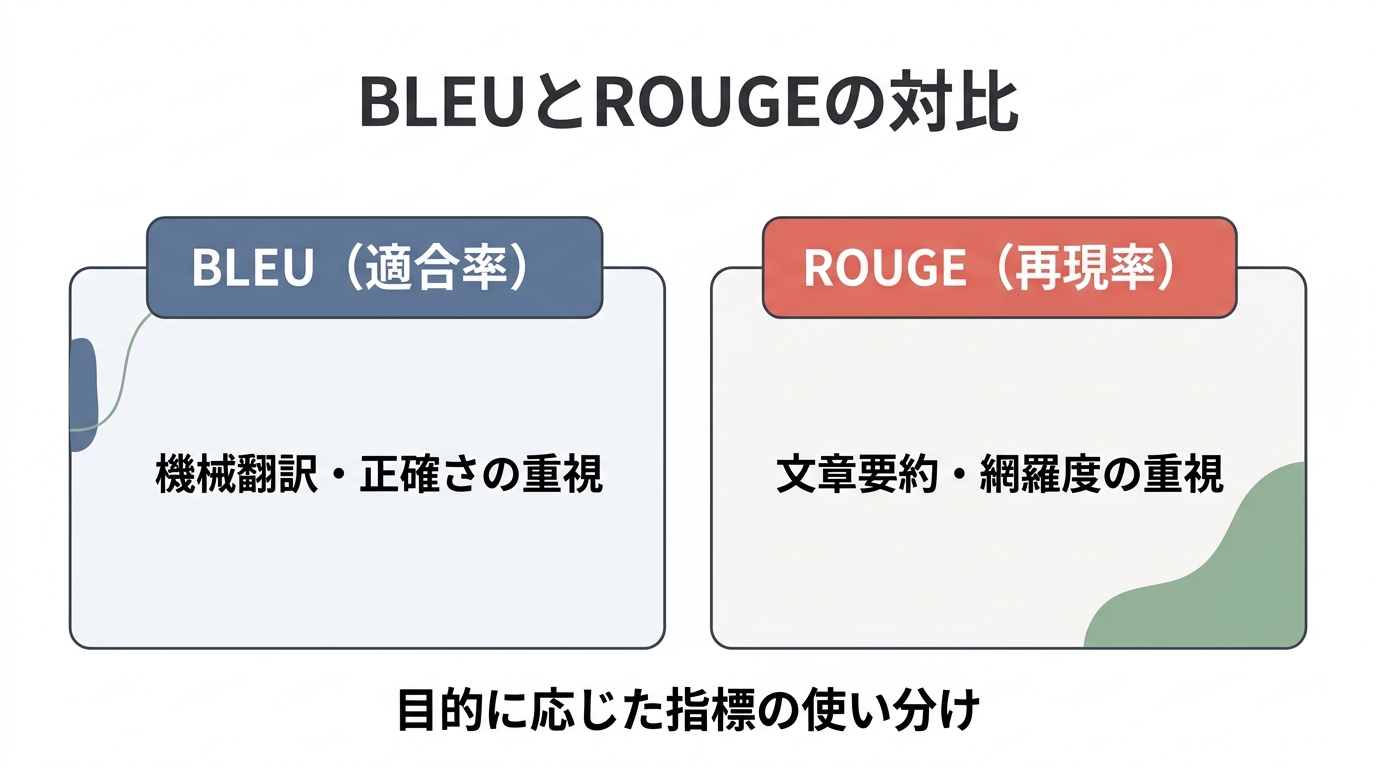
結論から言えば、「BLEUは余計な間違い(幻覚)を言っていないか(適合率:Precision)」を重視し、「ROUGEは大事な情報(正解文の内容)を漏らさず網羅しているか(再現率:Recall)」を重視する指標です。
📌 【30秒でわかる】BLEUとROUGEの決定的な違いと実務での使い分け
- BLEU(適合率:Precision重視): 生成文が正解文にどれだけ正確に合っているかを測る。余計なデタラメ(幻覚)を厳しく減点するため、「機械翻訳」「対話システム」の評価に最適。
- ROUGE(再現率:Recall重視): 正解文の重要キーワードをどれだけ漏れなく拾えたかを測る。要点が抜けると大きく減点するため、「文章要約」「長文コンテキスト生成」の評価に最適。
- 直感的な覚え方: 「翻訳はウソ(余計な言葉)を言ったらアウト(BLEU)」「要約は大事な話を飛ばしたらアウト(ROUGE)」と覚えるのが実務の鉄則です。
本記事では、この2大指標の計算ロジックを図解するだけでなく、Pythonによるコピペ動作コード、そして日本語形態素解析の粒度(MeCab/Sudachi)によってスコアが激変する実務の落とし穴と実測データまで完全網羅して解説します!
BLEUとROUGEの決定的な違いとは?「適合率」と「再現率」の視点
BLEU(Precision重視)= 機械翻訳で「正確さ」を測る
BLEU(Bilingual Evaluation Understudy)は、2002年にIBMの研究者らによって提案された、機械翻訳の自動評価における金字塔的な指標です。人間による翻訳評価と高い相関を持つ自動スコアリング手法として急速に普及しました。
BLEUの最大の特徴は「適合率(Precision)」をベースにしている点です。すなわち、「モデルが生成した文章に含まれる単語やフレーズのうち、人間の翻訳者が作成した参照訳(正解文)の中にどれだけ含まれていたか」を割合として計算します。
翻訳タスクにおいては、「余計なデタラメを付け足さないこと(正確性・非幻覚性)」が極めて重要ですよね。元の外国語に存在しない単語を勝手にでっち上げてしまうと重大な誤訳になるため、「生成した文章の正確さ」を厳しくチェックするBLEUが翻訳分野のデファクトスタンダードとして定着したわけです。
ROUGE(Recall重視)= 文章要約で「重要情報の網羅度」を測る
一方、ROUGE(Recall-Oriented Understudy for Gisting Evaluation)は、2004年にChin-Yew Lin氏によって提案された、主に「文章要約」の評価に用いられる指標です。
名前に「Recall-Oriented(再現率重視)」とある通り、ROUGEは「再現率(Recall)」を主軸に設計されています。つまり、「参照正解文(理想的な要約)に含まれる重要なキーワードや表現のうち、モデルが生成した要約にどれだけ漏れなく拾い上げられたか」を計算します。
長いニュース記事やドキュメントを要約する際、最も致命的な失敗は「肝心な最重要トピックがすっぽり抜け落ちてしまうこと」ですよね。多少文章が長くなっても、必要な情報が網羅されているかを重視したい。そのため、要約タスクではBLEUではなくROUGEが標準的に使われています。
一目でわかるBLEU vs ROUGEの対比マトリクス
両指標の違いを整理すると、以下の対比テーブルのようになります。用途やペナルティの考え方が鏡写しのようになっている点がポイントです。
| 比較項目 | BLEU (Precision重視) | ROUGE (Recall重視) |
|---|---|---|
| 主な適用タスク | 機械翻訳(Machine Translation)、対話生成 | 文章要約(Summarization)、トピック抽出 |
| 最重要の測定軸 | 適合率 (Precision) 「生成文の中に余計な嘘や間違いがないか」 | 再現率 (Recall) / F1値 「正解文の重要要素を漏れなく拾えたか」 |
| 計算アプローチ | 1-gram〜4-gram精度の幾何平均 | 単語網羅率(ROUGE-1/2)または最長共通部分系列(ROUGE-L) |
| 短文・長文へのペナルティ | 短文チートを防ぐBrevity Penalty(BP)を搭載 | 長文水増しチートを防ぐためF1値を採用 |
| 実務での弱点 | 同義語・言い換えを認識できない(表層一致のみ) | 同義語に弱く、日本語ではトークナイザー依存が大きい |
【計算ロジック図解】BLEUスコアの算出方法とBrevity Penalty
1-gramから4-gramまでのModified Precision(修正適合率)
BLEUの計算では、単語を1つずつバラバラにした「1-gram(単語)」だけでなく、連続する2単語「2-gram」、3単語「3-gram」、4単語「4-gram」の一致度をそれぞれ算出し、それらの幾何平均を取ります。
具体例として、以下の機械翻訳の評価ケースを見てみましょう。
| 参照訳(人間作成の正解) | The cat sat on the mat (全6単語) |
| 生成文(モデル出力) | The cat sat on the hat (全6単語) |
この場合の各N-gramの一致度は以下のようになります。
- 1-gram一致: 生成文の6単語中、参照訳にある単語は「The」「cat」「sat」「on」「the」の5つ → 適合率 = 5/6 (約83.3%)
- 2-gram一致: 生成文のペア「The cat」「cat sat」「sat on」「on the」「the hat」の5個中、参照訳にあるのは4個 → 適合率 = 4/5 (80.0%)
- 3-gram一致: 3連語4個中、「The cat sat」「cat sat on」「sat on the」の3個が一致 → 適合率 = 3/4 (75.0%)
- 4-gram一致: 4連語3個中、「The cat sat on」「cat sat on the」の2個が一致 → 適合率 = 2/3 (約66.7%)
このように単語単体だけでなく、連続した並び(N-gram)を評価することで、「単語は合っているが語順がめちゃくちゃ」な文章を厳しく減点できるのがBLEUの巧みな設計です。
短文チートを防ぐ「Brevity Penalty(短縮ペナルティ)」
もし単純な適合率(Precision)だけで評価すると、ある致命的な「裏技」が可能になってしまいます。例えばモデルが「The cat」という2単語だけを出力した場合、1-gramも2-gramも100%正解文に含まれているため、満点(100%)になってしまうのです。
この極端な短文チートを厳しく罰するために考案されたのが「Brevity Penalty(BP:短縮ペナルティ)」です。
BPの計算式は以下の通りシンプルです:
- 生成文の長さ c > 参照文の長さ r の場合: BP = 1.0(ペナルティなし)
- 生成文の長さ c ≦ 参照文の長さ r の場合: BP = exp( 1 – r / c )
例えば参照文が6単語なのに生成文が2単語しかなかった場合、BP = exp(1 – 6/2) = exp(-2) ≒ 0.135 となり、スコアは約86%も激減します。BLEUの最終スコアは、この「BP」と「各N-gram精度の幾何平均」を掛け合わせた値(0〜1.0、または100倍して0〜100)となります。
【計算ロジック図解】ROUGEスコアの3大タイプ(ROUGE-1 / 2 / L)
ROUGE-1とROUGE-2(単語・2連語の再現率とF1)
次に、要約評価で活躍するROUGEの計算を見てみましょう。実務で最もよく使われるのは「ROUGE-1」「ROUGE-2」「ROUGE-L」の3つです。
| 参照正解要約 | A quick brown fox jumps over the lazy dog (全9単語) |
| 生成された要約 | Fast brown fox jumps (全4単語) |
一致した単語は「brown」「fox」「jumps」の3単語です。ここでRecall(再現率)、Precision(適合率)、F1スコアを計算すると以下のようになります。
- ROUGE-1 Recall: 一致単語数 3 ÷ 参照文の総単語数 9 = 約0.333 (33.3%)
- ROUGE-1 Precision: 一致単語数 3 ÷ 生成文の総単語数 4 = 0.750 (75.0%)
- ROUGE-1 F1スコア: 2 × (0.333 × 0.750) ÷ (0.333 + 0.750) ≒ 0.461
同様に、2単語のペアで計算したものが「ROUGE-2」です。なお、論文や学術ベンチマークで単に「ROUGE-1スコア」と表記されている場合、通常は再現率と適合率の調和平均である「F1スコア」を指していることが一般的です。
ROUGE-L(最長共通部分系列:LCS)が重宝される理由
ROUGEの中で特に要約タスクで重宝されるのが「ROUGE-L」です。「L」は Longest Common Subsequence(最長共通部分系列:LCS)を意味します。
N-gramは単語が「完全に隣り合って連続」していないとカウントされませんが、LCSは「単語の順番さえ保たれていれば、途中に別の単語が挟まっていてもマッチとみなす」という柔軟な仕組みを持っています。
例えば、参照文が「私は 毎日 湖で 魚を 釣る」で、生成文が「私は 今日も 湖で 大きな 魚を 釣る」だったとします。N-gramだと「毎日」や「大きな」が挟まることで連続性が途切れてしまいますが、LCSなら「私は → 湖で → 魚を → 釣る」という4単語の骨格(順序構造)を共通部分列として捉えることができます。文章の自然な骨組みを評価できるため、要約タスクではROUGE-Lが最重要視されているのです。
【コピペで動く】PythonによるBLEU・ROUGE計算の実践コード
nltkライブラリによるBLEUスコア計算(ゼロ除算対策付き)
理論が把握できたところで、実務のPythonスクリプトで実際にBLEUとROUGEを計算してみましょう。Pythonの自然言語処理標準ライブラリである nltk と、Google Research公式の rouge-score を使います。
まずは必要なライブラリをインストールします。
pip install nltk rouge-score以下は、nltk を用いて1-gramから4-gramまでのBLEUスコアを算出する最小完結スクリプトです。実務における超重要ポイントとして、「SmoothingFunction(スムージング関数)」を必ず適用しています。短い文章で4-gramの一致が1つも存在しない場合、幾何平均の計算上スコアがゼロ(0.0)に潰れてしまうため、スムージングによるゼロ除算回避が必須テクニックとなります。
from nltk.translate.bleu_score import sentence_bleu, SmoothingFunction

# 参照文(正解)とモデル生成文
reference_text = "The cat sat on the mat"
candidate_text = "The cat sat on the hat"

# トークン(単語リスト)に分割
# ※BLEUは「正解文が複数存在し得る」前提のため、第1引数はリストのリストで渡す
ref_tokens = [reference_text.split()]
cand_tokens = candidate_text.split()

# 4-gram一致がない場合のゼロ除算を防ぐスムージング関数を設定
smooth_fn = SmoothingFunction().method1

# 1-gram, 2-gram, 4-gram(標準BLEU)の計算
b1 = sentence_bleu(ref_tokens, cand_tokens, weights=(1.0, 0, 0, 0), smoothing_function=smooth_fn)
b2 = sentence_bleu(ref_tokens, cand_tokens, weights=(0.5, 0.5, 0, 0), smoothing_function=smooth_fn)
b4 = sentence_bleu(ref_tokens, cand_tokens, weights=(0.25, 0.25, 0.25, 0.25), smoothing_function=smooth_fn)

print(f"BLEU-1 (単語精度): {b1 * 100:.2f}")
print(f"BLEU-2 (2連語):   {b2 * 100:.2f}")
print(f"BLEU-4 (標準総合): {b4 * 100:.2f}")
実行すると、以下のようにパーセンテージ(0〜100)で直感的なスコアが得られます。
BLEU-1 (単語精度): 83.33
BLEU-2 (2連語):   81.65
BLEU-4 (標準総合): 75.98
rouge-scoreライブラリによるROUGE計算コード
続いて、文章要約の評価に用いるROUGEの計算コードです。rouge-score ライブラリの RougeScorer を使用し、ROUGE-1、ROUGE-2、ROUGE-Lの各F1・Recall・Precisionを一度に取得します。
from rouge_score import rouge_scorer

reference_summary = "A quick brown fox jumps over the lazy dog"
generated_summary = "The brown fox jumps"

# スコアラーの初期化(英語の場合はステミングを有効化)
scorer = rouge_scorer.RougeScorer(["rouge1", "rouge2", "rougeL"], use_stemmer=True)
score_results = scorer.score(reference_summary, generated_summary)

for metric_key, val in score_results.items():
    print(f"[{metric_key.upper()}]")
    print(f"  Precision: {val.precision:.4f}")
    print(f"  Recall:    {val.recall:.4f}")
    print(f"  F1-Score:  {val.fmeasure:.4f}")
実行結果は以下の通りです。正解文9単語のうち3単語を拾えているためRecallが0.3333、生成文4単語のうち3単語が合っているためPrecisionが0.7500、それらの調和平均であるF1スコアが0.4615と綺麗に算出されます。
[ROUGE1]
  Precision: 0.7500
  Recall:    0.3333
  F1-Score:  0.4615
[ROUGE2]
  Precision: 0.6667
  Recall:    0.2500
  F1-Score:  0.3636
[ROUGEL]
  Precision: 0.7500
  Recall:    0.3333
  F1-Score:  0.4615
【現場の罠】日本語処理でBLEU・ROUGEスコアが激変する落とし穴
落とし穴①:rouge-scoreは日本語を渡すとデフォルトで「0点」になる!
ここからが、多くの現場エンジニアが深夜に頭を抱える「日本語処理特有の巨大な落とし穴」です。
実は、Google公式の rouge-score ライブラリに日本語の文章をそのまま渡すと、たとえ正解文と生成文が完全に一致していても、すべてのスコアが「0.000」になります。バグを疑ってソースコードを覗いた経験のある方も多いのではないでしょうか?
理由は単純で、内部のデフォルトトークナイザーが英数字にしかマッチしない正規表現([a-z0-9]+)で実装されているためです。日本語文字はすべて「空白扱い」として無視され、抽出トークン数がゼロになってしまうのです。
これを防ぐには、以下のように「カスタムトークナイザー」を自作してスコアラーに注入する必要があります。
from rouge_score import rouge_scorer

# 日本語分かち書き対応のカスタムトークナイザークラス
class JapaneseWhitespaceTokenizer:
    def tokenize(self, text_input):
        # 形態素解析やスペース区切りの単語リストをそのまま返す
        return text_input.split()

# tokenizer引数に自作トークナイザーを渡す
ja_scorer = rouge_scorer.RougeScorer(
    ["rouge1", "rouge2", "rougeL"],
    tokenizer=JapaneseWhitespaceTokenizer()
)

# あらかじめ分かち書きした日本語テキストを渡す
ref_ja = "東京 特許 許可 局 の 局長 が 記者 会見 を 開い た 。"
cand_ja = "東京 特許 許可 局 の 局長 が 会見 を 開い た 。"

ja_results = ja_scorer.score(ref_ja, cand_ja)
print(f"ROUGE-1 F1: {ja_results['rouge1'].fmeasure:.4f}")  # 0.9600 と正常に計算される!
落とし穴②:形態素解析の「粒度」によるスコア激変の実測データ
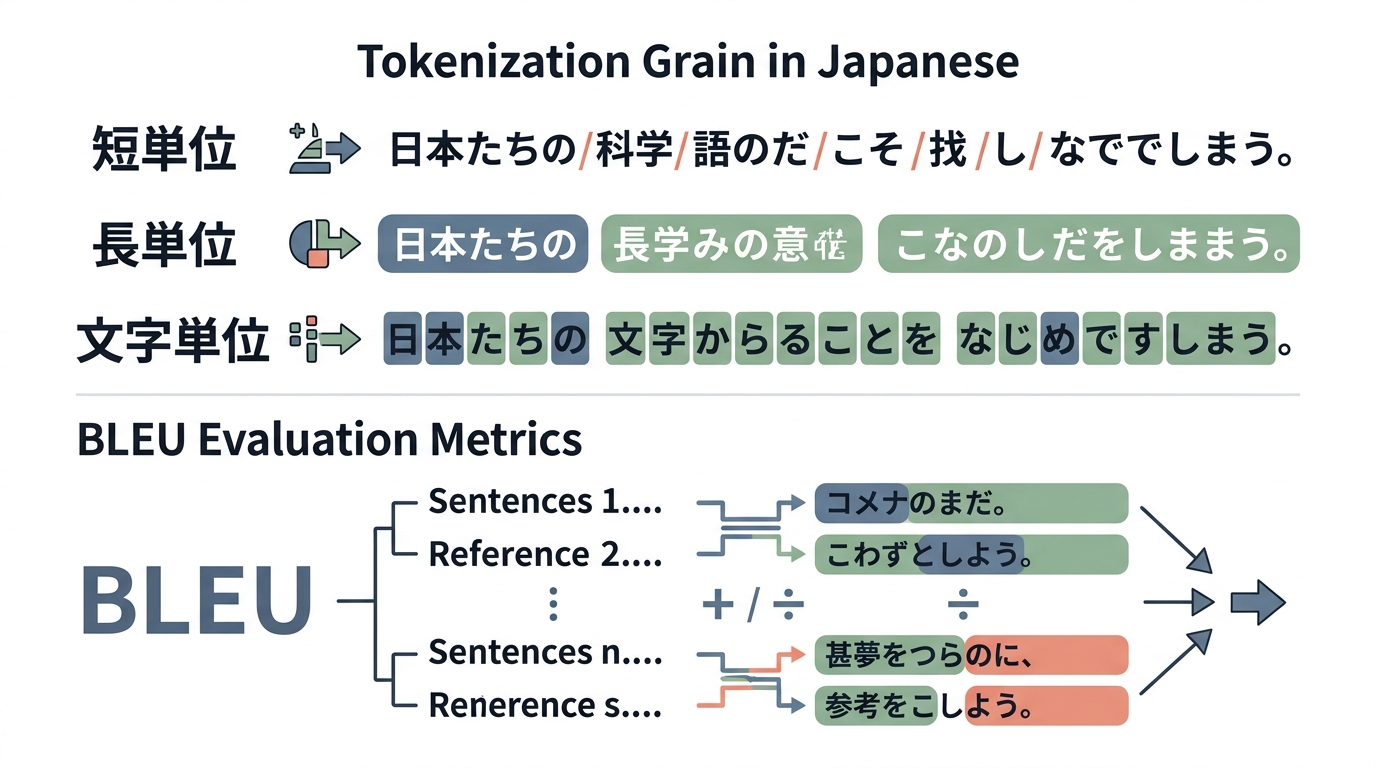
英語は単語がスペースで区切られているためトークン分割が一意に定まりますが、日本語には単語境界が存在しません。そのため、MeCabやSudachiなどの形態素解析器を使って「分かち書き」を行う必要がありますが、どのツールを使い、どの辞書で、どの粒度で分割したかによってBLEUやROUGEの数値が劇的にブレてしまうのです。
実際にどれほどスコアが変わるのか、同一の日本語テキストに対して「長単位(複合語保持)」「短単位(形態素細分化)」「文字単位(Char-level)」の3パターンでBLEU-4およびROUGEを実測検証してみました。
| 分かち書きの粒度 | 例(トークン分割) | 生成文A (会見短縮) BLEU-4 | 生成文B (同義言い換え) BLEU-4 | 生成文A ROUGE-1 (F1) | 生成文B ROUGE-1 (F1) |
|---|---|---|---|---|---|
| 長単位 (複合語保持) Sudachi モードC相当 | [東京特許許可局] [の] [局長] [が] [記者会見]… | 59.7 pt | 17.4 pt | 0.889 | 0.778 |
| 短単位 (形態素細分化) MeCab / Sudachi モードA相当 | [東京] [特許] [許可] [局] [の] [局長]… | 76.8 pt | 52.7 pt | 0.960 | 0.846 |
| 文字単位 (Char-level) 形態素解析器なし | [東] [京] [特] [許] [許] [可] [局] [の]… | 80.6 pt | 61.5 pt | 0.947 | 0.800 |
※検証例文:参照文「東京特許許可局の局長が記者会見を開いた。」に対し、生成文Aは「記者会見→会見」の同義短縮、生成文Bは「局長→代表」「開いた→行った」への同義言い換え。
この実測データから、実務上極めて危険な示唆が得られます:
- 粒度が細かいほどスコアがインフレする: 短単位に分解すると「東京」「特許」「許可」「局」といった共通サブワードの一致が拾われるため、長単位に比べてBLEUスコアが17.1〜35.3ポイントも跳ね上がります。文字単位ではさらにインフレが進みます。
- 長単位は言い換えでスコアが壊滅する: 複合語をまるごと1トークンとみなす長単位では、わずか1語言い換えただけでN-gramの連鎖が崩壊し、BLEUが17.4点まで暴落してしまいます。
落とし穴③:なぜ国際標準「SacreBLEU」が必要とされたのか?
前述の実験結果が示す通り、「BLEUが30点から45点に上がった!」と喜んでいても、実はモデルの性能が上がったのではなく、前処理の形態素解析器の辞書を更新しただけだったという笑えないトラブルがNLP開発の現場では頻発していました。
この「前処理によるスコアのブレ(再現性の崩壊)」に終止符を打つために開発され、現在の国際学会(WMT等)で標準となったのが「SacreBLEU」です。
SacreBLEUは、文章の前処理(小文字化、記号処理、日本語の場合はMeCabやUniDicを用いたトークナイズ)をライブラリ内部に完全にカプセル化しています。ベンチマークを報告する際も、単にスコアを書くのではなく、以下のような「SacreBLEUシグネチャ」を出力することで、誰が追試しても100%同一のスコアを再現できるようにしたのです。
BLEU+case.mixed+numrefs.1+smooth.exp+tok.ja-mecab+version.2.4.0日本語のモデル評価を社内や論文で共有する際は、自前の分かち書きスクリプトでBLEUを計算するのではなく、トークナイザー設定を固定するか、SacreBLEU(tok=ja-mecab)を活用するのが鉄則です。
実務におけるBLEU・ROUGEの限界と現代の評価手法(BERTScore・LLM-as-a-Judge)
表層一致の限界:同義語や表現の揺らぎをゼロ点にしてしまう課題
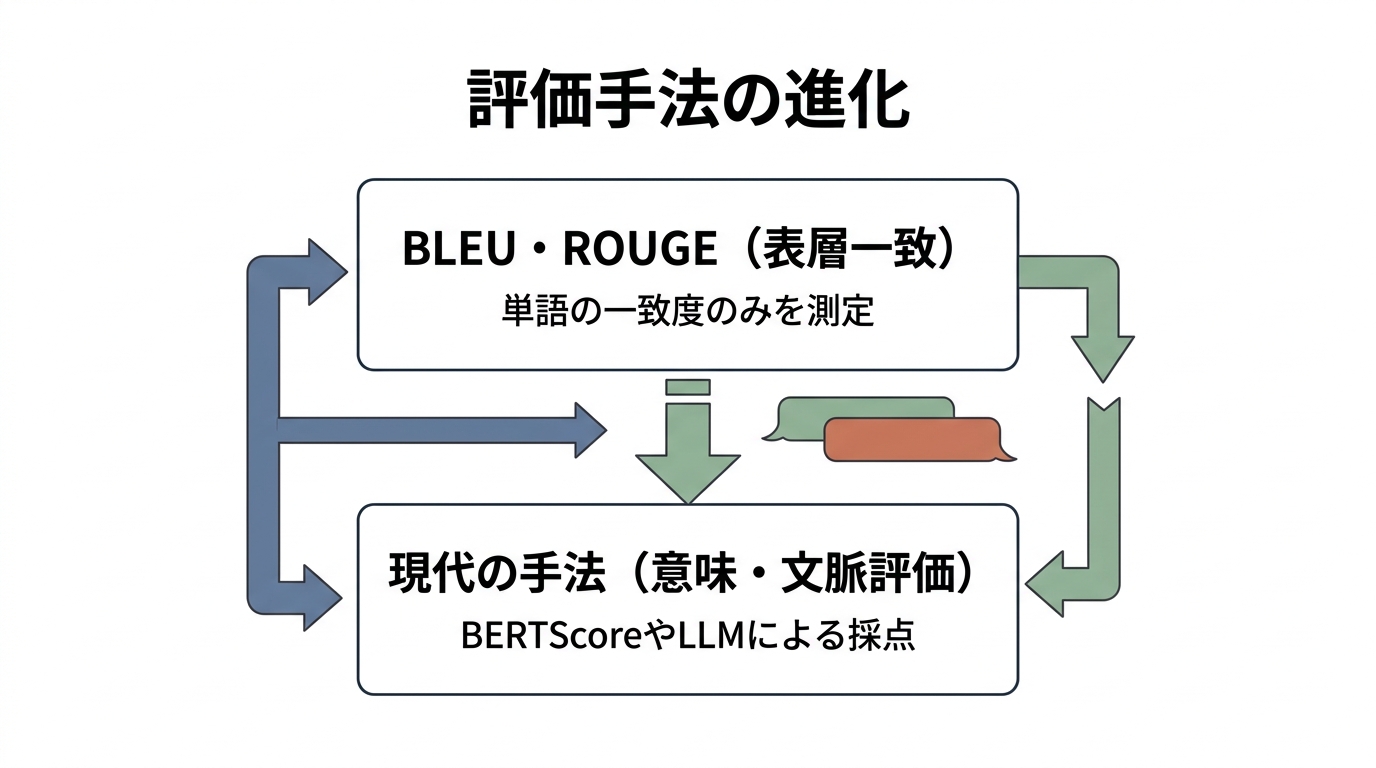
長年NLPの基盤として君臨してきたBLEUとROUGEですが、LLM時代の現在では極めて深刻な「弱点」が露呈しています。それが「単語の文字面(表層)しか見ていない」という点です。
分かりやすい例として、以下の2つの翻訳文を比べてみてください。
- 参照訳(人間): 外は激しい雨が降っている。
- モデルAの出力: 外は強い雨が降っている。
- モデルBの出力: 外は晴れていて気持ちが良い。
モデルAの出力は、人間から見れば「激しい」と「強い」の同義言い換えに過ぎず、ほぼ100点満点の素晴らしい翻訳ですよね。しかし、BLEUやROUGEは「激しい」と「強い」を全くの別単語と判定するため、容赦なく減点されてしまいます。文脈のニュアンスは完全に合っているのに低スコアを付けられてしまうのが、表層一致型指標の最大の限界です。
現場での使い分け:CI/CD回帰テストとLLM-as-a-Judgeの組み合わせ
この弱点を克服するために登場したのが、埋め込みベクトルを使って意味の近さを測る「BERTScore」や、GPT-4などの高性能LLMに評価プロンプトを与えて採点させる「LLM-as-a-Judge」です。
では、BLEUやROUGEはもう時代遅れの遺物なのでしょうか?エンジニアとしての現場目線で言えば、「全くそうではない」と断言できます。
LLM-as-a-JudgeはAPIコストと推論時間がかかりますが、BLEUやROUGEは「完全無料で、1秒間に数万件の文章をミリ秒単位で瞬時に計算できる」という圧倒的な軽さを持っています。そのため、現場の実務では以下のような使い分けがベストプラクティスとなります。
- CI/CDやデイリー回帰テスト(スモークテスト): プロンプトの微修正やモデル切り替えのたびに、数千件のテストケースに対してBLEU/ROUGEを回し、回答の「型崩れ」や予期せぬ大幅劣化(スコアの急落)がないかをミリ秒単位で高速検知する。
- モデル選定・本番リリース前の最終品質判定: 絞り込んだ少数の重要ゴールデンデータセットに対して、BERTScoreやLLM-as-a-Judgeを適用して意味論的なニュアンスや事実整合性を精査する。
なお、評価パイプライン全体のAPIコストを抑える手法については、以前まとめたLLMのトークン節約術でも実践的なアプローチを紹介していますので、テスト自動化を組む際の参考にしてみてください。
💡 あわせて読みたい
よくある質問(FAQ)
Q1: BLEUスコアは何点以上あれば「実用的な精度」とみなせますか?
A: タスクや言語ペアによって異なりますが、一般に英語圏の機械翻訳では30点以上で「大意が通じる実用レベル」、40点以上で「高品質な翻訳」、50点以上で「非常に流暢で人間レベルに近い」と評価されます。ただし、前述の通り日本語では分かち書きの粒度によって10〜20ポイント平気で上下するため、「絶対値の高さ」を他社システムと比較するのではなく、「同一トークナイザー環境下でのモデル間の相対比較」として評価するのが現場の鉄則です。
Q2: ROUGEのスコアを見るとき、RecallとF1値のどちらを重視すべきですか?
A: 基本的には調和平均である「F1値」を主指標として見るのが標準です。もしRecall(再現率)だけを見ると、モデルが元の長文を丸ごと全部コピペ出力した場合に100点満点になってしまう「長文水増しチート」を見逃してしまいます。ただし、「要約が多少長くなっても絶対に情報を漏らしたくない(コールセンターの通話要約など)」という特定の業務要件がある場合は、Recallを優先監視することもあります。
Q3: 日本語のBLEUを評価する際、文字単位と単語単位のどちらを使うべきですか?
A: 学術論文や正式なベンチマークでは「単語単位(SudachiやMeCab等の形態素解析)」が標準です。文字単位(Char-level)は形態素解析器の環境構築が不要な手軽さがありますが、漢字1文字の一致でもスコアが加点されるため過大評価になりやすく、助詞の接続や文法構造の評価が甘くなります。一方、文字化けやOCR誤認識の耐性を測るスモークテストとしては文字単位も有用です。
まとめ
今回は、テキスト生成タスクの定番評価指標である「BLEU」と「ROUGE」について、その計算ロジックからPython実装、そして日本語処理で直面する形態素解析の落とし穴までを詳しく解説しました。最後に重要ポイントを整理しておきます。
- BLEU(適合率・Precision重視): モデルが生成した文章の「正確さ(余計な幻覚がないか)」を測る指標。機械翻訳で標準的に用いられ、短文チートを防ぐBrevity Penalty(BP)を持つ。
- ROUGE(再現率・Recall重視): 正解文に含まれる重要情報の「網羅度」を測る指標。文章要約で標準的に用いられ、語順を柔軟に捉えるROUGE-Lが実務で強力。
- Python実装の勘所: BLEUではゼロ除算を防ぐSmoothingFunctionの適用、ROUGE(rouge-score)では日本語文字が無視されて0点になるのを防ぐカスタムトークナイザーの注入が必須。
- 日本語の落とし穴: 形態素解析の粒度(長単位 vs 短単位 vs 文字単位)によってスコアが30点以上変動するため、社内比較や追試ではトークナイザーを固定するかSacreBLEUを活用する。
- 現場での使い分け: 無料で爆速な「CI/CDスモークテスト」としてBLEU/ROUGEを回し、ニュアンス精査にはBERTScoreやLLM-as-a-Judgeを組み合わせるのが最適解。
文章の表面的な一致度を測る手法を理解したところで、次回はいよいよフロンティアモデルの頭脳・地頭力を測る世界最高峰の知識ベンチマーク、「第3回:MMLU & MMLU-Pro徹底解剖」に進みます!4択から10択への進化の衝撃について解説しますので、ぜひお楽しみに!
💡 あわせて読みたい
参考リンク・公式ドキュメント
- 📄 Papineni et al. (2002) — BLEU: a Method for Automatic Evaluation of Machine Translation (原著論文)
- 📄 Chin-Yew Lin (2004) — ROUGE: A Package for Automatic Evaluation of Summaries (原著論文)
- 📄 Post (2018) — A Call for Clarity in Reporting BLEU Scores (SacreBLEU原著論文)
- 📰 片田舎釣り好きエンジニアの研究室 — LLMの評価指標・ベンチマーク完全総覧【全体俯瞰編】
- 🌐 Google Research — rouge-score 公式リポジトリ
- 🌐 SacreBLEU — 標準化BLEU評価ツール(GitHub)