社内チャットボットやAIエージェントを開発していると、誰もが必ずぶつかる巨大な壁があります。それが「このモデルの受け答え、前のバージョンより本当に良くなったのか?どうやって客観的に評価すればいいんだ…?」という悩みです。
前回の第5回:GPQAとBBHの凄さでは、最先端モデルの知能限界を試す博士レベルの推論ベンチマークを解説しました。しかし、そうした客観テストで満点を取れても、「実際の会話が不自然」「前の文脈をすぐ忘れる」「指示を途中で無視する」といった対話の違和感は測れません。かといって、人間が何百回もチャットして1問ずつ採点するのは、時間もコストもかかりすぎて現実的ではありませんよね。
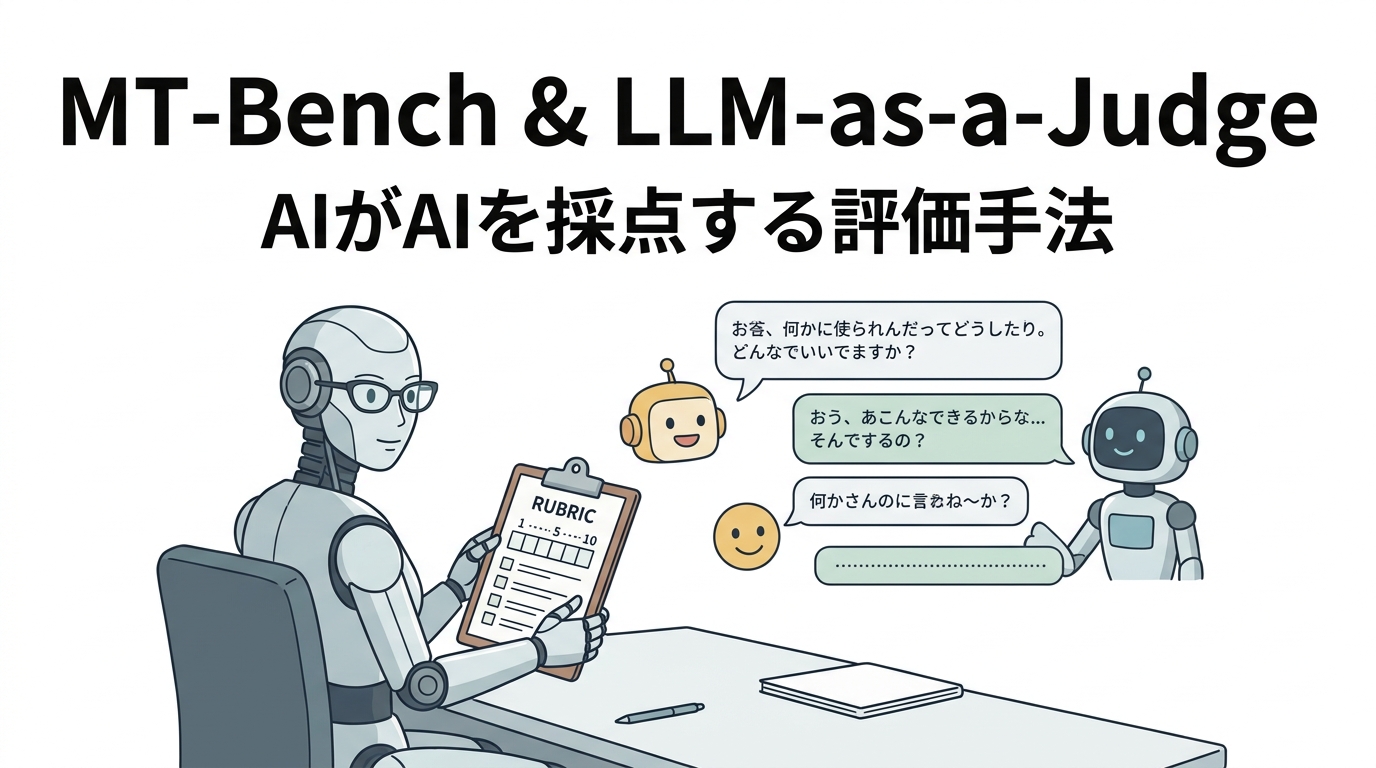
そこで現代のAI開発においてデファクトスタンダード(業界標準)となったのが、LMSYSの研究チームが提唱した「MT-Bench」と「LLM-as-a-Judge(強力なLLM自身を審査員にする手法)」です。親記事のLLM評価指標の完全総覧【全体俯瞰編】でも、対話・主観評価の中核として位置づけた極めて重要な技術です。
結論から言えば、「MT-Benchは2ターンの会話を通じて文脈維持力と指示追従をテストする80問の精鋭ベンチマークであり、LLM-as-a-JudgeはGPT-4などのフロンティアモデルに詳細な採点基準(ルーブリック)を与えて1〜10点で自動採点させる革新的な評価フレームワーク」です。この記事では、AIがAIを公平にジャッジする仕組みと、審査員AIが陥る「3大バイアス」を克服する現場の知恵を徹底解説します!
MT-Benchとは?なぜ「2ターン(多段階対話)」の評価が必要なのか
1問1答(シングルターン)では見抜けない「文脈の喪失」
従来の対話ベンチマークの多くは、「1つの質問に対して1つの回答を返す(シングルターン)」というシンプルな形式で測定されていました。
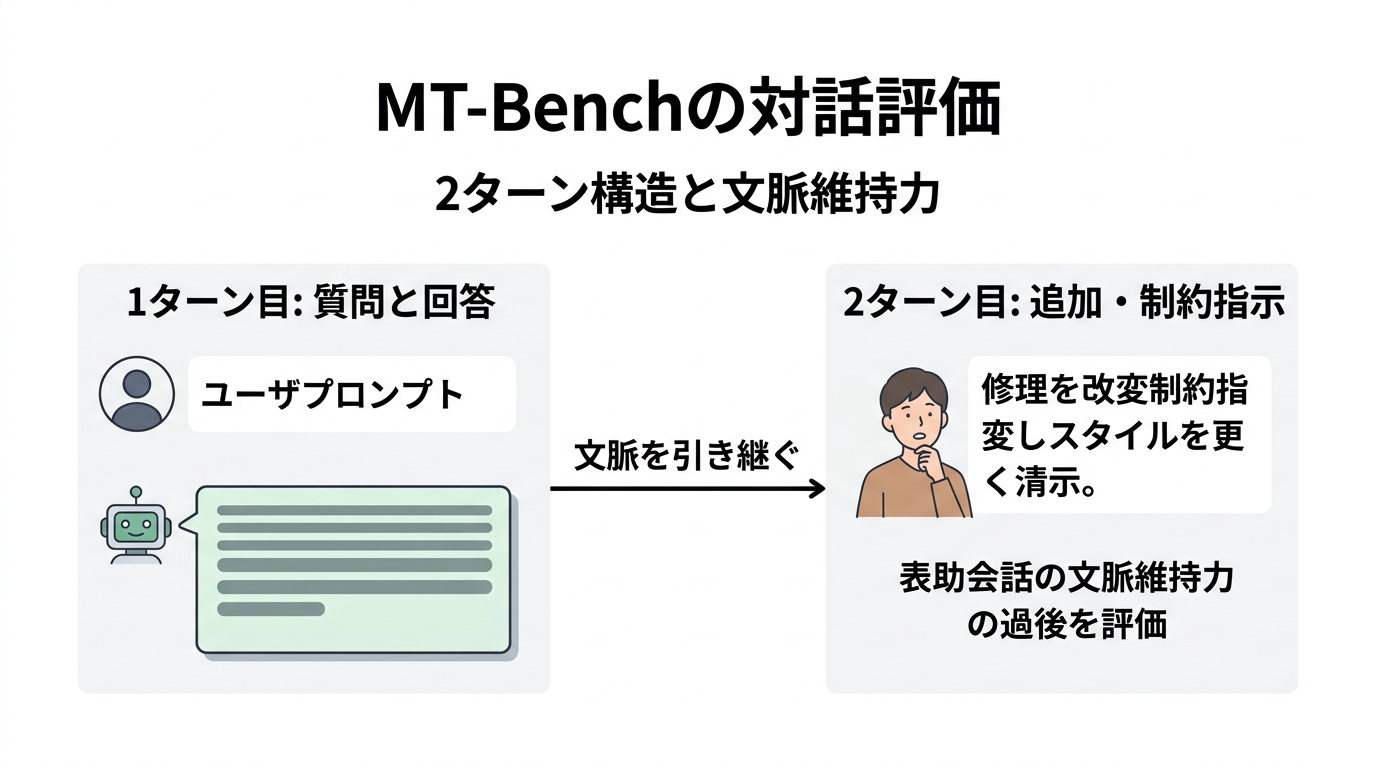
しかし、実際の業務でChatGPTやClaudeを使う場面を思い出してみてください。最初の回答に対して「もう少し予算を抑えたプランにして」「今のPythonコードをTypeScriptに書き直して」「さっきの2番目の案を詳しく教えて」といったように、過去の発言を前提とした追加指示(マルチターン対話)を行うのが当たり前ですよね。
モデルの実力差が最も顕著に現れるのは、まさにこの「2ターン目以降」です。1ターン目では完璧な回答ができていたモデルでも、2ターン目になると突然前の条件を忘れてしまったり、矛盾した提案をしてしまったりするケースが後を絶ちません。
厳選された全8カテゴリ・80問の出題構成
この「多段階の対話力」を短時間かつ高精度に測定するために設計されたのがMT-Bench(Multi-Turn Benchmark)です。チャットボットが直面する主要な利用シーンを網羅した全8カテゴリ、各10問(合計80問・160ターン)で構成されています。
| カテゴリ | 1ターン目の要求 | 2ターン目の展開(文脈負荷) |
|---|---|---|
| Writing(文章作成) | 新製品のプレスリリースを作成する | 「トーンをユーモラスに変え、若者向けSNS投稿用に要約して」 |
| Roleplay(役割演技) | 気難しい歴史上の人物になりきって会話する | 特定の時代背景に反する質問を投げかけ、キャラを保てるか検証 |
| Extraction(情報抽出) | 長文の決算短信から主要な業績数値を抜き出す | 「抽出したデータをJSON形式に変換し、前年比の増減率を計算して」 |
| Reasoning(論理推論) | 複雑な論理パズルを解かせる | 新たな前提条件(制約の追加)を与え、矛盾なく推論を再構築できるか |
| Math(算数・数学) | 確率や図形の文章題を解かせる | 計算過程で使った変数の値を変更し、再計算させる |
| Coding(プログラミング) | 特定のアルゴリズムを満たす関数を実装する | 「時間計算量をO(N)に改善し、単体テストケースを3つ追加して」 |
| STEM(科学技術) | 物理現象のメカニズムを解説させる | 「中学生でも分かるように身近な例え話を使って説明し直して」 |
| Humanities(人文学) | 哲学的な対立命題について論じさせる | 反対側の立場に立って反論を構成させ、論点の中立性を検証 |
このように、2ターン目には必ず「制約の追加」「前提の修正」「トーンの変換」といった負荷が仕掛けられており、モデルの臨機応変な実用適応力が丸裸にされます。
【採点の核心】LLM-as-a-Judgeの仕組みとプロンプト設計
AIが審査員を務める3つの評価モード
80問・160ターンの対話を、人間ではなく「GPT-4などの高性能LLMをジャッジ(審査員)に据えて自動採点する」のがLLM-as-a-Judgeの真骨頂です。主に以下の3つの方式が使い分けられます。
- 1. Single Answer Grading(絶対評価): 1つの回答に対し、指示の達成度や回答の質を「1点〜10点」の絶対スコアで採点させる(MT-Benchの標準方式)。
- 2. Pairwise Comparison(相対評価): モデルAの回答とモデルBの回答を並べて提示し、「どちらが優れているか(Win / Tie / Loss)」を判定させる。
- 3. Reference-guided Grading(模範解答付き評価): 数学やコーディングのように客観的な正解がある問題において、人間の専門家が作成した模範解答を参照させながら採点させる。
人間評価との一致率は80%超え!実用性を支えるルーブリック
「本当にAIの採点なんて信用できるの?」と疑問に思うかもしれません。しかし原著論文(Zheng et al., 2023)の厳密な実験によれば、GPT-4をジャッジにした場合の採点結果は、人間の専門家評価同士の一致率(約81%)とほぼ同等の80%以上の一致率を達成しています。
この高い信頼性を担保しているのが、審査員プロンプト内に埋め込まれた「厳格なルーブリック(評価基準書)」です。実際にLMSYSが使用している評価プロンプトのエッセンスを見てみましょう。
【LLM-as-a-Judgeの採点プロンプト例(日本語要約版)】
[指示]
あなたは公平で偏りのない厳格な審査員です。
以下のユーザーの質問に対するAIアシスタントの回答を評価してください。

評価基準:
- 正確性: 事実に誤りやハルシネーションがないか
- 指示追従: ユーザーが求めたフォーマットや制約を完全に守っているか
- 有用性: 具体的で実践的な解決策を提供しているか
- 明瞭さ: 構成が整理され、論理的で読みやすいか

手順:
1. まず、回答の長所と短所を簡潔に分析・フィードバックしてください。
2. 次に、1点から10点までの整数で総合スコアをつけてください。
   (1-2: 完全に不適切、5-6: 平凡・一部不備あり、9-10: 完璧で極めて有用)
3. 出力フォーマットは最後に「[[スコア]]」の形式で記述してください。
このように、「採点理由(思考ステップ)を先に言語化させてから点数を出させる」設計にすることで、ハルシネーションを防ぎ、採点のブレを最小限に抑えています。
💡 あわせて読みたい
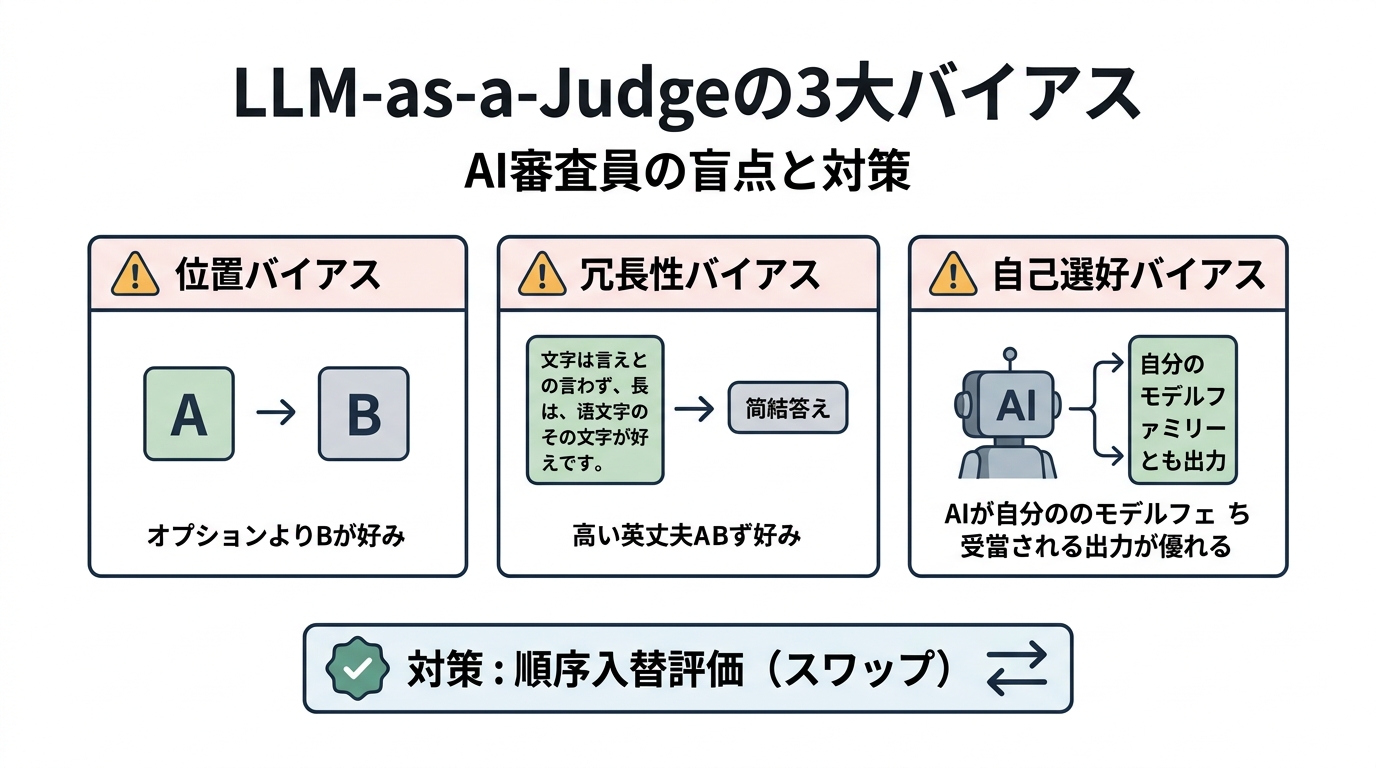
AI審査員の弱点!見落とすと危険な「3大バイアス」と克服法
1. 位置バイアス(Position Bias)
2つのモデルの回答を比較(Pairwise)させる際、AI審査員は「先に提示された回答(モデルA)を過剰に好む」という強力な心理的傾向(位置バイアス)を持っています。同じ内容であっても、提示順をA→BにするかB→Aにするかで勝敗が覆ることが頻繁に起こるのです。
2. 冗長性バイアス(Verbosity Bias)
審査員AIは、「文字数が多く、箇条書きで綺麗に装飾された長い回答」を無意識に高評価してしまいます。たとえ中身が薄い水増し文章であっても、簡潔で本質を突いた短い回答より高いスコアをつけてしまう致命的な盲点です。
3. 自己選好バイアス(Self-enhancement Bias)
GPT-4を審査員にすると「GPTファミリーの回答」を好み、Claudeを審査員にすると「Claudeファミリーの回答」を高く評価してしまう現象です。モデル固有の敬語遣いや接続詞の癖、構成の好みがスコアに偏りをもたらします。
【克服テクニック】順序入替(スワップ)による数学的相殺
実務でこれらのバイアスを排除するための最も強力な手法が「順序入替評価(Position Swapping)」です。
【順序スワップによる勝敗決定ロジック】
- 第1試行: [モデルA, モデルB]の順で審査員に入力 → 判定結果 R1 を取得
- 第2試行: [モデルB, モデルA]の順に入力を反転させて審査員に入力 → 判定結果 R2 を取得
- 統合判定:
- R1でAが勝ち、かつR2でもAが勝った場合のみ → 「モデルAの完全勝利」
- R1でBが勝ち、かつR2でもBが勝った場合のみ → 「モデルBの完全勝利」
- 提示順によって勝者が入れ替わった場合(位置バイアスの発生) → 「引き分け(Tie)」として処理
この二重判定ルールを適用するだけで、位置バイアスによるノイズの大部分を完全に無効化することができます。
実務での活用法!自社チャットボットのCI/CDに組み込む方法
人手評価(1件数百円)vs LLM自動評価(1件数円)の圧倒的差
実務現場において、LLM-as-a-Judgeの最大のメリットは「圧倒的なコスト効率と自動化」です。
人間のテスターを雇って100件の対話ログをレビューさせると、数万円のコストと数日の納期がかかります。しかし、GPT-4oやClaude 3.5 Sonnet、あるいは安価なGPT-4o miniを審査員に据えれば、わずか数十円〜数百円のAPI費用と数分間のバッチ処理で全件の採点が完了します。
プロンプト改修やモデル乗り換え時の「回帰テスト」として使う
エンジニアとして最もおすすめの実装パターンは、プロンプトのバージョンアップやモデル切り替え時の「CI/CD回帰テスト」です。
自社の過去の問い合わせテストケース(30〜50問)を用意しておき、プロンプトを改修した際にGitHub Actions等で自動実行します。新旧プロンプトの生成結果をLLM-as-a-Judgeで自動比較し、「以前のバージョンよりスコアが下がったケース(デグレード)」を即座に検知するパイプラインを組むことで、安心して本番リリースを行えるようになります。
まとめ
今回は、対話品質を測るベンチマークの最高峰「MT-Bench」と、自動採点を支える「LLM-as-a-Judge」のアーキテクチャ、そしてバイアス対策までを詳しく解説しました。要点を整理してみましょう。
- MT-Bench: 8カテゴリ・80問の2ターン対話で構成され、1問1答では分からない「文脈維持力」「制約変更への追従力」を暴く。
- LLM-as-a-Judge: 高性能LLMを審査員にし、詳細なルーブリックプロンプトで1〜10点評価。人間専門家と80%以上の一致率を達成。
- 3大バイアスの罠: 位置バイアス・冗長性バイアス・自己選好バイアスが存在するため、順序入替(スワップ)などの補正設計が必須。
- 実務での最強用途: 人手評価に代わる低コストな「CI/CD自動回帰テスト」として組み込むことで、システム品質のデグレードを瞬時に防止できる。
AIがAIを採点する仕組みを理解したところで、次回はさらにスケールアップし、世界中の人間ユーザーによる数十万件のガチンコブラインド対決を集計する「第7回:LMSYS Chatbot ArenaとEloレーティング!集合知で暴く真のモデルランキング」に進みます!こちらもぜひお楽しみに!
💡 あわせて読みたい
💡 あわせて読みたい