「社内向けにLLMを活用したRAG検索システムをリリースしたけれど、『最初の1文字が出るまで5秒以上待たされて誰も使ってくれない』…」
「高性能なフラグシップモデルをそのまま組み込んだら、毎月のAPI利用料の請求書を見てプロジェクトの継続が危ぶまれた…」
LLM(大規模言語モデル)を活用したWebサービスや社内ツールの本番運用に携わるエンジニアやプロダクト責任者なら、誰もが直面する大きな壁が「レイテンシ(遅延速度)」と「運用コスト(ROI)」です。
本連載では、これまで第1回のMMLUから第12回のTruthfulQA / HaluEvalに至るまで、モデルの「知能・推論力・コーディング力・安全性」を測る品質ベンチマークを解説してきました。親記事のLLM評価指標の完全総覧【全体俯瞰編】でも触れたように、どんなにテストスコアが90点を超える賢いモデルであっても、「レスポンスが遅く、運用コストが合わないモデル」は本番サービスとして成立しません。
全13回シリーズの堂々たる完結編となる今回は、LLM運用の生命線である「TTFT(Time to First Token)」、「TPOT(Time Per Output Token)」、「スループット」、そして「100万トークン単価のROI試算」を徹底解説します!
結論から言うと、「TTFTは入力処理(プリフィル)の速さでユーザーの初期離脱を防ぐ指標、TPOTは生成(デコード)の滑らかさで読書体験を担保する指標であり、この2つを分解測定してタスク別にモデルをルーティングすることこそがコスト削減とユーザー体験両立の鍵」です。
LLMレスポンス遅延の解剖学:TTFTとTPOTは何が違うのか?
推論の2大フェーズ:なぜ「最初の1文字」と「続きの文字」は別物なのか?
一般的なWeb APIであれば、リクエストを送ってからレスポンスが丸ごと返ってくるまでの「往復時間(Latency)」だけを測れば十分でした。しかし、ストリーミング出力が標準である現代のLLMでは、全体の待ち時間を一括りで測定してもボトルネックの所在を特定できません。
LLMのテキスト生成は、計算の性質が根本的に異なる2つのフェーズに分かれています。
1. プリフィル(Prefill)フェーズ:TTFT(Time to First Token)
ユーザーから送られてきたプロンプト(質問文+過去の会話履歴+RAGで取得した参照ドキュメント)の全体を一度にGPUへ読み込み、並列計算してKey/Valueテンソルを計算・キャッシュ(KV Cache)に格納するフェーズです。
- 測定指標: TTFT(Time to First Token / 最初の1文字が出るまでの時間)
- ボトルネック要因: 主に「計算性能(Compute Bound)」。入力プロンプトのトークン数が長くなればなるほど、最初の1文字が返るまでの時間は長くなります。
- ユーザー体験への影響: 「システムがフリーズしたのではないか?」という初期離脱の不安に直結します。目安として1.0秒以内、遅くとも2.0秒以内が許容ラインとされます。
2. デコード(Decode)フェーズ:TPOT(Time Per Output Token)
最初のトークンが出た後、自己回帰的(Autoregressive)に1トークンずつ順番に次の単語を予測・生成していくフェーズです。前の単語が決まらなければ次の単語を計算できないため、並列化できず逐次処理となります。
- 測定指標: TPOT(Time Per Output Token / 1トークンあたりの生成時間)
- ボトルネック要因: 主に「GPUメモリ帯域幅(Memory Bandwidth Bound)」。数十億〜数千億個の巨大なモデル重みをメモリから演算コアへ1トークンごとに毎回転送する必要があるためです。
- ユーザー体験への影響: 流れるような文字送りの滑らかさに直結します。人間が自然に文章を読める速度(約15〜25 tokens/s)を下回ると、「カクカクして遅い」と強いストレスを感じます。
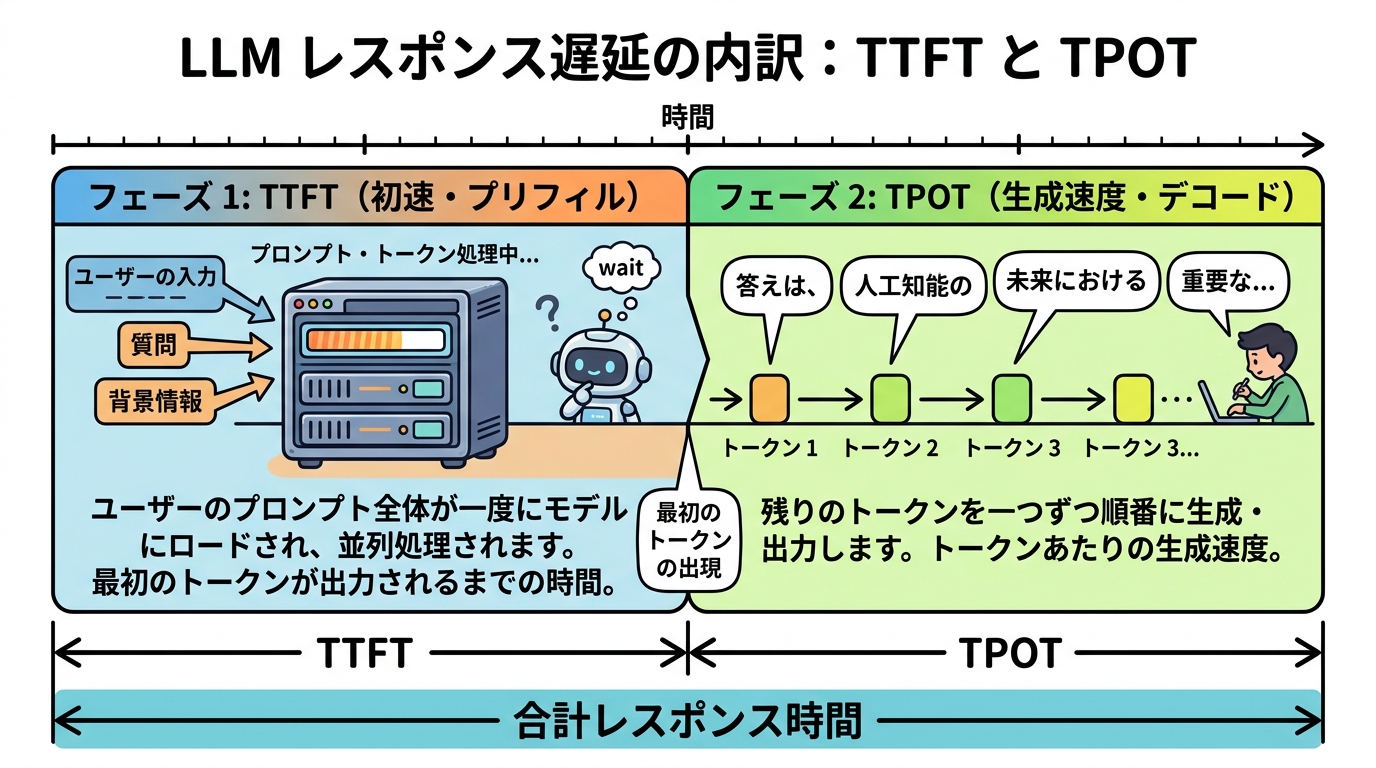
エンドツーエンド遅延の計算式
ユーザーがプロンプトを送信してから、すべての回答の生成が完了するまでの総所要時間(End-to-End Latency)は、以下のシンプルな数式で表されます。
例えば、入力が長くTTFTが2.0秒、出力が300トークンでTPOTが40ミリ秒(25 tokens/s)の場合:
2.0秒 + (300 - 1) × 0.04秒 ≒ 2.0秒 + 11.96秒 = 13.96秒 となります。
もしユーザーがストリーミング表示を見ていれば「2秒で回答が始まり、快適に読める」と感じますが、一括受信(ノンストリーミング)だった場合は「14秒間画面が固まっている」と感じてブラウザを閉じてしまいます。これこそがストリーミングと指標分解が必須である理由です。
現場で使える!ストリーミング遅延(TTFT・TPOT)のPython計測スクリプト
OpenAI互換APIサーバー(OpenAI, Azure, vLLM, Ollama, Groqなど)に対してストリーミングリクエストを送り、TTFT・TPOT・トークン間隔のばらつき(ジッター)を高精度にミリ秒単位で測定する最小Pythonスクリプトを用意しました。
主要モデルの100万トークン単価とスペック比較(2026年最新基準)
システムをスケールさせるにあたって最もシビアに問われるのが「100万トークンあたりの利用料金(1M Token Cost)」です。近年はプロンプトキャッシング(KV Cache再利用)の普及により、入力コストを劇的に抑えられる設計が標準化されています。
| モデル群 | 入力単価 (/100万トークン) |
出力単価 (/100万トークン) |
典型TTFT | 平均TPOT (生成速度) |
最適ユースケース |
|---|---|---|---|---|---|
| フラグシップ商用API GPT-4o, Claude 3.5 Sonnet |
$2.50〜$3.00 (キャッシュ時$0.30〜$1.25) |
$10.00〜$15.00 | 0.6〜1.2秒 | 15〜30ms (35〜65 tok/s) |
複雑な推論、コード生成、最終的な意思決定 |
| 軽量・高速商用API GPT-4o mini, Claude 3.5 Haiku, Gemini 1.5 Flash |
$0.075〜$0.80 | $0.30〜$4.00 | 0.2〜0.5秒 | 7〜15ms (70〜140 tok/s) |
社内QA一次受付、要約、意図分類、高頻度処理 |
| 超高速特化プロバイダ Groq, Cerebras (Llama 3.3 70B等) |
$0.59〜$0.90 | $0.79〜$1.50 | 0.1〜0.3秒 | 3〜5ms (200〜350 tok/s) |
音声対話AI(リアルタイム性必須)、対話Bot |
| セルフホスト(オンプレ/専用GPU) vLLM / TensorRT-LLM (8x H100等) |
インスタンス時間課金 (GPU稼働率100%なら極小) |
キュー滞留状況に依存 | バッチ並列数で可変 | 超大量バッチ処理、機密情報オンプレ保持 | |
【実務シミュレーション】月間10,000回アクセスの社内チャットにおけるROI試算
では、実際に業務システムを構築した場合、モデルの選定によってどれほどの費用差が生まれるのでしょうか?具体的な数字でシミュレーションしてみましょう。
【シミュレーション前提条件】
- 月間総クエリ数: 10,000回(社員100人が1日平均5回利用)
- 1回あたりの入力トークン: 平均1,500トークン(システム指示+過去履歴+社内マニュアルRAG検索結果)
- 1回あたりの出力トークン: 平均500トークン(要約や解説の回答文)
- 月間総トークン量: 入力 1,500万トークン(15M) / 出力 500万トークン(5M)
- 為替レート: 1ドル = 150円換算
試算パターンA:すべてフラグシップ(GPT-4o級)で処理した場合
- 入力コスト: 15M × $2.50 = $37.50
- 出力コスト: 5M × $10.00 = $50.00
- 合計月額費用: $87.50 / 月(約13,125円)
- 年間費用: 約157,500円
試算パターンB:軽量高速モデル(GPT-4o mini級)で処理した場合
- 入力コスト: 15M × $0.15 = $2.25
- 出力コスト: 5M × $0.60 = $3.00
- 合計月額費用: $5.25 / 月(約788円)
- 年間費用: 約9,450円
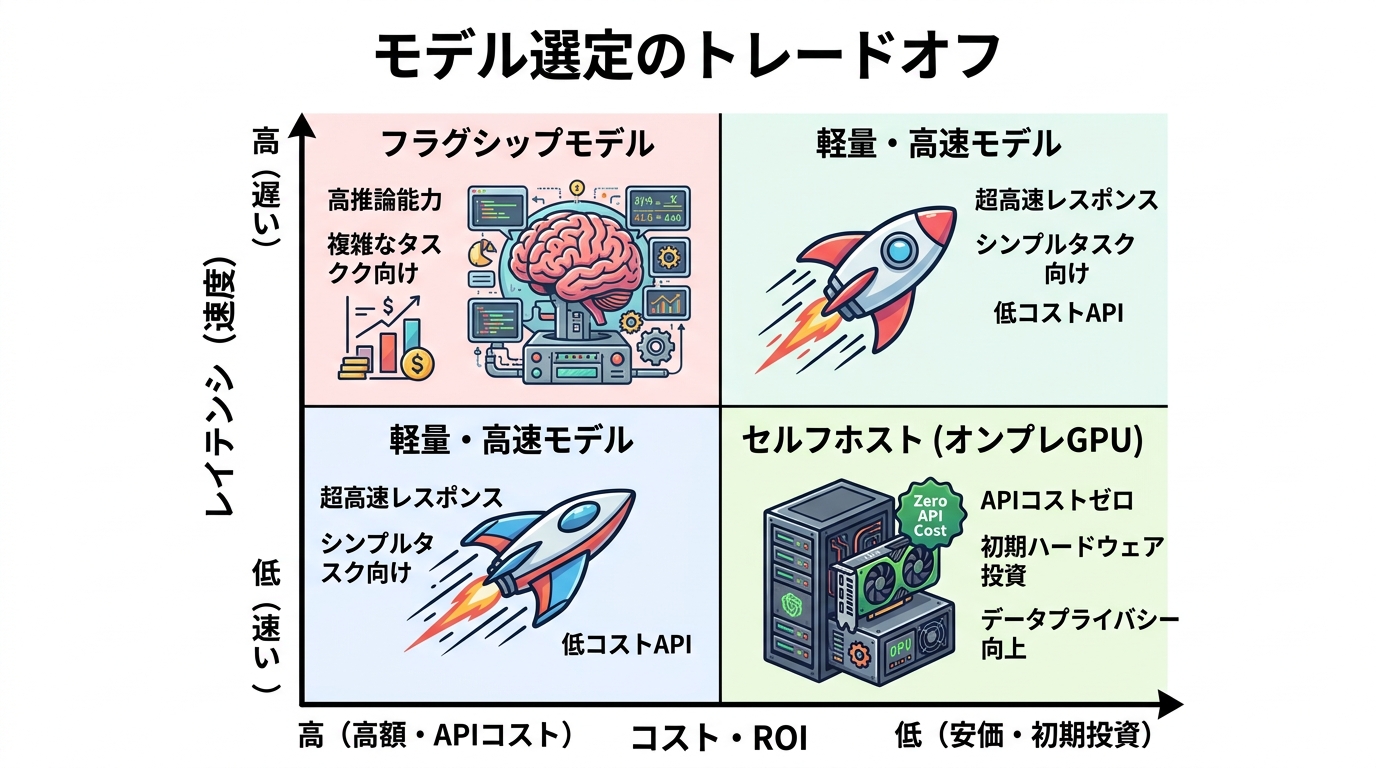
試算パターンC:現場のベストプラクティス「スマート・ルーター設計」
上記の結果を見てわかる通り、すべてフラグシップを使う場合と軽量モデルを使う場合では、年間で約16倍(15万円近く)のコスト格差が生じます。さらにクエリ数が10倍(月10万回)になれば、年間差額は150万円に跳ね上がります。
そこで現場で最も採用されているのが、「タスクに応じたLLMルーティング(LLM Router)」です。
- 日常の定型質問・挨拶・一次受付(全体の70%): 軽量モデル(GPT-4o mini / Claude 3.5 Haiku)で処理。TTFTは0.3秒と極めて高速。
- 複雑な法務・契約・高度な推論(全体の30%): フラグシップモデル(GPT-4o / Claude 3.5 Sonnet)へ自動振り分け。
- プロンプトキャッシュ適用: 共通のシステムプロンプト(約800トークン)をキャッシュし、入力単価をさらに50%圧縮。
- 結果: 月額費用はわずか約4,000円台に抑えつつ、ユーザー体験としては「7割の質問が爆速で返り、難問にも完璧に答えてくれる」という最高水準の満足度を実現できます。
LLMシステムのレスポンス速度とコストを改善する4つの処方箋
実運用の現場で、レイテンシとコストの壁を突破するための実践的チューニング技術を4点にまとめました。
① プロンプトキャッシング(Prompt Caching)の徹底
OpenAIやAnthropicが提供するプロンプトキャッシングは、同一のコンテキスト(共通システム指示や固定参照ドキュメント)をGPUメモリ上に保持する仕組みです。これにより、TTFTが最大80%短縮され、キャッシュ対象の入力料金も50〜80%ディスカウントされます。RAGシステムにおいて最も即効性のある高速化・節約手法です。
② 投機的デコード(Speculative Decoding)の採用
自前でvLLM等の推論サーバーを運用する場合、軽量な小型モデル(例:Llama-3-8B)に先行して数トークンを予測させ、巨大な親モデル(例:Llama-3-70B)がそれを1ステップで並列検証する「投機的デコード」を有効化すると、モデルの精度を1ミリも落とすことなくTPOTを1.5〜2.5倍高速化できます。
③ 出力トークン上限(max_tokens)の絞り込み
「総遅延時間は出力トークン数に比例する」という大原則を忘れてはなりません。プロンプト内で「3行以内で要約してください」「箇条書きで3点のみ」といった文字数制限を明示し、APIパラメータのmax_tokensを必要最小限に設定するだけで、無駄な長文生成による待ち時間と課金を一挙に削減できます。
④ 心理的待ち時間を削減するフロントエンドUX
技術的な限界でTTFTが1秒を超える場合でも、UI/UXの工夫で体感速度を大幅に引き上げることが可能です。リクエスト送信直後に「社内マニュアルを検索中…」といったステップ進行状況を表示したり、タイピング風のカーソルアニメーションを即座に走らせることで、ユーザーの体感待機ストレスを半減させることができます。
まとめ:全13回シリーズ完結!品質と運用の両輪で最強のLLMプロダクトを作ろう
全13回にわたってお届けしてきた「LLM評価指標の徹底解説シリーズ」も、本記事をもってすべて完結となります!
【全13回シリーズの全体像マップ】
- 第1弾:総合知能・学術知識編
- 第1回:MMLU / MMLU-Pro —— 大学・専門レベルの学術知識
- 第2回:HellaSwag —— 常識的推論と文脈継続
- 第3回:ARC / ARC-AGI —— 未知の規則性を見抜く汎用知能
- 第2弾:数学・論理推論編
- 第4回:GSM8K —— 小学校レベルの多段階文章題
- 第5回:MATH —— 高校・大学オリンピック級の高度数学
- 第6回:BIG-bench Hard(BBH) —— 思考連鎖(CoT)の限界突破
- 第3弾:実務・人間選好・指示追従編
- 第7回:LMSYS Chatbot Arena —— ユーザー盲検対決とイロレーティング
- 第8回:IFEval —— フォーマット・禁止ルールへの厳格追従
- 第4弾:実務タスク・特化領域指標編
- 第9回:HumanEval / EvalPlus & Pass@k —— コーディング能力の不偏推定
- 第10回:SWE-bench —— GitHubバグ修正と自律エージェント
- 第11回:RAGAS —— 検索精度と社内文書QAの品質切り分け
- 第5弾:事実性・安全性・運用指標編
- 第12回:TruthfulQA & HaluEval —— 人間の迷信トラップとハルシネーション検出
- 第13回:システム運用・効率性指標(本記事) —— TTFT、TPOT、スループット、100万トークンROI
どれほど精巧なプロンプトを設計し、高精度なRAGを構築しても、ユーザーが快適に使える速度と持続可能なコストが担保されていなければプロダクトは生き残れません。ぜひ本記事で解説したTTFT/TPOTの計測とルーター設計を取り入れ、「高い知能と快適なスピード、そして圧倒的な高ROI」を兼ね備えた最高のLLMシステムを構築してください!
シリーズの全体像をもう一度見直したい方は、ハブ記事であるLLM評価指標の完全総覧【全体俯瞰編】もぜひ合わせてご覧ください。