AI・機械学習 IFEval入門!文字数制限やJSON出力を自動テストする指示追従ベンチマーク LLM(大規模言語モデル)を自社の業務システムやAPI連携に組み込んで開発していると、誰もが一度は頭を抱えるトラブルがあります。それが「プロンプトに『JSON形式のみで出力して』『500文字以内で要約して』とあれほど厳命したのに、余計な挨拶... 2026.09.14 AI・機械学習AI活用
AI・機械学習 GSM8kとMATHで測るLLMの思考力!小学校算数から数学難問までの解法ステップ検証 LLMの思考力を測る「GSM8k」と「MATH」を徹底比較。算数文章題から難関数学まで、CoT(思考の連鎖)の役割や、計算ミスを防ぐ「LLM立式+Python実行」の実務アーキテクチャを分かりやすく解説します。 2026.09.10 AI・機械学習AI活用
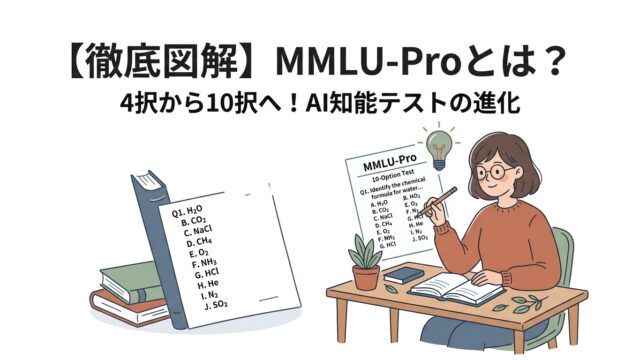
AI・機械学習 MMLUとMMLU-Proの違いを徹底解説!10択化とCoTで測る真の実力 MMLUの仕組みや特徴、従来手法との決定的な違いを徹底解説。エンジニア目線での実装ポイントや注意点・アンチパターンまで具体例を交えて分かりやすくまとめました。 2026.09.09 AI・機械学習AI活用
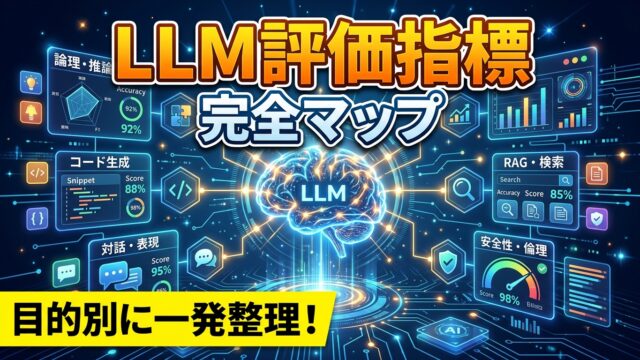
AI・機械学習 LLMの評価指標・ベンチマーク完全総覧!目的別カテゴリマップと実務での選び方【全体俯瞰編】 LLMベンチマークの全体像を体系化。知識・推論・対話・コードなど目的別の評価指標マップと、自社開発での評価指標の選び方を網羅した完全ガイド。 2026.09.03 AI・機械学習AI活用技術・プログラミング
 AI・機械学習 AI・機械学習
 AI・機械学習
 AI・機械学習
 AI・機械学習