AI・機械学習

AI・機械学習

AIエージェントの暴走を防ぐ!ガードレール設計と安全な実行基盤の実装

自律型AIエージェントの破壊的操作やプロンプトインジェクションを防ぐ「ガードレール」の設計と実装。入力・実行時・出力の3層防御アーキテクチャ、Pythonによるホワイトリスト検証インターセプター、サンドボックス隔離の手順を解説します。
AI・機械学習
AIエージェントをテストする!評価ハーネス(Evals)の設計とCI自動テスト入門

プロンプト変更やモデル更新時の性能劣化を防ぐAIエージェントの評価ハーネス設計入門。ツール呼出検証・タスク完遂検証・LLM自動採点の3層テストピラミッドと、pytestを用いたCI自動テストの実装手順を詳しく解説します。
AI・機械学習

フレームワークなしで作る!PythonとFunction Callingによる自作AIエージェント入門

LangChain等の高レベルフレームワークを使わず、公式OpenAI SDKと素のPythonのみでReAct型AIエージェントをゼロから構築する入門ガイド。AST解析による安全なツール実装、ループ遮断ハーネス、実機実行ログを網羅します。
AI・機械学習

ハーネスエンジニアリングとは?AIエージェントを実務で動かす「制御基盤」の設計論

自律型AIエージェントの無限ループやコンテキスト劣化を防ぐ制御基盤「ハーネスエンジニアリング」の設計論。ツール接続・状態永続化・ガードレール・実行監視・自己修復の5大コア要素と、導入前後の実測比較データを詳しく解説します。
AI・機械学習

TTFT・TPOTとは?LLM運用のレスポンス測定方法と100万トークン単価のROI計算シミュレーション

LLM運用の遅延とコストを評価するTTFT(初回生成時間)とTPOT(トークン生成速度)の解説。Pythonによるストリーミング測定スクリプト、主要モデルのトークン単価比較、月間1万回利用時のROI試算を整理します。
AI・機械学習

TruthfulQAとHaluEvalで暴くLLMの嘘!ハルシネーションと迷信トラップの測定法

LLMのもっともらしい嘘や迷信への迎合を暴くTruthfulQAとHaluEvalの測定手法。817問のトラップに対する真実性と有用性の2軸評価(MC1/MC2)や、ハルシネーションを見抜く自動評価の仕組みを整理します。
AI・機械学習

Jev徹底解剖|BERTとの違い・System 1の仕組みと導入手順

文章生成を捨てたAI「Jev」を徹底解剖!エンコーダ型BERTとの決定的な違いや並列サンプラーの仕組み、実務ユースケース、Pythonでの導入手順と最小実行コードまで現役エンジニアがわかりやすく解説。判断処理の高速化に必見です。
AI・機械学習

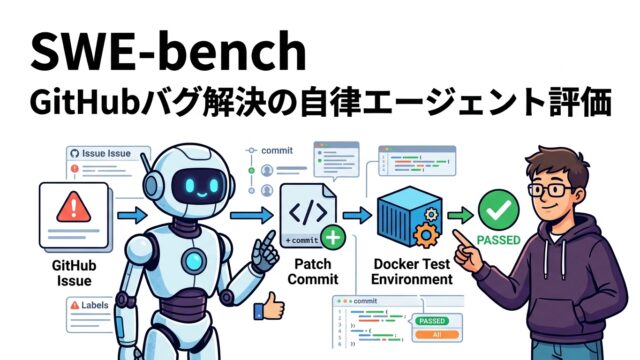
SWE-benchとは?GitHubのバグIssueをAIが自律解決できるか測る最前線

実在するOSSリポジトリのGitHub IssueをAIが自律解決できるか測るSWE-benchの全貌。Docker分離環境でのパッチ適用、FAIL_TO_PASSとPASS_TO_PASSの2段階テストによる合否判定ロジックを整理します。
AI・機械学習

HumanEvalとPass@kの計算方法!AIコーディング評価の不偏推定量を徹底解説

AIのコード生成精度を実行テストで評価するHumanEvalの仕組み。OpenAIの164問のテストセットを対象に、サンプリングによるPass@k(Pass@1/10/100)の不偏推定量計算式や測定の留意点を整理します。
AI・機械学習

IFEval入門!文字数制限やJSON出力を自動テストする指示追従ベンチマーク

LLMが指定ルールを厳守できるかを自動検証するIFEvalの仕組み。JSON形式指定や文字数制限など約25種の制約に対し、余計な挨拶文の混入も落とすStrict判定と実質的達成を見るLoose判定の測定基準を紐解きます。