評価指標

AI・機械学習

TruthfulQAとHaluEvalで暴くLLMの嘘!ハルシネーションと迷信トラップの測定法

LLMのもっともらしい嘘や迷信への迎合を暴くTruthfulQAとHaluEvalの測定手法。817問のトラップに対する真実性と有用性の2軸評価(MC1/MC2)や、ハルシネーションを見抜く自動評価の仕組みを整理します。
AI・機械学習
BLEUとROUGEの違いとは?LLM評価指標の計算式と使い分け

テキスト生成AIの品質を数値化するBLEUとROUGEの算出アルゴリズムを比較。適合率を測るBLEUと再現率を重視するROUGEの計算ロジック、Brevity Penalty、日本語形態素解析によるスコア変動の注意点を整理します。
AI・機械学習

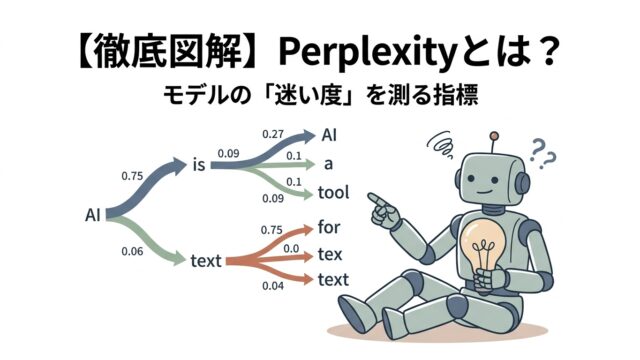
Perplexity(PPL)とは?計算方法と具体例でわかるLLM評価指標

LLMの予測性能を測る基本指標Perplexity(PPL)の数学的定義と直感的意味を図解解説。モデル比較での見方や注意点をエンジニア向けに整理。
AI・機械学習

LLMの評価指標・ベンチマーク完全総覧!目的別カテゴリマップと実務での選び方【全体俯瞰編】

LLMベンチマークの全体像を体系化。知識・推論・対話・コードなど目的別の評価指標マップと、自社開発での評価指標の選び方を網羅した完全ガイド。