LLM評価

AI・機械学習

TruthfulQAとHaluEvalで暴くLLMの嘘!ハルシネーションと迷信トラップの測定法

「自信満々にスラスラと長文を答えてくれたので信じて本番の資料に使ったら、書いてある法律の条文や医療データが完全にデタラメだった…」—— LLM(大規模言語モデル)を業務で使っている人なら、誰もが一度は背筋を凍らせた経験があるはずです。これが...
AI活用

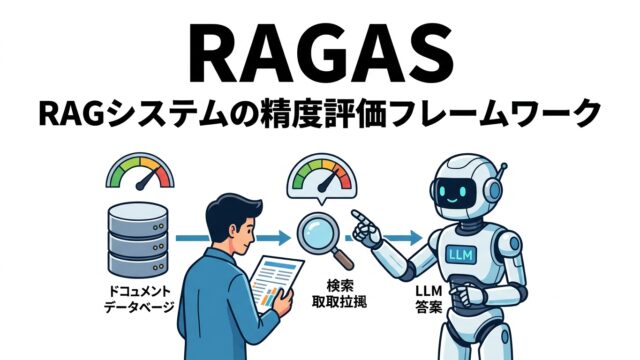
RAGASの4大指標と計算方法!社内文書QAの精度とハルシネーションを数値化する実践ガイド

「社内のマニュアルやNotion、PDF文書を検索して回答してくれる社内向けRAG(検索拡張生成)チャットボットを構築したものの、実際に全社公開してみたら『全く関係ない規則を引用して堂々と嘘をつく』『欲しい情報が全然返ってこない』とクレーム...
AI・機械学習

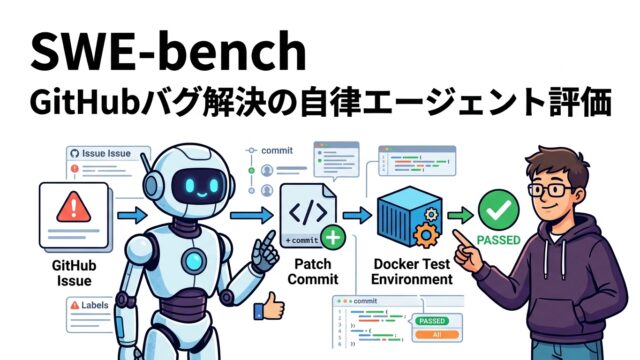
SWE-benchとは?GitHubのバグIssueをAIが自律解決できるか測る最前線

「AIコーディングのベンチマークで90%以上のスコアを出している最先端モデルを、自社のGitHubリポジトリに連れてきてバグ修正を任せてみたら、関連ファイルを1つも見つけられずに迷子になり、全く見当違いなパッチを出して沈黙した…」—— Cu...
AI・機械学習

HumanEvalとPass@kの計算方法!AIコーディング評価の不偏推定量を徹底解説

GitHub Copilot、Cursor、Claude Codeなど、日々のプログラミングでAIコード生成を使わない日はないというエンジニアが増えています。そうした中で、新しいLLMが発表されるたびにベンチマーク表のトップに登場するのが「...
AI・機械学習

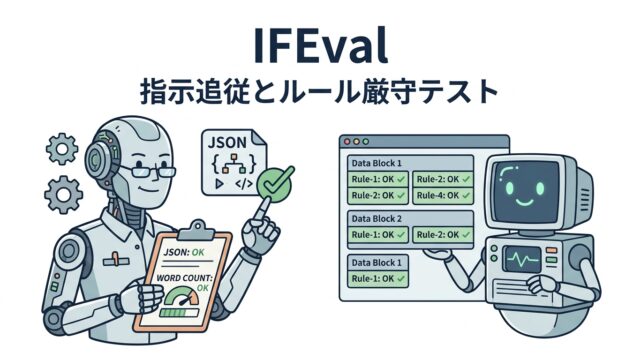
IFEval入門!文字数制限やJSON出力を自動テストする指示追従ベンチマーク

LLM(大規模言語モデル)を自社の業務システムやAPI連携に組み込んで開発していると、誰もが一度は頭を抱えるトラブルがあります。それが「プロンプトに『JSON形式のみで出力して』『500文字以内で要約して』とあれほど厳命したのに、余計な挨拶...
AI・機械学習

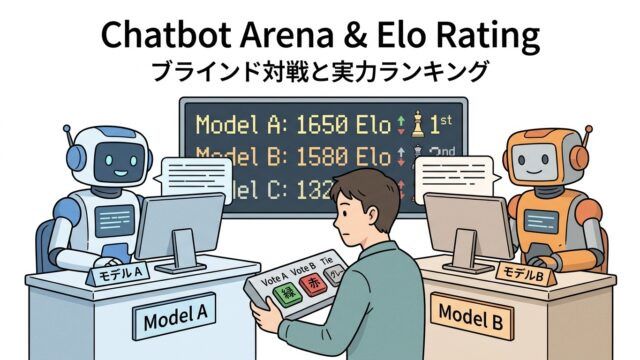
Chatbot ArenaのEloレーティング計算方法!ブラインド対戦でLLMの実力を数値化する数学的仕組み

新しいLLM(大規模言語モデル)が登場したとき、開発者コミュニティやX(旧Twitter)で真っ先に「ついに〇〇がChatbot Arenaで1位に躍り出た!」「GPT-4o超えを達成!」と大騒ぎになるのを目にしたことはないでしょうか?「そ...
AI・機械学習

MT-BenchとLLM-as-a-Judgeの仕組み!GPT-4による自動採点と3大バイアスの克服法

MT-BenchとLLM-as-a-Judgeの仕組みを解説!GPT-4等による自動採点のルーブリック設計や、2ターン対話による文脈追従力のテスト法、位置・冗長性・自己選好の3大バイアスを順序スワップで克服する実務手法を網羅。
AI・機械学習

GPQAとBBHの凄さ!最先端LLMの推論限界を暴く博士レベルベンチマーク

GPQAの仕組みや特徴、従来手法との決定的な違いを徹底解説。エンジニア目線での実装ポイントや注意点・アンチパターンまで具体例を交えて分かりやすくまとめました。
AI・機械学習

GSM8kとMATHで測るLLMの思考力!小学校算数から数学難問までの解法ステップ検証

LLMの思考力を測る「GSM8k」と「MATH」を徹底比較。算数文章題から難関数学まで、CoT(思考の連鎖)の役割や、計算ミスを防ぐ「LLM立式+Python実行」の実務アーキテクチャを分かりやすく解説します。
AI・機械学習

MMLUとMMLU-Proの違いを徹底解説!10択化とCoTで測る真の実力

MMLUの仕組みや特徴、従来手法との決定的な違いを徹底解説。エンジニア目線での実装ポイントや注意点・アンチパターンまで具体例を交えて分かりやすくまとめました。