新しいLLM(大規模言語モデル)の発表会やベンチマークの比較表を見るたびに、「MMLUスコアが〇%を達成!」「前世代から大幅向上!」といった数字が真っ先に大きく掲げられていますよね。「そもそもMMLUって何のテストなの?」「最近論文でよく見かける『MMLU-Pro』とは何が違うの?」と気になったことはないでしょうか?
前回の第2回:BLEUとROUGEの違いと計算方法では、出力テキストの表面的な一致度を測るNLP指標を解説しました。連載第3回となる今回は、AI界の「大学入学共通テスト・全国模試」として世界中で最も広く使われている学術知識・推論ベンチマーク、MMLUとその後継であるMMLU-Proを徹底解剖します。親記事のLLM評価指標の完全総覧【全体俯瞰編】でも知能テストの中核として位置づけた超重要指標です。
結論から言えば、「MMLU-Proは、従来の4択MMLUがモデルの進化によって満点近くで飽和してしまったため、選択肢を10択に増やし、思考過程(Chain-of-Thought)を強制することで真の推論力を測れるように難化させた最新の知能テスト」です。この記事では、なぜ今MMLU-Proが必要なのか、4択から10択への変更がなぜ革命的なのかを、分かりやすい具体例とともに解説します!
MMLUとは何か?AIの「全国統一模試」が果たした役割
全57分野・多肢選択式問題で知識の幅を測る
MMLU(Massive Multitask Language Understanding)は、2020年にUCバークレー校などの研究チームによって発表されたベンチマークです。その名の通り、膨大かつ多岐にわたるタスクを通じて言語モデルの理解力を測定します。
出題範囲は、初等数学、高校の歴史や物理、大学レベルのコンピュータサイエンス、さらには高度な専門職レベルの法律(司法試験)や医学問答まで、なんと全57分野におよびます。問題形式はシンプルな「4択問題(A, B, C, D)」で構成されており、幅広い学術知識を横断的に測定する標準テストとして爆発的に普及しました。
Hugging FaceのOpen LLM Leaderboardをはじめ、OpenAI、Anthropic、GoogleなどのトップAI企業が最新モデルを発表する際には、必ず「MMLUスコア」を地頭の良さの証明としてアピールしてきた歴史があります。
従来のMMLUが直面した「性能飽和(サチュレーション)」の壁
しかし、近年のフロンティアモデルの急速な進化によって、従来のMMLUには決定的な限界が訪れました。それが「性能飽和(サチュレーション現象)」です。
最先端のモデル(GPT-4o、Claude 3.5 Sonnet、Gemini 1.5 Proなど)がこぞって85%〜90%近い正解率を叩き出すようになり、もはやモデル同士の実力差がほとんど判別できなくなってしまったのです。
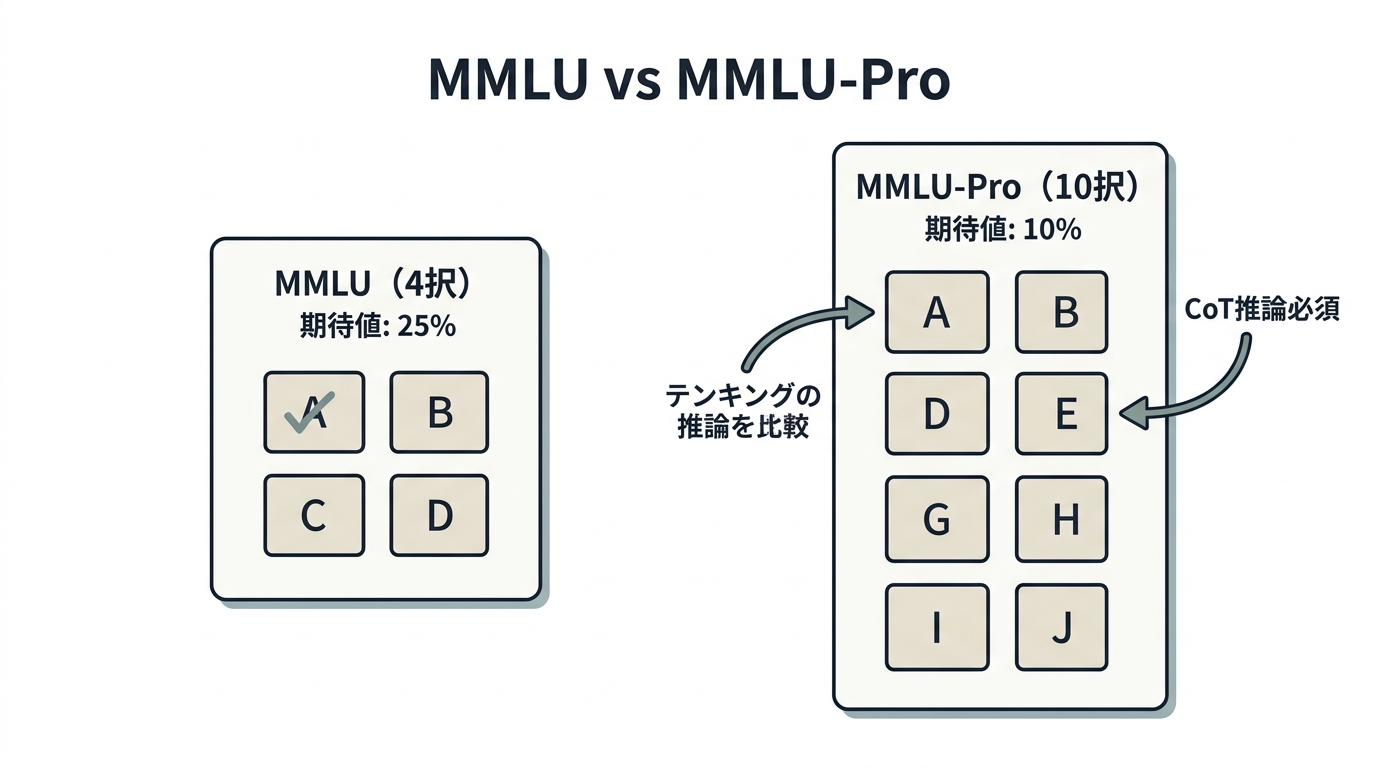
さらに深刻だったのが「4択問題」という形式そのもの限界です。4択の場合、モデルが全く理解していなくても、当てずっぽう(ランダム回答)で選ぶだけで確率的に25%の点数が取れてしまいます。中途半端な知識であっても2択まで絞り込めれば50%で当たってしまうため、「本当に深い思考をして答えているのか、単なるヤマ勘なのか」を厳密に区別できなくなっていたのです。
【進化の真相】MMLU-Proは何が変わったのか?
選択肢が4択から「10択(A〜J)」へ激増!当てずっぽうの排除
この性能飽和の壁を打ち破るべく、2024年にTIGER-AI Labの研究チームらによって発表されたのが「MMLU-Pro」です。より厳密で難易度の高いベンチマークとして再設計されました。
最大の変更点は、回答の選択肢が従来の4択から原則「10択(AからJ)」へと大幅に拡張されたことです。これによって、ランダムに選んだ場合の期待正解率は25%からわずか10%へと激減しました。
選択肢が10個もあると、正解に似せた紛らわしい誤答(ディストラクター)が大量に並びます。中途半端な知識や直感だけの推測では正解を選ぶことが極めて難しくなり、「偶然の当たり」を徹底的に排除することに成功したのです。
暗記トリビアの排除と「CoT(思考連鎖)の必須化」
MMLU-Proのもう一つの大きな進化は、出題クオリティの劇的な向上です。従来のMMLUに含まれていた単なる暗記トリビアや問題文の不備・ノイズを精査し、数学、物理、化学、情報科学など「複数ステップの論理推論が必要な問題」を中心に12,000問以上へと再構築されました。
さらに、評価時にはChain-of-Thought(CoT:思考の連鎖)の出力が標準化されました。単に「答えはCです」と記号だけを出力させるのではなく、「まず公式Aを適用し、次にステップBを計算すると…」という思考プロセスをモデル自身に展開させ、その推論の妥当性を評価します。
この改革の結果、従来のMMLUで90%近いハイスコアを出していたトップモデルたちも、MMLU-Proでは軒並みスコアが16%〜33%も大幅に急落しました。それによってモデル間の「真の知能差」が再び鮮明に浮き彫りになったのです。
【出題シミュレーション】MMLU vs MMLU-Proの比較例
従来のMMLU(4択):表面的な知識で消去法が使えた例
具体的にどれくらい難易度や出題の質が違うのか、コンピュータサイエンスの出題イメージで比較してみましょう。
従来のMMLUでは、以下のような「概念の知識」を問う問題が多く見られました。
【従来MMLUのイメージ例:4択】
問: リレーショナルデータベースにおいて、データの冗長性を排除し整合性を保つための設計手法を何と呼ぶか?
- (A) インデックス化
- (B) 正規化(Normalization)
- (C) シャーディング
- (D) キャッシング
この問題であれば、エンジニアなら一目で(B)と分かりますし、モデルにとっても単語の共起パターンから正解を導くのは朝飯前です。仮に分からなくても4択なので25%の確率で正解できてしまいますよね。
MMLU-Pro(10択):多段階の計算と思考ステップが必須な例
一方、MMLU-Proでは同じコンピュータサイエンス分野でも、以下のように「計算プロセスを自ら組み立てる問題」へと高度化しています。
【MMLU-Proのイメージ例:10択】
問: 32ビットの仮想アドレス空間を持ち、ページサイズが4KB、ページテーブルエントリが4バイトの2レベルページングシステムを考える。上位10ビットを第1レベル、次の10ビットを第2レベルのインデックスとして使用する場合、プロセスが12MBの連続した仮想メモリ領域を使用する際に必要なページテーブル全体のサイズとして最も近いものはどれか?
- (A) 4 KB (B) 12 KB (C) 16 KB (D) 20 KB (E) 24 KB
- (F) 32 KB (G) 48 KB (H) 64 KB (I) 128 KB (J) 256 KB
いかがでしょうか。この問題に正解するには、単に用語を知っているだけでは太刀打ちできません。仮想アドレスのビット配分を理解し、必要なページ数を計算(12MB ÷ 4KB = 3,000ページ)、第2レベルページテーブルが何個必要かを求め(3,000 ÷ 1,024 ≒ 3テーブル)、第1レベル(4KB)と合算する…という一連の思考ステップ(CoT)を論理破綻なく完遂する必要があります。さらに選択肢が10個もあるため、当てずっぽうの正解はほぼ不可能です。
💡 あわせて読みたい
実務でどう見る?エンジニア目線でのMMLU-Proの評価と活用法
MMLU-Proは「新入社員のSPI適性検査」、実務適応とは別物
エンジニアとしてモデル選定を行う際、MMLU-Proスコアをどう解釈すべきでしょうか?個人的には、採用活動における「大学の筆記試験やSPI適性検査のスコア」のようなものだと考えるのが最も実態に近いと感じています。
MMLU-Proでハイスコアを出すモデルは、間違いなく「複雑な前提条件を整理し、論理的な思考ステップを踏んで結論を導く地頭力(基礎推論力)」が極めて高いです。プロンプトで長文の制約条件を与えても、文脈を見失わずに粘り強く指示に従ってくれる傾向があります。
しかし、SPIが満点だからといって「初日から自社の独自業務システムを使いこなし、売上を爆増させられるか」というと、それは全く別の話ですよね。社内規程や業界固有の業務知識に正確に答えられるかどうかは、モデルの地頭だけでなく、RAG(検索拡張生成)の設計やプロンプトの工夫、ファインチューニングの質に大きく左右されます。
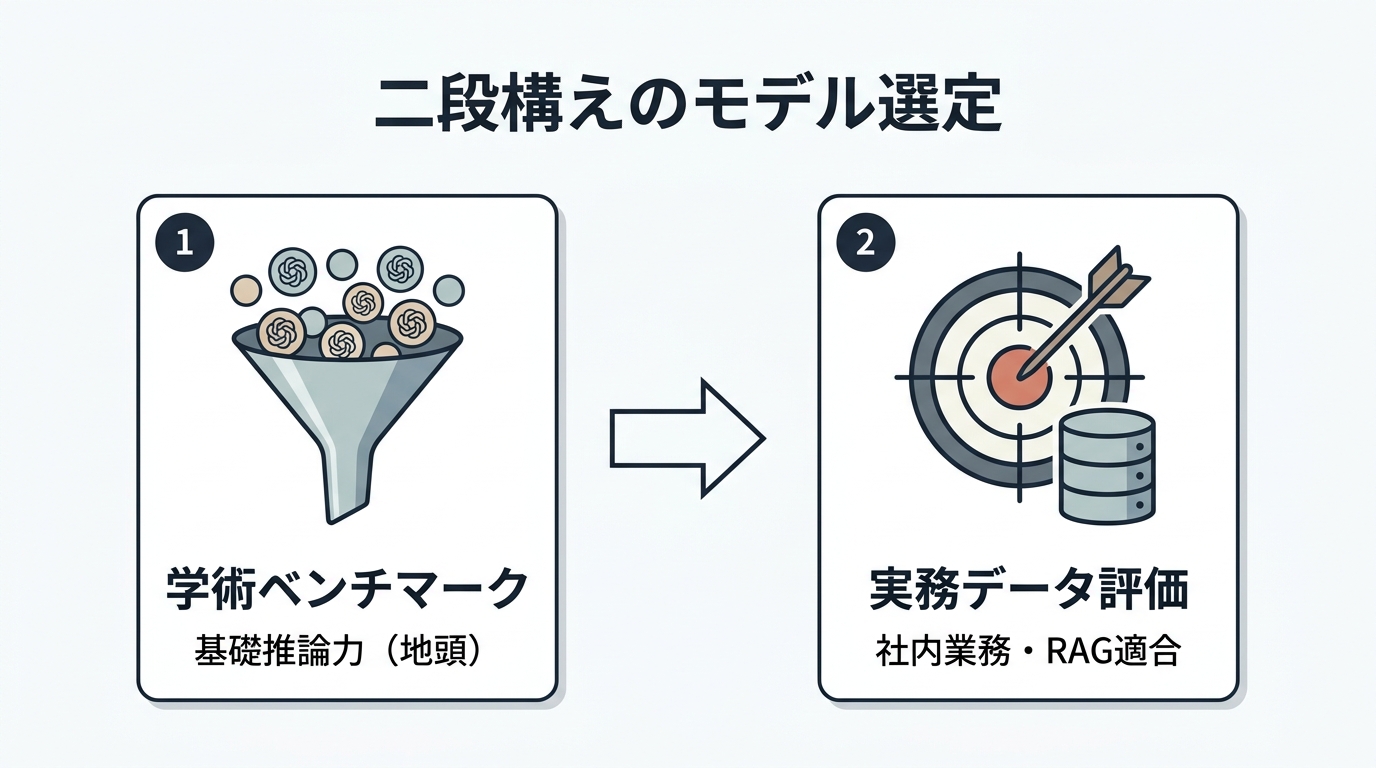
「学術ベンチマーク+自前評価」の二段構え選定が鉄則
したがって、実務でのベストプラクティスは「MMLU-Proを候補モデルの足切り・初期スクリーニングとして使い、最後は自前データで決める」という二段構えのアプローチです。
世界中で公開されている何百ものモデルの中から、まずはMMLU-Proのランキングを見て「地頭力の上位2〜3モデル(例: GPT-4o、Claude 3.5 Sonnet、Gemini 1.5 Proなど)」に絞り込みます。そして最終決定のフェーズでは、自社の実際の問い合わせログやテストケースに対してRAGAS(第11回で解説)などを回し、最もコストと精度のバランスが良いモデルを決定するのです。この手順を踏むことで、手戻りのない堅牢なシステム開発が可能になります。
まとめ
今回は、LLMの学術知能テストの最高峰である「MMLU」と「MMLU-Pro」について、その進化の背景から出題ロジック、実務での向き合い方までを詳しく解説しました。要点を振り返ってみましょう。
- 従来のMMLU(4択): 57分野の知識を測る標準テストとして普及したが、上位モデルの進化により85〜90%で性能が飽和し、4択の当てずっぽう(期待値25%)も問題視されていた。
- MMLU-Pro(10択): 選択肢を10択に拡張してランダム正解率を10%に激減させ、CoT(思考連鎖)推論を義務化したことで、真の論理的推論力を暴く最新スタンダード。
- スコアの激変: トップモデルでも従来のMMLUより16%〜33%スコアが低下し、モデルごとの知能差が明確に再評価された。
- 実務での付き合い方: 「地頭の良さ(基礎推論力)」を測る初期スクリーニングとしてMMLU-Proを活用し、業務適応力は自前のテストセットで検証する二段構えが鉄則。
大学入試レベルの総合知能テストを理解したところで、次回はさらに数学的思考力とステップ推論に特化した「第4回:GSM8kとMATHで測る思考力!小学校算数から数学五輪難問までの解法検証」に進みます!こちらもぜひ楽しみにしていてくださいね。
💡 あわせて読みたい