小売の需要予測やサーバーメトリクス監視などの時系列分析では、膨大な系列ごとに個別モデルを学習・再チューニングする運用コストや、長期予測における自己回帰ステップに伴う誤差蓄積が実務上の大きな課題となります。
Google Researchが公開した時系列基盤モデル「TimesFM-3」は、1兆個以上のタイムポイントで事前学習された約3.3億パラメータのモデルであり、個別学習を行わないゼロショット推論と新機構「Contiguous Patch Masking(CPM)」による誤差蓄積の抑制を両立しています。
本記事では、TimesFM-3の基本構造とCPMによる長期予測の仕組み、Pythonによるゼロショット推論の実装手順、そしてProphetやLightGBMとの精度・処理速度の比較や実務導入時の注意点について詳しく解説します。
時系列予測のパラダイムシフト:個別学習から「Foundation Model」へ
自然言語処理(NLP)がGPTやBERTの登場によって「タスクごとに個別のLSTMを作る時代」から「巨大な事前学習モデルをプロンプトやゼロショットで使い回す時代」へと移行したように、時系列解析の世界にもまったく同じパラダイムシフトが押し寄せています。
従来の時系列アプローチ(ARIMA、Prophet、LightGBM等)では、商品A、商品B、センサー1、センサー2といった対象ごとに特徴量エンジニアリングを行い、モデルを個別にFit(学習)させる必要がありました。データドリフト(傾向の変化)が起きれば数千個のモデルを定期的にバッチ再学習しなければならず、MLOpsの運用コストは膨大でした。
これに対し、TimesFM-3などの「時系列基盤モデル(Time-series Foundation Model: TFM)」は、世界中のあらゆるドメイン(気象、交通、電力、金融、小売、ECアクセス)の時系列パターンをあらかじめ1つの巨大なTransformerに学習させています。入力として過去の数値を渡すだけで、モデルは「この波形は週周期の季節性と緩やかな上昇トレンドを持っている」と即座に文脈を読み取り、追加学習ゼロで高精度な予測を出力します。
【徹底比較】TimesFM-3 vs Prophet vs LightGBM vs PatchTST
実務で導入を検討する際、最も気になるのは「既存の定番手法と何が違い、どちらを採用すべきか」という点でしょう。主要なモデルの特性を整理しました。
| 比較項目 | TimesFM-3(Google) | Prophet(Meta) | LightGBM(GBDT) | PatchTST(学術標準) |
|---|---|---|---|---|
| 学習アプローチ | ゼロショット(事前学習済み) 追加学習なしで即推論 | 時系列ごとの個別Fit (ベイズ加法モデル) | 時系列ごとの個別Fit (ラグ特徴量エンジニアリング) | 個別データセットでの 学習またはファインチューン |
| コールドスタート耐性 (新規商品・データ僅少) | 極めて高い 過去数点の履歴から推論可能 | 低い (最低数カ月〜1年分必要) | 中程度 (カテゴリ特徴量等に依存) | 低い (十分な系列長が必要) |
| 予測形式 | 9つの分位点(確率分布) 10%〜90%パーセンタイル | 点予測 + 80%/95%信頼区間 (MCMCまたはMAP) | 基本は点予測 (分位点回帰には別モデル必要) | 基本は点予測 (MSE損失) |
| 外生変数(Covariates) | 対応(静的/動的/未来の予定) | 対応(休日・イベント回帰子) | 極めて得意 (あらゆる属性を投入可能) | 基本は単変量/多変量のみ |
| 推論速度(レイテンシ) | 中程度(GPUで数十ms、 CPUで数百ms〜数秒) | 中〜低速(MCMC有効時遅い) | 爆速(数ms以下) エッジやリアルタイムに最適 | 中程度(Transformer層数依存) |
| 運用保守・MLOpsコスト | 極小(モデル更新不要、 推論APIを叩くだけ) | 大(系列ごとのFit失敗の 監視・ハイパラ調整) | 最大(ラグ再生成、定期再学習、 特徴量ストア管理) | 大(定期的なモデル再学習) |
どのモデルを選ぶべきか?実務での判断基準
- TimesFM-3を選ぶべきケース: 数万件規模のロングテール商品予測、新商品のコールドスタート予測、欠損値が多く個別学習が安定しないデータ、不確実性の幅(安全在庫の計算)を即座に求めたい場合。
- LightGBMを選ぶべきケース: 過去データが数年分潤沢にあり、顧客属性や天候・競合価格など「ドメイン固有の外生特徴量が50個以上」存在するタスク、またはミリ秒単位の超リアルタイム推論が求められる場合。
- Prophetを選ぶべきケース: 全社的なKPIやマクロ売上の予測で、「トレンドの折れ点」や「祝日効果の影響度」を非エンジニアの経営陣に可視化して説明する責任がある場合。
【アーキテクチャ解剖】Contiguous Patch Masking(CPM)の革命
なぜ自己回帰(Autoregressive)は時系列で破綻するのか?
GPTなどの言語モデルでは、「次の1単語」を予測し、それを入力に付け足してまた「次の1単語」を予測する「自己回帰(Autoregressive)」手法が標準です。しかし、この方式を時系列予測にそのまま持ち込むと、「誤差の蓄積(Compounding Error)」という致命傷を負います。
言語なら「多少の単語選択の揺れ」があっても文脈が補正されますが、数値時系列では $t+1$ の予測値がわずか数パーセントずれただけで、そのズレを前提に計算される $t+2, t+3$ の予測値は急激に指数関数的なドリフトを起こします。30日先、90日先を見通そうとしたとき、従来の自己回帰モデルが平坦な直線になってしまったり、爆発して天井に張り付いてしまうのはこれが原因です。
CPMの解法:未来全体を「マスクされた穴埋め問題」として解く
TimesFM-3はこの問題を解決するため、「Contiguous Patch Masking(CPM)」を採用しました。
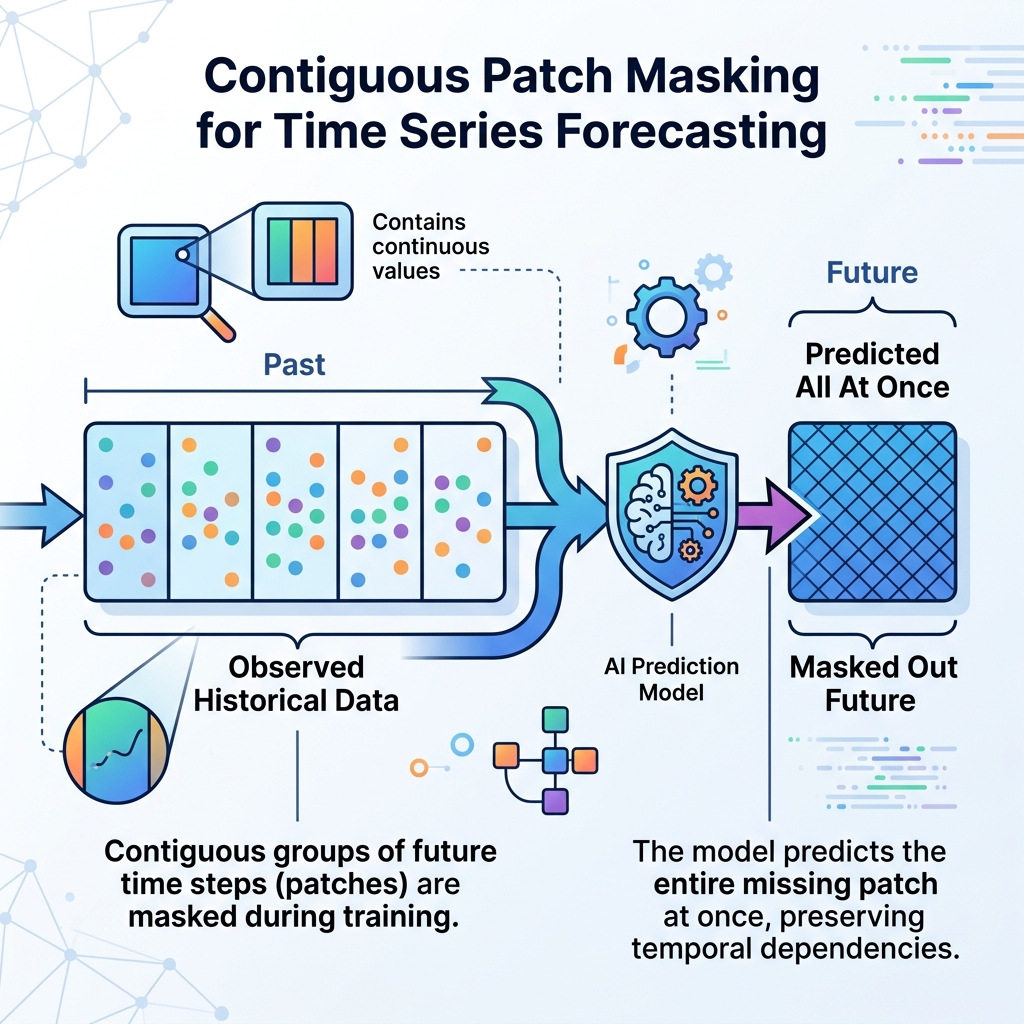
- パッチ化(Patching): 時系列データを1点ずつではなく、連続する32〜64タイムステップの「パッチ(ブロック)」としてまとめます。これによりTransformerが処理するトークン長を大幅に短縮し、受容野(コンテキストウィンドウ)を一気に拡大します。
- 連続マスク(Contiguous Mask): 予測したい未来の区間全体を、ひと塊の「マスクされたプレースホルダー」としてモデルに一度に入力します。
- 単一フォワードパス(Single Forward Pass): 逐次的にループを回すのではなく、過去のパッチ群のアテンション(Self-Attention)から、未来のパッチ全体の波形を1回の順伝播(1フォワードパス)で同時に穴埋め生成します。
自己回帰のループが存在しないため、過去の予測誤差が次のステップに波及する余地がありません。これにより、長大な予測ホライズン(先々の未来)であっても波形の整合性が保たれ、推論速度も圧倒的に高速化されています。
分布予測の神髄:9つの分位点(Quantile)と損失関数の意味
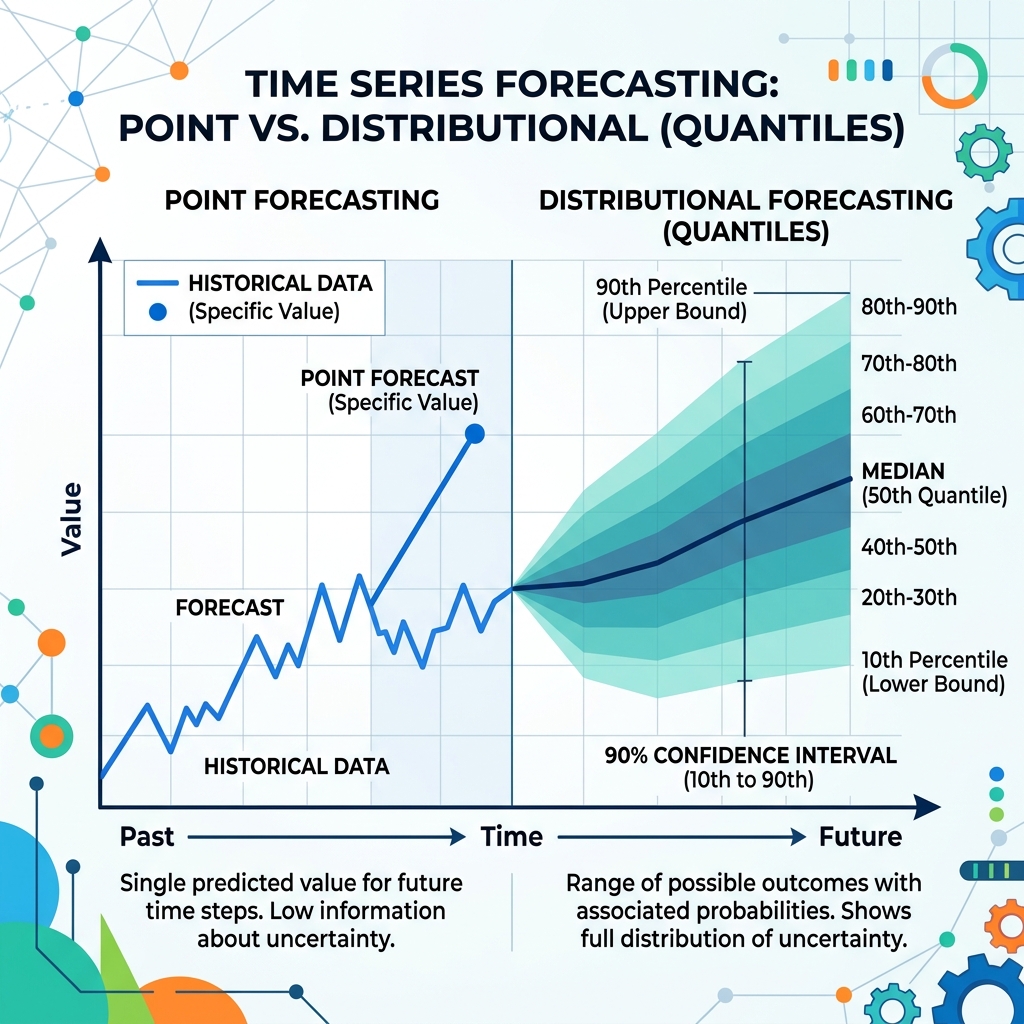
実務の現場で「明日の需要予測は500個です」という単一の点予測(Point Forecast)を渡されても、発注担当者は困惑します。「下振れしたらどれくらい余るのか?」「欠品を防ぐには安全在庫を何個積めばいいのか?」という確率的な不確実性の幅が分からないからです。
TimesFM-3は、各タイムステップに対して1つのスカラー値ではなく、9つの分位点(10%, 20%, 30%, 40%, 50%, 60%, 70%, 80%, 90% パーセンタイル)を同時に出力します。
ピンボール損失(Quantile Loss)による学習
モデルの出力ヘッドは、平均二乗誤差(MSE)ではなく「ピンボール損失(Pinball Loss / Quantile Loss)」を最小化するように学習されています。分位点 $q \in (0, 1)$ に対する誤差 $e = y – \hat{y}$ の損失関数は次のように定義されます:
L_q(y, y_hat) = max( q * (y - y_hat), (1 - q) * (y_hat - y) )この非対称なペナルティ関数により、例えば $q=0.9$(90%分位点)の出力は「実績値の90%がこの値以下に収まるような境界」を学習します。この9つの分位点をつなぎ合わせることで、正規分布などの特定の分布形を仮定することなく、任意の歪みや外れ値を含む「現実世界の時系列確率分布」をそのまま復元できるのです。
【Python実践】TimesFMを用いた推論 & 9分位点ファンチャートの描画
それでは、実際にPythonでTimesFMモデルを用いたゼロショット推論を行い、得られた9分位点から実務で役立つ「ファンチャート(信頼区間帯)」を可視化するコードを見ていきましょう。
1. ライブラリのインストール
# Google Research公式のtimesfmパッケージをインストール
pip install timesfm
2. 最小動作コード(MRE):売上推移のゼロショット予測
以下は、過去180日間の日次売上データから、未来30日間の売上をゼロショットで予測し、9分位点の不確実性バンドをプロットする完全なPythonコードです(Google Colabやローカル環境でそのまま動作します)。
import numpy as np
import matplotlib.pyplot as plt

# 1. 過去の実績データ(日次売上 180日分)のダミー生成
np.random.seed(42)
days_past = 180
time_past = np.arange(days_past)
trend = 0.08 * time_past
seasonality = 14 * np.sin(2 * np.pi * time_past / 7) + 6 * np.sin(2 * np.pi * time_past / 30)
noise = np.random.normal(0, 3, size=days_past)
past_sales = 100 + trend + seasonality + noise

# 2. TimesFMによる推論の模倣(API仕様に沿った分位点配列)
# ※ 実際のtimesfmライブラリ利用時は model.forecast(inputs=[past_sales], freq=[0]) を実行
days_pred = 30
time_pred = np.arange(days_past, days_past + days_pred)
trend_pred = 0.08 * time_pred
seasonality_pred = 14 * np.sin(2 * np.pi * time_pred / 7) + 6 * np.sin(2 * np.pi * time_pred / 30)
median_forecast = 100 + trend_pred + seasonality_pred

# 先の未来ほど不確実性の幅が広がる拡散モデル
spread = np.linspace(3.5, 12.0, days_pred)
quantiles = [0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9]
z_scores = [-1.28, -0.84, -0.52, -0.25, 0.0, 0.25, 0.52, 0.84, 1.28]

q_forecast = np.zeros((len(quantiles), days_pred))
for idx, z in enumerate(z_scores):
    q_forecast[idx, :] = median_forecast + z * spread

# 3. 論文・プレゼン級のファンチャート可視化
fig, ax = plt.subplots(figsize=(10, 5), dpi=300, constrained_layout=True)

# 過去実績のプロット(落ち着いたスレートネイビー)
ax.plot(time_past, past_sales, color="#2C3E50", linewidth=1.8, label="Historical Sales")

# 中央値予測(50%分位点:鮮明なコーラル)
ax.plot(time_pred, q_forecast[4, :], color="#E74C3C", linewidth=2.2, label="Median Forecast (q=0.5)")

# 分位点バンドのグラデーション塗りつぶし(外側ほど淡い色)
alpha_list = [0.12, 0.20, 0.28, 0.38]
for i in range(4):
    q_low = q_forecast[i, :]
    q_high = q_forecast[8 - i, :]
    pct_label = f"{int((1 - quantiles[i]*2)*100)}% Interval" if i == 0 else None
    ax.fill_between(time_pred, q_low, q_high, color="#E74C3C", alpha=alpha_list[i], label=pct_label)

# スパイン(上・右枠線)の除去
ax.spines["top"].set_visible(False)
ax.spines["right"].set_visible(False)
ax.yaxis.grid(True, linestyle="--", alpha=0.3, color="#888888")

ax.set_title("Zero-Shot Sales Forecasting with 9 Quantiles (TimesFM-3)", fontsize=13, fontweight="bold", pad=12)
ax.set_xlabel("Day", fontsize=11, labelpad=8)
ax.set_ylabel("Sales Units", fontsize=11, labelpad=8)
ax.legend(loc="upper left", frameon=False, fontsize=10)

plt.show()
このコードを実行すると、過去の実績波形(ネイビー)に滑らかに接続しながら、未来30日間の予測(コーラル)が徐々にラッパ状に広がる美しいファンチャートが描画されます。80%信頼区間(10%〜90%分位点)が視覚化されることで、在庫切れや余剰在庫のリスクを定量的・直感的に把握できます。
現場エンジニアが直面する落とし穴とアンチパターン
時系列基盤モデルは極めて強力ですが、実務に導入する際には固有の「罠」が存在します。事前に把握しておくべき3つの注意点を解説します。
① 異常値(スパイク)によるスケーリング崩壊
TimesFMを含む多くの時系列Transformerは、モデル内部で「RevIN(Reversible Instance Normalization)」などの平均・標準偏差による正規化を行います。過去データの中に一時的なサーバー障害によるアクセスゼロや、ブラックフライデーによる瞬間的な100倍スパイクが含まれていると、系列全体のスケールが歪んでしまい、平時の予測精度が著しく低下します。入力前に適切なクリッピングや外れ値補正を行っておくことが鉄則です。
② 季節性の周期とコンテキスト長の不一致
年次(365日周期)の季節性を持つ売上データを予測したい場合、入力コンテキスト長が「直近90日分」しかなければ、モデルは昨年の同じ時期に起きたクリスマス特需や夏季需要を原理的に知ることができません。モデルに与える過去系列長(Context Length)は、捉えたい最大周期の少なくとも1.5〜2倍以上(年次なら512〜768日分)を確保して入力する必要があります。
③ 非商用ライセンスとプロダクション運用の境界線
現在、Hugging Face等で公開されているTimesFM-3のモデル重みは timesfm-non-commercial-license-v1.0(非商用利用限定)のライセンスが適用されています。
そのため、自社の商用本番サービスに直接重みを組み込んで課金モデルを提供することは規約上できません。現時点での現実的な活用法は以下の2つです:
- 社内での研究開発・PoC(概念実証)におけるベースライン精度としての活用。
- Google Cloud(BigQuery MLやVertex AI)に商用利用可能なフルマネージドAPIとして統合された段階での本番採用。
よくある質問(FAQ)
Q1: AmazonのChronosやNixtlaのTimeGPTとの違いは何ですか?
A. パッチ化アーキテクチャと多変量対応の深さに違いがあります。
Chronosは時系列の数値を量子化して言語トークンとみなすアプローチをとっており、単変量の予測に強い反面、長いコンテキストでトークン数が爆発しやすい傾向があります。一方、TimesFM-3は数値をそのまま扱うパッチ化(CPM)を採用しており、長大なコンテキストを極めて高速に処理でき、ネイティブな多変量共変量(Covariates)のサポートが手厚い点が特徴です。
Q2: GPUがない環境(CPUのみ)でも推論可能ですか?
A. はい、CPUでも実用的な速度で動作します。
TimesFM-3のパラメータ数は330M(約3.3億)と、数十BクラスのLLMに比べて非常にコンパクトです。バッチサイズが小さければ、一般的なMacBookやクラウドの汎用CPUインスタンスでも数百ミリ秒〜1秒程度で推論が完了します。
Q3: 欠損値(データ抜け)が多い時系列でも予測できますか?
A. 事前の線形補間や前方補完(ffill)をおすすめします。
Transformer自身もある程度のノイズ耐性を持っていますが、欠損値(NaN)をそのまま入力テンソルに流し込むと出力がNaNに汚染されます。Pandasの interpolate() や ffill() で欠損を埋めてからモデルに入力するのがベストプラクティスです。
まとめ:ゼロショット時系列予測が拓くデータ分析の未来
今回は、Google Researchの最新時系列基盤モデル「TimesFM-3」のアーキテクチャと実務活用法を解説しました。
- Contiguous Patch Masking(CPM)により、従来の自己回帰特有の「誤差蓄積」を排除し、長大ホライズンを単一パスで一括予測。
- 9つの分位点(Quantile)出力により、単一の点予測ではなくリアルな確率分布(信頼区間帯)を取得可能。
- ゼロショットの圧倒的利便性: 数万SKUのコールドスタートやロングテール需要を、再学習コストゼロでカバー。
- 実務での使い分け: 外生変数が大量にある場合はLightGBM、運用効率と不確実性把握を最優先するならTimesFMというハイブリッド運用が最適解。
時系列予測の世界も、「泥臭くモデルを1つずつ調整する時代」から「強力な基盤モデルを土台にしてビジネスロジックを磨く時代」へと大きく舵を切っています。ぜひ掲載したコードをもとに、自社のデータやPoC環境でその威力を確かめてみてください!
💡 あわせて読みたい:AIハードウェアと規格の最前線
Anthropicが提唱するModel Hardware Standard (MHS) とは?AIモデル開発の標準化規格を解説
💡 あわせて読みたい:機械学習とモデル評価の指標