GitHub Copilot、Cursor、Claude Codeなど、日々のプログラミングでAIコード生成を使わない日はないというエンジニアが増えています。そうした中で、新しいLLMが発表されるたびにベンチマーク表のトップに登場するのが「HumanEval」と、そこに添えられた「Pass@1」「Pass@10」という謎の指標です。
前回の第8回:IFEval[指示追従・ルール厳守)では、JSON形式や文字数制限をプログラムで白黒判定する仕組みを解説しました。そして連載第4弾「実務タスク・特化領域指標編」の幕開けとなる今回は、エンジニアにとって最も実利に直結するコード生成能力の金字塔「HumanEval:AIコーディング評価ベンチマーク」を取り上げます。親記事のLLM評価指標の完全総覧【全体俯瞰編】でも、開発者向け実用指標の筆頭として紹介しました。
結論から言うと、「HumanEvalは全164問のPythonプログラミング課題を実際にユニットテスト実行して『本当に動くか』を検証するテストであり、Pass@kは『k回の試行で少なくとも1つ動くコードが得られる確率』を統計学の不偏推定量でブレなく算出した指標」です。
この記事では、高校数学の組み合わせ(コンビネーション)を使ったPass@kの美しい計算シミュレーションから、なぜ単純な平均値ではなく不偏推定量が必要なのか、さらにはテストケースの甘さを突いて生まれた拡張版「EvalPlus[HumanEval+]」の衝撃まで、現場のプログラマ目線で余すところなく解説します!
HumanEvalとは何か?「文字列一致」を捨てて「実行テスト」で測る革命
BLEUやROUGEではコードの正しさを測れない
第2回で解説したBLEUやROUGEなどのNLP指標は、「正解の模範解答と単語の一致率」を測るものでした。しかし、ソースコードの世界で文字列の一致率を競うのは全く意味がありません。
例えば、同じ「リスト内の偶数のみを合計する関数」を書く場合でも、for ループで書くエンジニアもいれば、内包表記や filter、再帰関数を使うエンジニアもいます。変数名が total だろうが ans だろうが、正しく動けばどちらも100点満点のコードです。逆に、たった1文字 + と - を間違えただけで、文字列一致率が99%高くてもプログラムとしてはゴミ同然(Bug)になってしまいます。
OpenAIがCodex開発時に生み出した164問のテストセット
そこで2021年、OpenAIの研究チーム(Chenら)がGitHub Copilotの頭脳となる「Codex」を評価するために開発したのがHumanEvalです。
HumanEvalは、人間が手作業で作成した164個のPythonプログラミング問題で構成されています。各問題は以下の3要素から成り立っています。
- プロンプト(関数のシグネチャとDocstring): 関数の名前、引数、型ヒント、処理内容の説明、そして入出力の具体例。
- 模範解答(Canonical Solution): 人間が記述した正解コード(難易度はLeetCodeのEasy〜Medium前半レベル)。
- ユニットテスト(Test Cases): モデルが生成したコードが仕様を満たしているかを検証する複数の
assert文。
【HumanEvalの問題例(イメージ)】
def has_close_elements(numbers: list[float], threshold: float) -> bool:
    """与えられたリストの中に、互いの差が threshold 未満の2つの要素が存在するか判定せよ。
    >>> has_close_elements([1.0, 2.0, 3.9, 4.0, 5.0, 2.2], 0.3)
    True
    >>> has_close_elements([1.0, 2.0, 5.9, 4.0, 5.0], 0.95)
    False
    """
# ここから下をLLMに補完・生成させる評価時は、LLMが補完した関数コードを実行環境にロードし、非公開のユニットテスト群(assert has_close_elements(...) == ...)を実行。全テストを例外なくパスした場合のみ「正解(Pass)」と判定します。
【核心の計算ロジック】Pass@kと「不偏推定量」の数学的仕組み
なぜPass@1、Pass@10、Pass@100と分けるのか?
プログラミングにおいて、AIに1回だけコードを出力させて一発で正解を引く力(Pass@1)はもちろん重要です。しかし、実務の開発現場では「AIに候補コードを何パターンか出させ、ローカルのテストスイートを通ったものを採用する」あるいは「IDEでTabキーを押して別候補を試す」という使い方がよくありますよね。
つまり、「1回のチャンスで当てられるか(Pass@1)」だけでなく、「10回チャンスがあれば正解に辿り着けるか(Pass@10)」「100回試せば解法を発見できるポテンシャルがあるか(Pass@100)」を測ることで、モデルの「確実性」と「潜在的な探索力・知能の上限」を両面から評価できるのです。
素朴な計測(単純サンプリング)が抱える致命的な欠点
「Pass@10を測りたいなら、各問題につき10個コードを生成して、1つでも動けば1点とすればいいじゃないか」と思うかもしれません。
しかし、この素朴なやり方には大きな問題があります。10回という少ないサンプルでは、たまたま運良く正解を引いたり外したりする「偶然のブレ(分散・バリアンス)」が極めて大きくなり、テストを実行するたびにスコアが5%〜10%も乱高下してしまうのです。
分散を抑えるために「10個生成する試行を100回繰り返す(計1,000個生成)」とすると、APIコストと実行時間が天文学的に跳ね上がってしまいます。
Codex論文が提示した「不偏推定量」の鮮やかな計算式
このジレンマを数学的に鮮やかに解決したのが、Chenらが提唱した「不偏推定量(Unbiased Estimator)」です。
各問題に対してあらかじめ大きめのサンプル数(例えば n = 100 個や n = 20 個)を生成し、そのうちテストに合格した正解コードの数を c 個とします。このとき、「生成した n 個の中からランダムに非復元抽出で k 個を選んだとき、少なくとも1つが正解である確率の期待値」は、以下の組み合わせ(コンビネーション)の数式で一発で厳密に計算できます。
【Pass@k 不偏推定量の計算式】
Pass@k = 1 − [ n−cCk / nCk ]
- n:モデルに生成させた総サンプル数(例: 20〜100)
- c:全ユニットテストをパスした正解コードの数
- k:評価したい試行回数(1, 10, 100 など。ただし k ≤ n)
- nCk:n個からk個を選ぶ組み合わせの総数
考え方は高校数学の確率と同じです。「少なくとも1つ当たる確率」を直接計算するのではなく、「全体(1)から、選んだ k 個がすべて外れ(不合格コード n−c 個の中から k 個引いてしまう)である確率を引く」という余事象のアプローチをとっています。
もし正解数 c が n − k + 1 個以上あれば、外れコードの総数 n − c が k 個未満になるため、分子の n−cCk は 0 となり、Pass@k は確実に 1.0(100%)になります。
ステップ・バイ・ステップの計算シミュレーション
直感をつかむために、具体的な数字を当てはめて計算してみましょう。
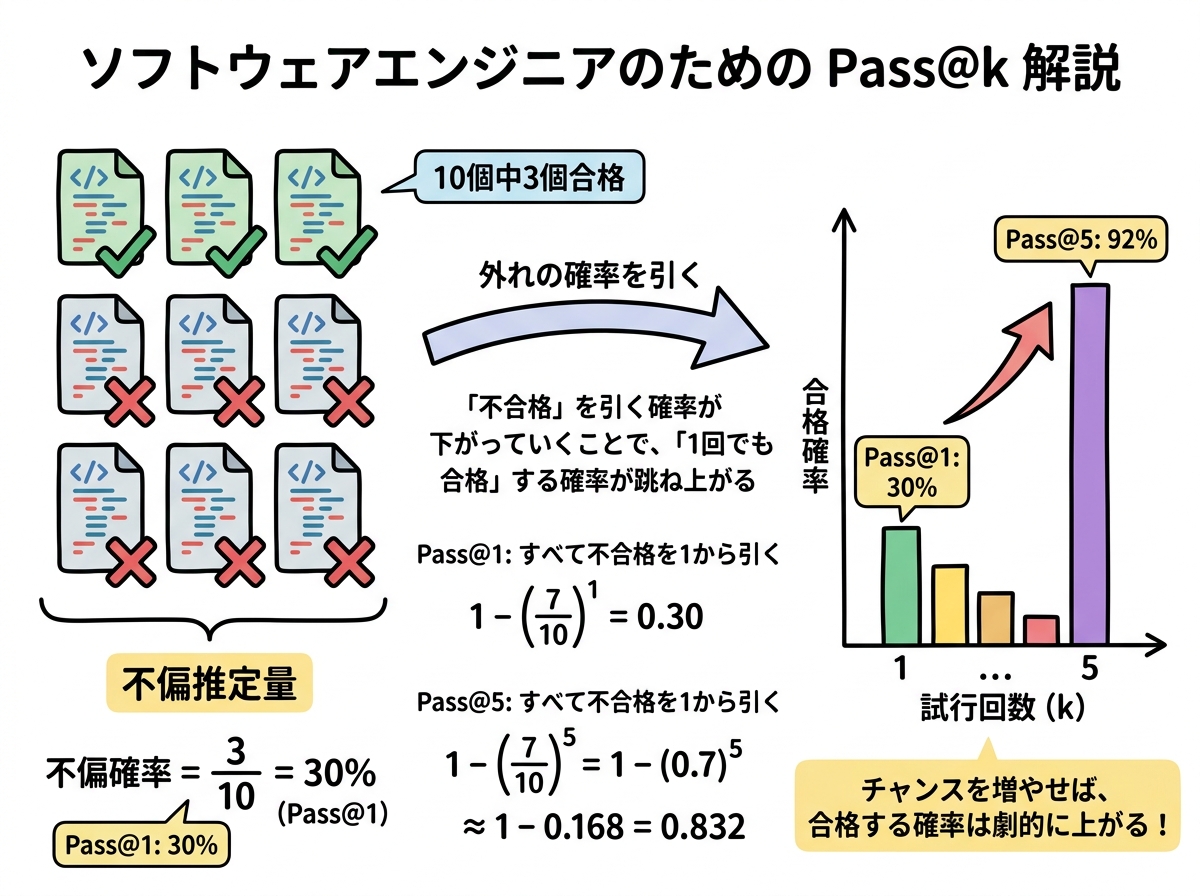
あるプログラミング課題に対して、LLMにコードを n = 10 個 生成させました。ユニットテストを実行したところ、合格したのは c = 3 個、不合格(バグあり)は 7 個 だったとします。
| 指標 | 組み合わせ計算のプロセス | 算出スコア |
|---|---|---|
| Pass@1 | 1 − (7C1 / 10C1) = 1 − (7 / 10) = 3 / 10 | 30.0% |
| Pass@2 | 1 − (7C2 / 10C2) = 1 − (21 / 45) = 24 / 45 | 約 53.3% |
| Pass@5 | 1 − (7C5 / 10C5) = 1 − (21 / 252) = 231 / 252 | 約 91.7% |
| Pass@8 | 不合格品が7個しかないため、8個選べば必ず1個は正解が含まれる(7C8 = 0) | 100.0% |
どうでしょうか?一発勝負の Pass@1 ではたった 30% の正解率しかないモデルであっても、5回の生成チャンスを与えてテスト実行でフィルタリングすれば 91.7% の確率で動くコードに辿り着けることが数学的に証明されます。
この「Pass@1とPass@kのギャップ」こそが、自律型コーディングエージェント(テストを走らせて失敗したら自動で再生成・リトライするアーキテクチャ)の実用性を支える理論的支柱なのです。
HumanEvalの限界と進化形「EvalPlus[HumanEval+]」の登場
「テストケースが甘すぎる」という大問題
HumanEvalは長年、LLMのコード能力を測るデファクトスタンダードとして君臨してきましたが、近年モデルの急激な進化に伴い、重大な弱点が露呈しました。
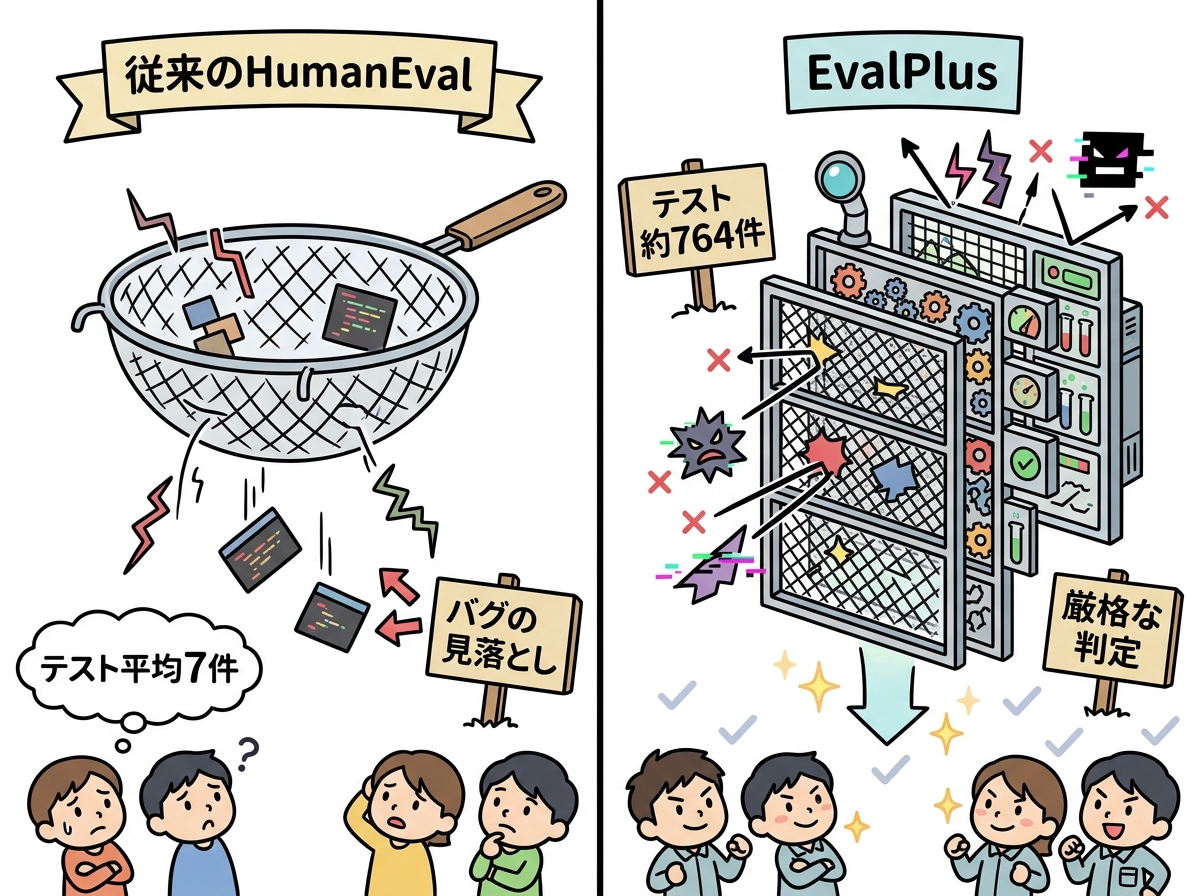
それは「1問あたりのユニットテスト数が平均7.7個しかなく、テストケースが非常に甘い」という点です。
典型的な例として、空のリスト []、負の整数、極端に大きな数値、同一要素の重複といったコーナーケース(境界値)のテストが含まれていない問題が多数ありました。その結果、「アルゴリズムの考慮漏れがあるバグだらけのコードなのに、用意された甘いテストをたまたますり抜けて合格(Pass)してしまう」という疑似合格が横行したのです。
テストケースを80倍に増強した「HumanEval+」の衝撃
このテスト不足問題を解決すべく、2023年にバージニア大学の研究チームが発表したのが「EvalPlus[HumanEval+]」です。
EvalPlusは、LLMを用いた自動テスト生成とミューテーション解析(コードを微小に変異させてテストがバグを検知できるかを検証する技術)を組み合わせ、HumanEvalの1問あたりのテストケース数を平均7.7個から約764個へと約80倍に拡張しました。
| 比較項目 | オリジナルの HumanEval | 拡張版 EvalPlus[HumanEval+] |
|---|---|---|
| 総問題数 | 164問(Python) | 164問(同一の課題) |
| 1問あたりテスト数 | 平均 7.7個 | 平均 約764個(約80倍!) |
| 境界値・異常系網羅 | 代表的な基本ケースのみ | 極限値、型異常、空集合などを徹底網羅 |
| 上位モデルのスコア変化 | 85%〜92%(飽和気味) | 概ね 10%〜15% 下落(真の実力が露呈) |
EvalPlusで再測定を行ったところ、従来のHumanEvalで「スコア90%超え!」と胸を張っていたトップモデルたちのスコアが軒並み75%〜80%前後へと急落しました。現在、学術界やHugging Faceのリーダーボードでは、オリジナルのHumanEval単体ではなく、この「HumanEval+」を併記して評価するのが常識となっています。
実務での活用法:エンジニア目線でのモデル選定と開発設計
ユースケース別:Pass@1 vs Pass@k の見極め方
私たちが実務でコーディング支援ツールやAPIモデルを選定する際は、用途に応じて注目すべき指標が明確に分かれます。
- 1. インライン補完(GitHub Copilotなど): 開発者がエディタでコードを打ち込んでいる最中にリアルタイムで提示される補完では、何度もリトライする暇はありません。一発でクリーンな動くコードを出せる「Pass@1(およびHumanEval+のPass@1)」の高さが最優先となります。
- 2. 自律型コーディングエージェント(Claude Code, Cursor Composer, Devin等): ユニットテストの実行環境(Sandbox)と組み合わされたエージェントの場合、初手で外してもテストエラーを見て自己修正できます。この用途では「Pass@5〜10」が高く、かつコンテキスト保持力に優れたモデルが圧倒的に強いパフォーマンスを発揮します。
なお、プロンプトの文字数制約や出力トークン数の最適化によってAPIコストを最小化しつつコーディングAIを走らせる具体的な設計については、以前まとめたLLMのトークン節約術でも詳しく解説しています。
よくある質問(FAQ)
Q1: HumanEvalで高得点のモデルなら、現場の業務リポジトリでも即戦力ですか?
A: 残念ながら即戦力とは言えません。HumanEvalは「単一のファイル内で完結する独立した短い関数(高々数十行)」のアルゴリズム実装能力を測るテストです。実際の開発現場では、数千ファイルに及ぶリポジトリの依存関係、サードパーティ製ライブラリの仕様変更、DBスキーマの整合性、Gitのコンフリクト解消といった複合的な能力が問われます。これらを測るためには、次回解説する「SWE-bench」などのリポジトリ全体を対象としたベンチマークを併せて確認する必要があります。
Q2: Python以外の言語(TypeScriptやGo、Rustなど)のコーディング能力はどう評価しますか?
A: HumanEvalを多言語に翻訳・移植した「MultiPL-E」というベンチマークが広く使われています。JavaScript, TypeScript, C++, Java, Go, Rust, PHPなど約18言語に対応しており、Python以外の主要言語におけるPass@kを横断的に比較検証することが可能です。
まとめ
今回は、AIコード生成の能力をユニットテスト実行で客観的に測定する「HumanEval」と、その信頼性を支える「Pass@k不偏推定量」の数学的仕組みを解説しました。要点を振り返ってみましょう。
- 実行ベースの評価: 単なる文字列一致ではなく、実際にユニットテストを実行してPass/Failを白黒判定する164問のPythonベンチマーク。
- Pass@k不偏推定量: 生成した n 個のサンプルから k 個引いたときに少なくとも1つ正解する期待値を、余事象の組み合わせ計算式
1 − (n−cCk / nCk)で厳密に算出。 - リトライの威力: 一発合格率(Pass@1)が30%のモデルでも、5回の試行とテスト検証を挟めば90%以上の確率で動くコードに到達できる。
- EvalPlus[HumanEval+]: テストケースの甘さを補うため、テスト数を80倍(約764個)に強化した新基準。
単一関数の生成テストであるHumanEvalをマスターしたところで、次回はさらに実践的なソフトウェア工学の極限テスト「第10回:SWE-benchの衝撃!実務リポジトリのGitHub Issueを自律解決できるか」へと進みます!複数ファイルにまたがる本物のバグ修正をLLMはどう乗り越えるのか、じっくり紐解いていきます。お楽しみに!