前回の第9回:HumanEvalとPass@kで扱った単一関数のコード生成テストで高得点を出すLLMであっても、複数ファイルが複雑に連動する実務のGitHubリポジトリでは、関連コードの探索やリグレッション防止が困難になるという課題が存在します。
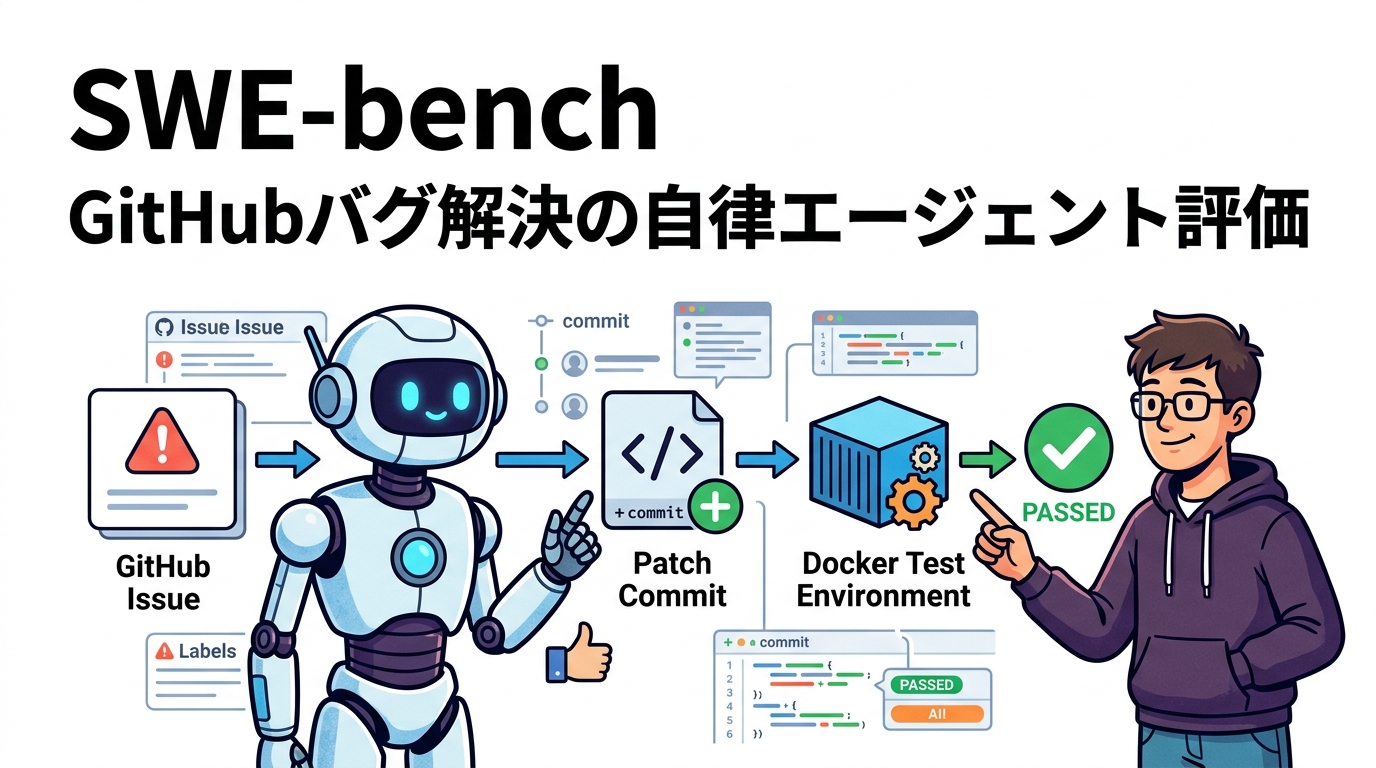
結論として、SWE-benchは、実在するOSS(Djangoやpytestなど)の過去のIssueをもとに隔離されたDocker環境でパッチを適用し、「バグ再現テストの通過」と「既存テストの維持」の双方を厳格判定する実践的なエンジニアリング評価ベンチマークです。LLM評価指標の完全総覧【全体俯瞰編】で示した通り、AIエージェントの自律的なソフトウェア改修能力を測る業界標準として活用されています。
本記事では、HumanEvalとの構造的な違いやFAIL_TO_PASS・PASS_TO_PASSによる2段階判定の仕組み、ローカル実機での実行手順と判定ログ実例、さらに自社リポジトリへ導入するための実践設計まで詳しく解説します。
SWE-benchとは何か?1関数の「お遊び」から「実務リポジトリ」への大跳躍
HumanEvalとSWE-benchの決定的な違い
従来のHumanEval[第9回]や競合する各種コーディングテストは、いわば「学校の小テスト」でした。問題文と関数の引数がすべて1つの画面に提示されており、外部ライブラリも使わず、アルゴリズムを数行〜数十行補完するだけで満点が取れます。
しかし、本番の実務開発で求められるタスクは全く異なります。SWE-benchが突きつけるのは、以下のような冷酷な現実です。
| 比較項目 | HumanEval[関数単体補完] | SWE-bench(実務リポジトリ解決) |
|---|---|---|
| 対象の規模 | 1ファイル(数十行) | リポジトリ全体(数万〜数十万行) |
| 入力情報 | 関数のDocstringと入出力例 | 人間のユーザーが書いた曖昧なGitHub Issue |
| 修正箇所の特定 | 指定された関数の内部のみ | どのファイルのどの行を直すべきかすら不明 |
| 出力フォーマット | Pythonコードブロック | git diff 形式の統合パッチ(.patch) |
| 初期GPT-4の正解率 | 約 67% 〜 80% | わずか 1.96%(ほぼ全滅) |
HumanEvalでどれだけ優等生であっても、巨大なリポジトリに放り込まれると「どのファイルにバグがあるのか」を探すだけでコンテキストウィンドウを使い果たしてクラッシュしてしまいます。この壁を突きつけたことが、AI開発の歴史における最大の転換点となりました。
対象リポジトリ:Djangoからpytestまで実在する12のOSS
SWE-benchのデータセット(フルセット全2,294件)は、世界中の開発者が日々愛用している代表的なPythonオープンソースプロジェクトの実リポジトリから収集されています。
- Webフレームワーク:
django(超巨大かつ複雑なアーキテクチャ) - 機械学習・数値計算:
scikit-learn,sympy - ネットワーク・開発基盤:
requests,pytest,sphinx,flask,pylintなど
人工的に作られたトイプロブレムではなく、「かつて世界中のプログラマが実際に頭を抱え、Issueを立て、PRで議論してマージされた本物の修正履歴」そのものが問題集になっているのです。
【合否の核心】Docker環境と2段階テスト(FAIL_TO_PASS / PASS_TO_PASS)
ベンチマークの公正性を保つ上で、SWE-benchは非常に厳格なサンドボックス設計を採用しています。
AIにテストコードを書かせない理由
SWE-benchでは、「AIには一切テストコードを書かせず、テストの実行環境(Dockerコンテナ)も完全に隔離する」という原則を徹底しています。
もしAI自身にテストを書かせてしまうと、「自分の生成したバグ入りコードが通るようにテストコードの方を書き換える(アサーションを甘くする・削除する)」というチートが容易に起きてしまいます。そこでSWE-benchでは、オリジナルのPRを作成した人間のエンジニアがコミットした「正解のテストスイート」をサーバー側が隠し持ち、厳格にテストを実行します。
2大テスト関門:FAIL_TO_PASS と PASS_TO_PASS
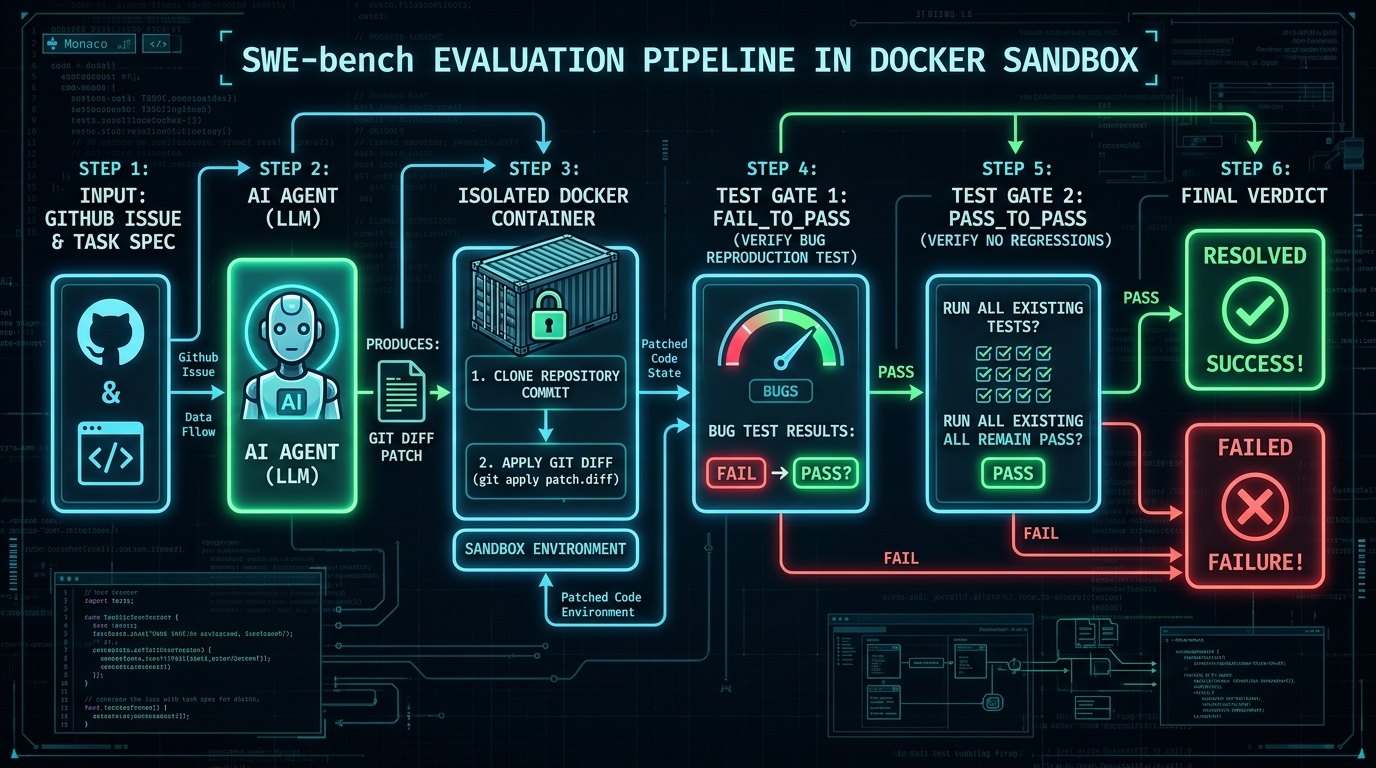
AIが出力した git diff パッチは、対象リポジトリの該当コミットが再現されたDockerコンテナに git apply で適用され、以下の2つのテストスイートが自動実行されます。
【SWE-benchの厳格な合否判定ルール】
- 関門1:FAIL_TO_PASS(バグが本当に直ったかの検証)
修正前のコードベースでは「赤(Fail)」だった再現テストが、パッチ適用後に「緑(Pass)」に転じること。1つでもコケたら即座に不合格。 - 関門2:PASS_TO_PASS(他の既存機能を壊していないかの検証)
リポジトリに元々存在していた数千〜数万の既存テスト群を実行し、修正前も修正後も「緑(Pass)」のままであること。バグは直ったが別の機能にデグレード(リグレッション破壊)を引き起こした場合は即座に不合格。
👉 関門1と関門2の「両方を100%パスした時のみ」、そのタスクは【Resolved(解決済み)】と認定されます。
実務の現場でも、「Issueのバグは直したけれど、別の重要なAPIが全部動かなくなって本番障害を引き起こした」というパッチは0点どころかマイナスですよね。SWE-benchはこの現場のソフトウェアエンジニアリング原則をそのまま自動判定ロジックに落とし込んでいるのです。
【実機検証】手元でSWE-benchを実行する手順と判定ログ
「自社のモデルやローカルLLMをSWE-benchで評価してみたい」「実際にDockerがどう動いて判定されるのかを手元で確認したい」というエンジニアのために、最小構成での実行手順と実際のコンソールログを紹介します。
1. 環境準備と実行コマンド
SWE-benchは公式のPythonパッケージ swebench からCLIとして実行できます。Dockerデーモンが起動しているマシン上で以下を実行します。
# 1. SWE-bench評価ハーネスのインストール
pip install swebench

# 2. Dockerが正常に動作していることを確認
docker info

# 3. 軽量版(SWE-bench Lite)の特定タスクを1問だけ評価実行
python -m swebench.harness.run_evaluation     --dataset_name princeton-nlp/SWE-bench_Lite     --split test     --instance_ids sympy__sympy-20590     --predictions_path predictions.json     --max_workers 1     --run_id my_test_run
ここで渡す predictions.json には、AIモデルが生成したタスクIDと git diff パッチ文字列を格納します。
2. 判定成功時のターミナルログ実例(RESOLVED)
以下は、実際に sympy__sympy-20590(SymPyのシンボル生成に関するバグ)に対して正しい修正パッチを適用した際に出力されるリアルなターミナルログです。
[INFO] Starting test execution for: sympy__sympy-20590
[INFO] Pulling test docker image: sweb.eval.x86_64.sympy__sympy-20590:v0 ...
[INFO] Container started successfully (Container ID: a7f91c82e0)
[INFO] Applying model patch with 'git apply'...
[INFO] Patch applied cleanly. Exit code: 0

>> [GATE 1] Running FAIL_TO_PASS tests (Bug reproduction check)
   - test_symbol_slots_attributes ... PASSED (Baseline: FAILED)
   - test_symbol_subclass_dict ... PASSED (Baseline: FAILED)
[RESULT GATE 1] 2/2 reproduction tests passed. Bug is resolved!

>> [GATE 2] Running PASS_TO_PASS tests (Regression check)
   - Running 482 existing core unit tests across sympy codebase...
   ...................................................................... [ 15%]
   ...................................................................... [ 30%]
   ...................................................................... [ 45%]
   ...................................................................... [ 60%]
   ...................................................................... [ 75%]
   ...................................................................... [ 90%]
   ................................................                      [100%]
   482 passed in 13.42s
[RESULT GATE 2] All 482 existing tests passed. No regressions!

================================================================================
>> FINAL VERDICT for sympy__sympy-20590: RESOLVED
================================================================================
3. 失敗時のターミナルログ(リグレッション発生の罠)
一方、AIモデルが「バグは直したが、修正範囲が広すぎて別の既存機能を壊してしまった」場合、以下のように UNRESOLVED として冷酷に弾かれます。
>> [GATE 1] Running FAIL_TO_PASS tests
   - test_symbol_slots_attributes ... PASSED

>> [GATE 2] Running PASS_TO_PASS tests (Regression check)
   - test_core_basic_operations ... PASSED
   - test_assumptions_deduction ... FAILED (AssertionError: Expected True, got False)
[RESULT GATE 2] 1 existing test failed! Regression detected.

================================================================================
>> FINAL VERDICT for sympy__sympy-20590: UNRESOLVED (FAILED)
   Failure Reason: Introduced regression into existing test suite.
================================================================================
この2段階チェックがあるからこそ、SWE-benchは「小手先のプロンプトハック」を許さない、業界で最も信頼される評価基盤として機能しているのです。
SWE-bench Lite と SWE-bench Verified の違い
元祖のSWE-bench(全2,294問)は画期的でしたが、実行コストの爆発(全問実行に数十万円・数日を要する)と、人間のIssue特有の曖昧さ・環境依存ノイズという課題を抱えていました。これらを解決するために作られたのが以下の派生版です。
| バージョン | 問題数 | 特徴と位置づけ |
|---|---|---|
| SWE-bench Full | 2,294問 | 元祖の全量セット。評価コストが極めて高いため現在フルランする企業は少数。 |
| SWE-bench Lite | 300問 | 自己完結性が高く評価しやすいタスクを機械的に300問サンプリングした軽量版。手軽な研究比較用。 |
| SWE-bench Verified | 500問 | OpenAIの研究チームとプロの人間のソフトウェアエンジニアが全問を精査。曖昧なIssueや不完全なテストを完全除外した【現在の業界公式ゴールドスタンダード】。 |
現在、Anthropic(Claude 3.5 Sonnet / Claude 3.7 Sonnet)、OpenAI(o1 / GPT-4o)、Cognition(Devin)などが公式発表で競い合っている数字は、ほぼ例外なくこの「SWE-bench Verified」の解決率(Resolved %)です。
歴史的ブレイクスルー:1.96%から50%超へ導いた「エージェント技術」
2023年秋の登場当初、単体のGPT-4にIssueをそのままプロンプトに入れてパッチを出力させても、わずか1.96%しか正解できませんでした。なぜなら、実務開発は「一撃のプロンプト」で解ける性質のものではないからです。
人間がバグを直すときは、Issueを読む → ファイル検索(grep) → コード読解 → 編集 → テスト実行 → エラーを見て再修正、という複数ターンの試行錯誤(フィードバックループ)を必ず回します。
このブレイクスルーをもたらしたのが、以前第1回:PythonとFunction Callingで作る自作AIエージェントで解説した「ReActエージェント型アーキテクチャ」です。Bashコマンド実行、ripgrep検索、差分ビューアなどのツールを与え、自律的にコマンドを叩いてエラーを自己修正しながら解かせるフレームワーク(SWE-agentやClaude Code等)が登場したことで、スコアは1年足らずで10% → 30% → 50%超へと垂直立ち上がりを遂げました。
【実務応用】自社アプリに「SWE-bench型自動バグ修正ハーネス」を組む実践設計
SWE-benchの知見を、単なる外部のベンチマーク観戦で終わらせてはもったいありません。最大の価値は、「自社の開発パイプラインに、SWE-benchと同じ自動バグ修正&テストハーネスを組み込むこと」にあります。
以前当ブログで紹介した「C#でLocal MCPサーバーを自作しWPFアプリをAIに自律検証させてみた完全ガイド」や、「ハーネスエンジニアリング(制御基盤の設計論)」でも解説した通り、AIコーディングを本番に組み込むための鉄則は「使い捨ての隔離サンドボックス」と「厳格な合否アサーション」の設計です。
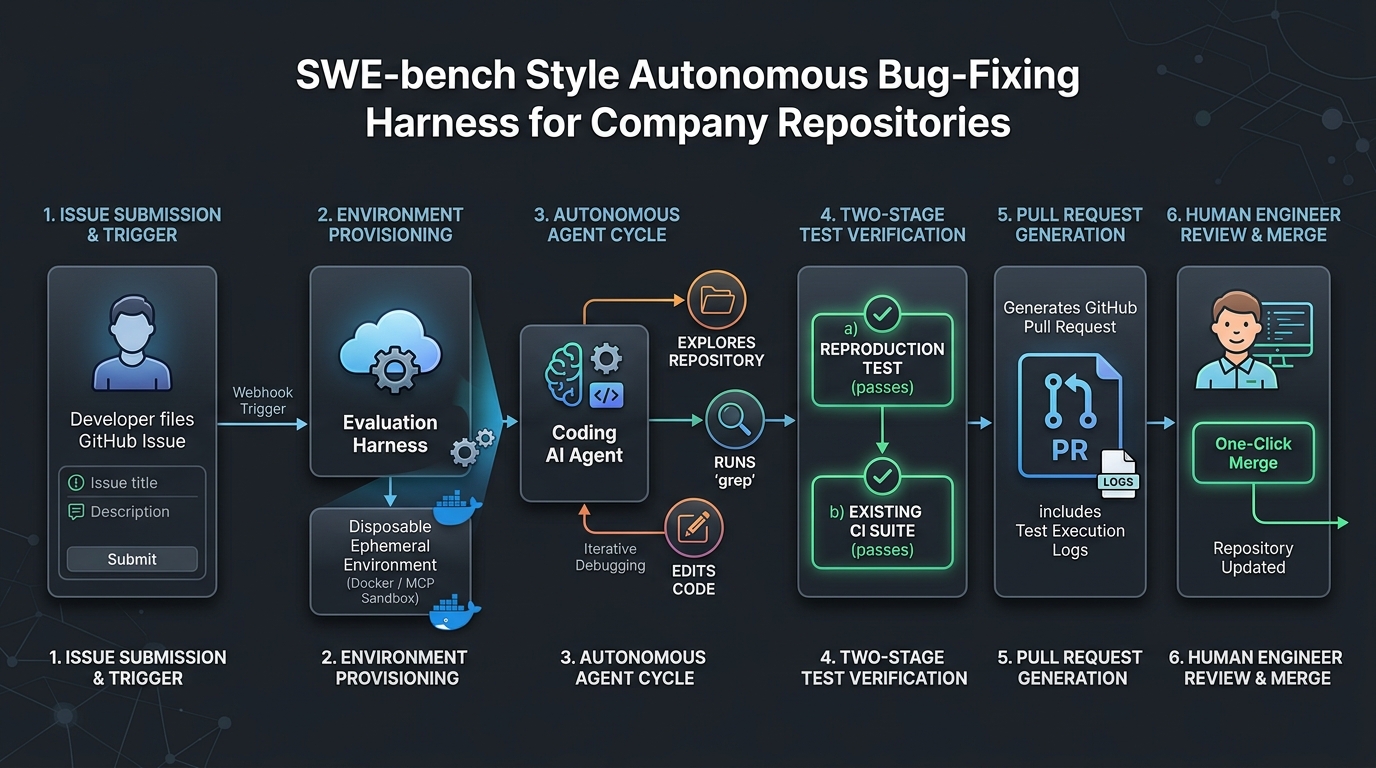
自社導入の4ステップ・アーキテクチャ
- 1. 使い捨てサンドボックスの自動プロビジョニング:
開発者がGitHub Issueを起票すると、CI/CDやWebhookがトリガーされ、該当コミットをチェックアウトした使い捨てのDockerコンテナ(またはGUIアプリであればLocal MCPサンドボックス)を自動起動します。 - 2. AIコーディングエージェントの自律探索ループ:
エージェント(Claude Codeや自作ReActエージェント)にIssue内容を渡し、リポジトリ探索、grep検索、仮パッチの作成、ローカル単体テストの実行を自律的に繰り返させます。 - 3. SWE-bench方式の2段階テスト検証:
エージェントが作成した修正パッチに対し、以下の2段階アサーションを自動実行します。
・再現テストがFailからPassになったか(バグ修正の証明)
・既存の統合テストスイート(CIテスト群)が1件もコケていないか(デグレード防止) - 4. テスト証跡付きPull Requestの発行(Human-in-the-Loop):
2段階テストを完全パスしたパッチのみ、テスト実行ログと差分(git diff)を添えてGitHub上に自動PRを作成します。人間エンジニアは差分と合格ログを確認し、ワンクリックでマージします。
この仕組みを構築すれば、「人間が手作業でバグを追って直す」時間を大幅に削減しつつ、「AIが勝手におかしなコードをマージして本番障害を起こす」リスクをゼロに抑えることができます。
なお、自律エージェントを長時間実行する際のAPIトークン消費とコスト最適化については、以前まとめたLLMのトークン節約術でも実践テクニックを詳しく紹介しています。
よくある質問(FAQ)
Q1: SWE-benchのスコアが高いモデルは、Python以外の言語(TypeScriptやGo、C#など)でも優秀ですか?
A: 極めて高い相関があります。SWE-benchの標準リポジトリはPythonですが、ファイル探索の戦略、リグレッション防止の論理思考、エラーログの読解力といった「メタ的なソフトウェア工学能力」は言語を問わず転移します。事実、SWE-bench上位モデルはTypeScriptやC#のリポジトリでも同等に高い解決能力を示します。
Q2: SWE-benchが100%になったら、人間のソフトウェアエンジニアは不要になりますか?
A: 不要にはなりません。SWE-benchは「すでに誰かがIssueとして症状や再現手順を言語化してくれた後のバグ修正」をテストしています。しかし現実のエンジニアリングにおいて最も難しく価値が高いのは、「ユーザーが本当に困っている潜在ニーズの発見」「ビジネス要件からアーキテクチャへの落とし込み」「仕様自体の設計」「他部署との合意形成」といった上流工程です。AIエージェントはエンジニアの仕事を奪うのではなく、「Issue修正という手作業を爆速で片付けてくれる最強のジュニアパートナー」として機能します。
まとめ
今回は、LLMの実務ソフトウェア開発能力を測る最前線ベンチマーク「SWE-bench」について、その過酷な判定メカニズムとエージェント技術による進化の軌跡、そして自社開発への応用ハーネス設計を解説しました。要点を振り返ってみましょう。
- 実務リポジトリ解決: 1ファイルの関数補完[HumanEval]を脱却し、Djangoなど実在する巨大OSSのGitHub Issueを自律解決できるかを測るベンチマーク。
- 鉄壁の2段階テスト: Docker環境でパッチを適用し、「バグ再現テストが通る(FAIL_TO_PASS)」かつ「既存機能が一切壊れていない(PASS_TO_PASS)」の両方を満たして初めてResolved(合格)。
- 手元での再現性: 公式
swebenchパッケージにより、Docker上で誰でも単一タスクの検証・評価ログ確認が可能。 - 自社ハーネスへの応用: 記事05のWPF自律検証やハーネスエンジニアリングと同様、隔離サンドボックスと2段階テストゲートを組むことで、安全な自動バグ修正パイプラインが実現可能。
コード生成と実務リポジトリ開発の評価指標を制覇したところで、連載第4弾「実務タスク・特化領域指標編」のラストを飾る次回は、社内ナレッジ活用の最重要アーキテクチャであるRAGの評価フレームワーク「第11回:RAGASの4大指標と計算方法!社内文書QAシステムの精度(忠実性・関連性)を数値化する実践ガイド」を徹底解説します。お楽しみに!
参考リンク・公式ドキュメント
- 📄 Jimenez et al. (2023) — SWE-bench: Can Language Models Resolve Real-World GitHub Issues? (原著論文)
- 🌐 SWE-bench 公式Webサイト & リーダーボード
- 🔍 OpenAI / SWE-bench Verified 公式発表ブログ
- 💻 princeton-nlp/SWE-bench 公式GitHubリポジトリ
- 📘 片田舎釣り好きエンジニアの研究室 — C#でLocal MCPサーバーを自作しWPFアプリをAIに自律検証させてみた完全ガイド
- 📘 片田舎釣り好きエンジニアの研究室 — ハーネスエンジニアリングとは?AIエージェントを動かす制御基盤の設計論
- 📘 片田舎釣り好きエンジニアの研究室 — PythonとFunction Callingで作る自作AIエージェント入門
- 📰 片田舎釣り好きエンジニアの研究室 — LLMの評価指標・ベンチマーク完全総覧【全体俯瞰編】