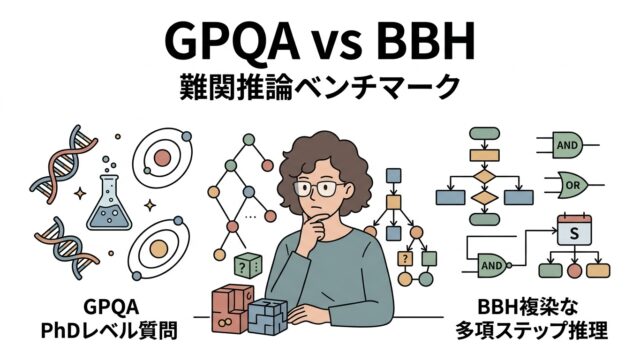
AI・機械学習 GPQAとBBHの凄さ!最先端LLMの推論限界を暴く博士レベルベンチマーク 最先端LLMの推論限界を検証するGPQAとBBHの出題構造を紐解くガイド。博士号保持者が設計したGoogle検索耐性を持つ448問の極限テストや、言語モデルが躓く23の難関タスクからAIの実力を見極める視点を示します。 2026.09.11 AI・機械学習AI活用
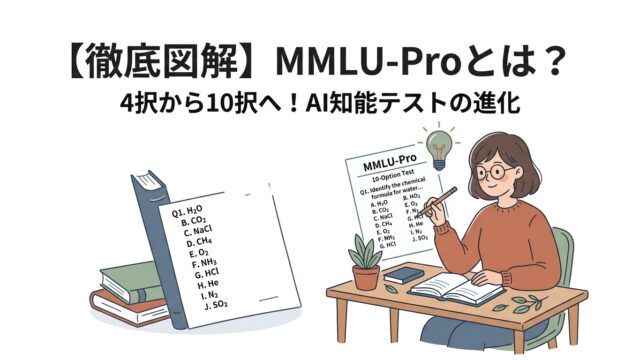
AI・機械学習 MMLUとMMLU-Proの違いを徹底解説!10択化とCoTで測る真の実力 AIモデルの知識量を測る代表指標MMLUと後継ベンチマークMMLU-Proの構造的違いを比較。4択から10択への拡大による当てずっぽうの排除、思考連鎖(CoT)の必須化など、真の推論能力を測定する仕組みを紐解きます。 2026.09.09 AI・機械学習AI活用
 AI・機械学習 AI・機械学習
 AI・機械学習