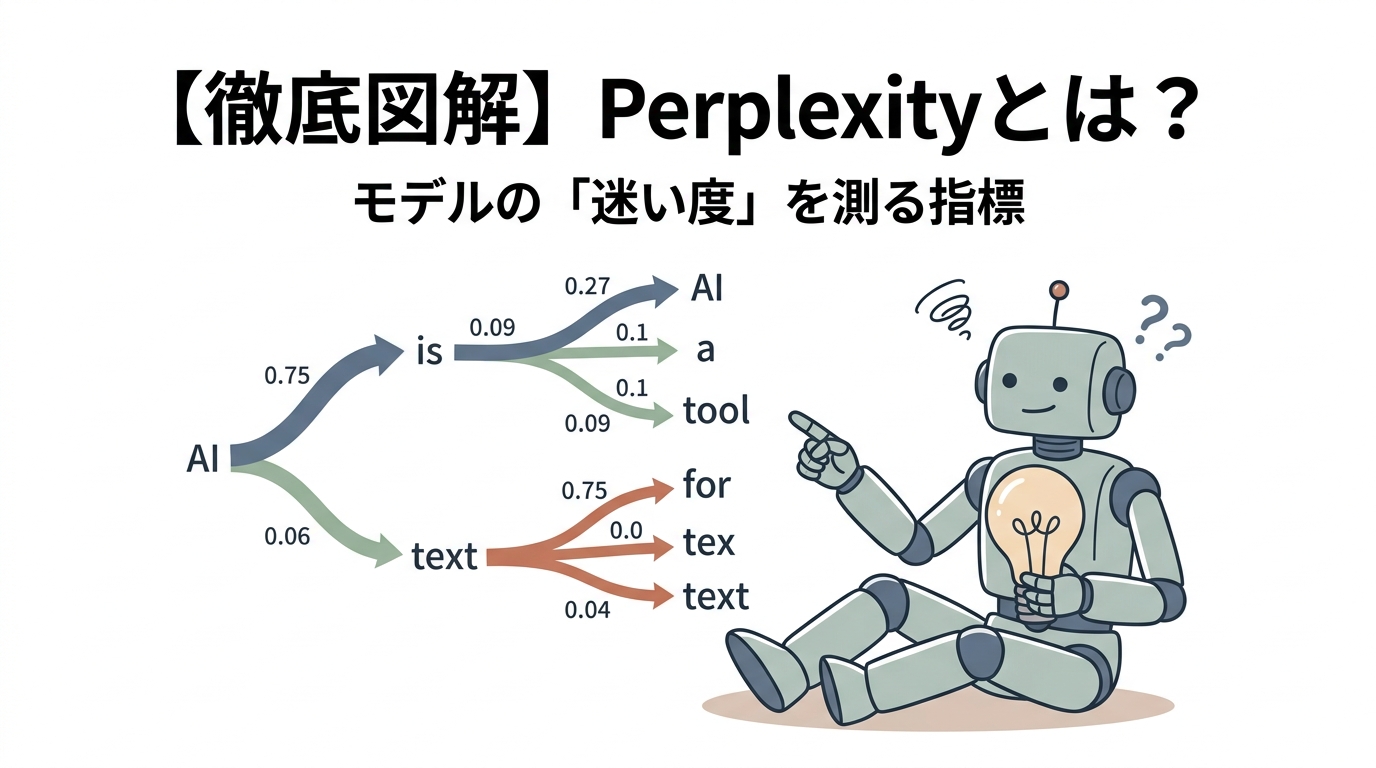
LLM(大規模言語モデル)の技術論文やオープンモデルのリリースノートを読んでいると、必ずと言っていいほど目にする「Perplexity(パープレキシティ:PPL)」という指標。「名前はよく見かけるけれど、数式が難しそうで具体的に何を意味しているのかピンとこない…」「どう計算されているのか直感的に理解したい」と感じたことはないでしょうか?
先日公開したLLMの評価指標・ベンチマーク完全総覧【全体俯瞰編】でも触れましたが、PerplexityはあらゆるLLM評価の中で最も土台に位置する「基本中の基本」となる指標です。最新のフロンティアモデルが競い合う応用ベンチマークを見る前に、まずこの足腰となる指標を理解しておくことが欠かせません。
結論から言えば、Perplexityとは「モデルが次の単語を予測するとき、平均して何択のくじ引きで迷っているか」を数値化したものです。この記事では、数式が苦手な方でもスッキリ納得できるように、身近な具体例と分かりやすい数値シミュレーションを交えながら、計算方法から実務での活用法、そして絶対に知っておくべき落とし穴まで徹底解説します!
Perplexity(PPL)とは何か?「モデルの迷い度」を直感的に理解する
「平均何択で迷っているか」を示すサイコロの例え
Perplexity(パープレキシティ)という英単語は、直訳すると「当惑」「困惑」「複雑さ」といった意味を持っています。AI・自然言語処理の世界では、モデルが文章を読み書きする際に「どれくらい次に続く言葉に困惑しているか(迷っているか)」を表す尺度として使われています。
一番イメージしやすいのは「くじ引き」や「サイコロ」の例えです。例えば、あなたが日本語の文章を読んでいて「昔々、あるところに、おじいさんとおばあさんが[ ]」という空欄に出会ったとしましょう。日本人であれば、ほぼ100%の確信で「住んでいました」と予想できますよね。このとき、あなたの頭の中にある選択肢は実質「1択」であり、迷いは全くありません。
もしLLMがこのときPerplexity = 1.0というスコアを出したとすれば、それは「迷いゼロ(1択で確信している)」状態を意味します。一方で、Perplexity = 10.0であれば「10面サイコロを振って10択の中から迷いながら選んでいる状態」、Perplexity = 1,000であれば「1,000本のくじ引きの中から当てずっぽうに近い感覚で迷っている状態」を意味するのです。
なぜ数値が「小さいほど優秀」なのか?
一般的なテストの点数(Accuracyなど)は100点に近いほど高い評価になりますが、Perplexityは逆で「数値が小さければ小さいほど優秀」な指標となります。理想的な最小値は「1.0」です。
その理由は極めてシンプルで、迷っている選択肢の数(当惑度)が少なければ少ないほど、その言語モデルは自然言語の文法規則や文脈、単語の出現パターンを深く学習できているとみなせるからです。
現代の高性能なLLMであれば、一般的なニュース記事や平易な文章を入力した際のPerplexityは数ポイントから十数ポイント程度にまで低く抑えられます。反対に、文法が滅茶苦茶な文章や、全く学習していない未知の専門用語の羅列を入力すると、モデルは次に何が来るか予測できなくなり、Perplexityの値は数百〜数千へと跳ね上がります。
【ステップ解説】Perplexityの計算方法と具体例シミュレーション
交差エントロピー損失(Cross-Entropy Loss)との数学的関係
「何択で迷っているか」という意味が掴めたところで、次は実際の計算ロジックを見てみましょう。難解な数式に見えるかもしれませんが、仕組みを順を追って分解すると非常に美しい構造をしています。
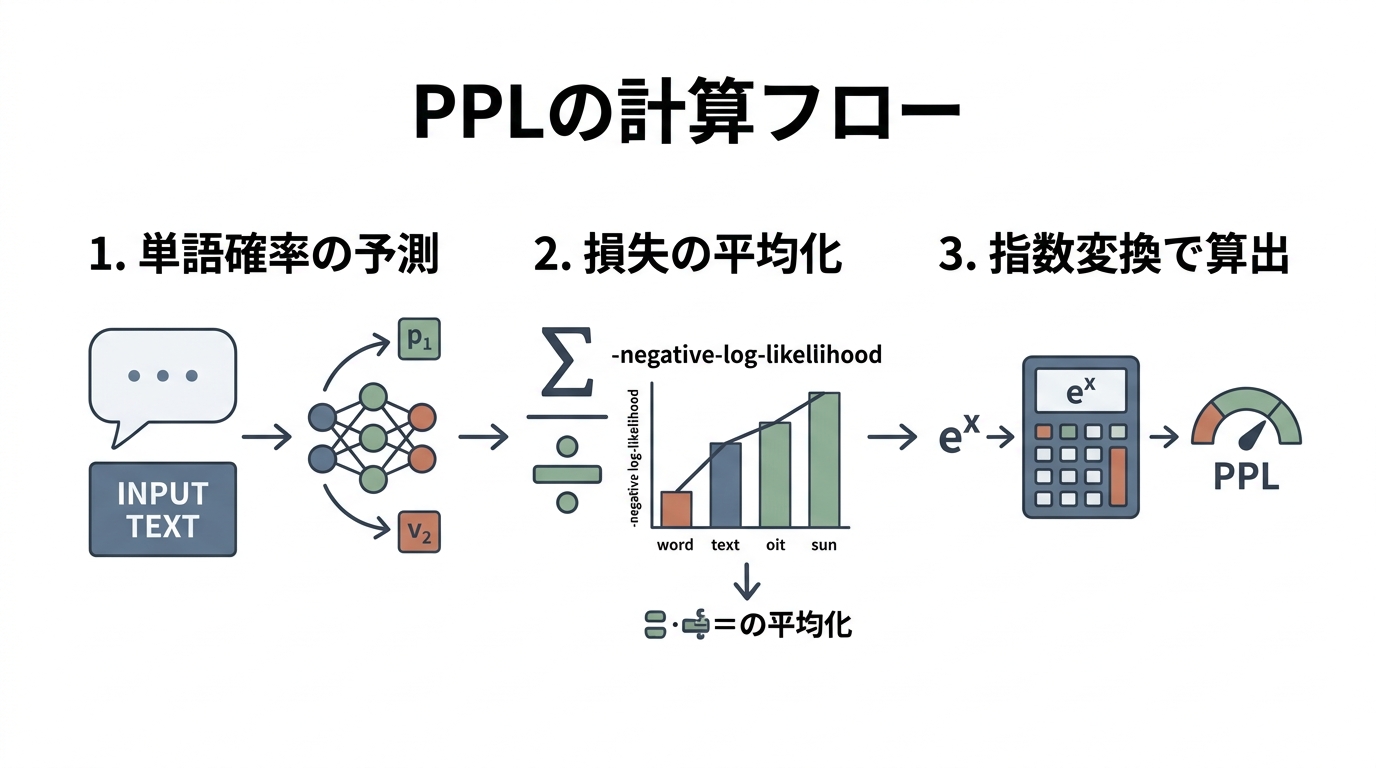
数学的な結論を先に言うと、Perplexity(PPL)は「平均クロスエントロピー損失(Loss)の指数関数」として定義されます。数式で表すと以下のようになります。
PPL = exp( 平均Loss ) = e平均Loss
ここで「e」はネイピア数(自然対数の底:約2.718)です。つまり、モデルの学習時に計算される損失値(Loss)が分かれば、それをeの肩に乗せるだけでPerplexityが求まります。逆に言えば、Perplexityの自然対数(ln)をとったものが平均Loss(ln(PPL) = 平均Loss)という表裏一体の関係にあるわけです。
具体例:「日本の首都は東京である」で計算してみよう
では、実際に5つのトークンで構成される「日本の / 首都は / 東京 / で / ある」という短い文章を例に、ステップ・バイ・ステップで計算してみましょう。
以前書いたLLMのトークン節約術でも解説したように、LLMは文章全体を一度に生成しているのではなく、過去の文脈から「次の1トークン」の生起確率を順番に予測しています。モデルが予測した各トークンの確率が以下のようになったと仮定します。
| ステップ | 文脈(入力) | 予測対象トークン | モデルの予測確率 P | 各ステップのLoss: -ln(P) |
|---|---|---|---|---|
| 1 | (文頭) | 日本の | 0.40 | 0.916 |
| 2 | 日本の | 首都は | 0.70 | 0.357 |
| 3 | 日本の首都は | 東京 | 0.85 | 0.163 |
| 4 | 日本の首都は東京 | で | 0.80 | 0.223 |
| 5 | 日本の首都は東京で | ある | 0.75 | 0.288 |
計算手順は以下の3ステップです。
- 各ステップの損失計算: 予測確率 P に対して、マイナスの自然対数「-ln(P)」を計算します。確率が100%(1.0)に近いほど損失は0に近づき、確率が低いほど損失は急激に増大します。
- 平均損失の算出: 全5ステップの損失を合計して平均を出します。
平均Loss = (0.916 + 0.357 + 0.163 + 0.223 + 0.288) ÷ 5 = 約0.389 - 指数関数でPerplexityへ変換: 得られた平均Lossをeの指数に乗じます。
PPL = exp(0.389) = e0.389 ≒ 1.48
この結果から、このモデルは「日本の首都は東京である」という文を処理する際、平均して「約1.48択」という極めて高い確信度で正解トークンを選び出せていることが分かります。数字で見ると、Perplexityがいかに直感的で分かりやすい指標であるかが実感できますよね。
💡 あわせて読みたい
実務におけるPPLの活用シーンと「2つの大きな落とし穴」
実務での主な活用シーン(事前学習・蒸留・量子化の検証)
理論上の仕組みが分かったところで、私たちエンジニアが実務の開発現場でPerplexityをどのような場面で活用するのかを整理してみましょう。主に以下の3つのシーンで大活躍します。
- 事前学習・ファインチューニングの収束監視: 学習中にテストデータに対するPPLをプロットすることで、モデルが順調に言語パターンを吸収しているか、あるいは過学習(Overfitting)を起こしていないかをリアルタイムに監視できます。
- モデル圧縮・量子化(Quantization)の影響測定: FP16の重みをINT8やINT4、GGUF形式などに圧縮した際、「どれくらい言語能力が劣化したか」をWikiTextなどの標準データセットでPPLの変化を測ることで客観的に評価できます。
- ドメイン適応度のチェック: 医療や法律、社内特有の専門用語を含むテキストに対してPPLを測ることで、自社のファインチューニングモデルがそのドメイン言語にどれだけ馴染んだかを即座に判断できます。
落とし穴①:トークナイザーが異なるとモデル間で比較できない
非常に便利に見えるPerplexityですが、現場で絶対にやってはいけない重大な注意点があります。それが「異なるトークナイザーを持つモデル同士のPPLを直接比較してはならない」という原則です。
例えば、あるモデルAは「人工知能」を1つのトークンとして扱い、別のモデルBは「人工」「知能」と2つのトークンに分割したとします。Perplexityは「トークン1つあたりの平均損失」を計算するため、トークンの区切り方(語彙数やBPEルール)が変わると、たとえ全く同じ文章であっても計算の分母と確率分布が変わり、数値の基準そのものがズレてしまいます。
したがって、「Llama-3のPPL」と「MistralのPPL」を直接突き合わせてどちらが賢いかを競い合うことはできません。PPLの比較は、あくまで「同一のトークナイザー・語彙体系を持つ同一系統モデル(例: 元モデル vs 量子化モデル、学習前 vs 学習後)」の比較においてのみ有効である点に注意しましょう。
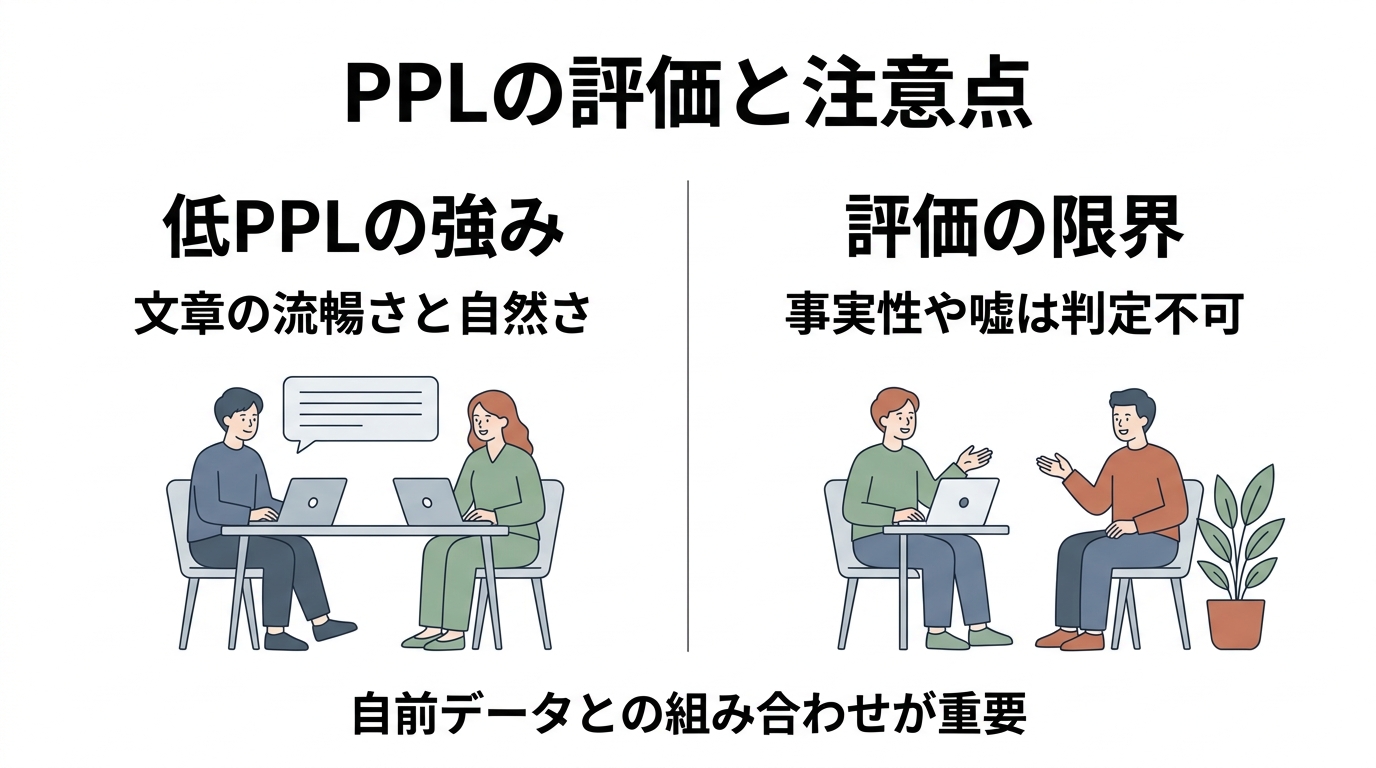
落とし穴②:PPLが低くても「流暢な嘘(ハルシネーション)」をつく
もう一つの決定的な限界は、「Perplexityは事実の正しさを一切保証しない」ということです。
Perplexityが評価しているのは、あくまで「統計的に自然な言葉のつながりになっているか」という点だけです。例えば、モデルが「織田信長は1945年に宇宙船で月へ行った」という文章を、文法的に完璧かつ自信満々な高い確率で生成した場合、Perplexityのスコアは非常に優秀な低数値(低PPL)を叩き出してしまいます。
つまり、「文章は驚くほど流暢だが、中身は完全なデタラメ」という、いわゆるハルシネーション(幻覚)をPerplexityだけで見破ることは不可能です。この事実性や論理的推論力を正しく検証するためには、後続の連載で解説するMMLU-ProやTruthfulQA、RAGASといった上位の専門ベンチマークを併用する必要があります。
PPLをどう使いこなすか?エンジニアとしての向き合い方
Perplexityは「血液検査」、総合知能テストではない
エンジニアとしてPerplexityと向き合う際、個人的には「人間の健康診断における血液検査」のようなものだと捉えるのが一番しっくりくると感じています。
血液検査の数値に異常があれば「どこか体に不調がある」とすぐに分かりますし、健康状態の基礎ベースラインを把握するのには最適ですよね。しかし、血液検査の数値がどれほどオールAであっても、その人が「プログラミングができるか」「高度な経営判断ができるか」までは分かりません。
LLMも全く同じです。Perplexityが悪ければ、モデルの重みが壊れていたり、量子化で激しい劣化が起きていることが一発で検知できます。しかし、PPLが良いからといって、ユーザーの複雑なプロンプトに従える実務力があるとは限らないのです。
「自前テストデータでのPPL計測」を武器にしよう
だからこそ、実務では公開された一般的なデータセット(WikiTextなど)でのPPLを眺めるだけでなく、「自社の実際の業務テキストやログデータをテストセットとして用意し、そこでのPPLを計測する」という使い方が非常に強力な武器になります。
自社ドメインの文章に対してベースモデルのPPLが25だったものが、LoRAなどの追加学習によって12まで下がったとすれば、それはモデルが確実に自社の業務用語や言い回しに適応した動かぬ証拠となります。このように、基礎のバロメーターとして正しく使いこなすことこそが、エンジニアとしての第一歩と言えるでしょう。
まとめ
今回は、LLM評価の最も根幹に位置する重要指標「Perplexity(PPL:パープレキシティ)」について、その直感的な意味から計算の仕組み、実務での勘所までを詳しく紐解いてきました。要点を振り返ってみましょう。
- 直感的な意味: モデルが次に来る単語を予測するとき「平均して何択の選択肢で迷っているか」を示す数値。数値が小さく1.0に近いほど優秀。
- 計算の仕組み: 各ステップの予測確率から求めた「平均クロスエントロピー損失」をネイピア数の指数に乗じたもの(PPL = exp(Loss))。
- 実務での役割: 事前学習の進捗確認、モデル量子化による劣化測定、ドメイン適応度のチェックにおいて最も頼りになる基礎バロメーター。
- 2大注意点: トークナイザーが異なるモデル間では比較できないこと、そして「流暢な嘘(ハルシネーション)」はPPLでは検知できないこと。
Perplexityという基礎体力を理解したところで、次回は機械翻訳や要約タスクの定番指標である「第2回:BLEUとROUGEの違いと計算方法」について、N-gram一致率の具体例を交えて解説していきます!ぜひ楽しみにしていてくださいね。
💡 あわせて読みたい