近年、GitHub上のオープンソースリポジトリやnpm・PyPI等のパッケージエコシステムにおいて、「不可視Unicode文字(ゼロ幅文字)」を悪用した極めて巧妙なコード難読化・サプライチェーン攻撃が相次いで報告されています。
一見するとソースコード上はconst payload = "";という無害な空文字列にしか見えないのに、テキストエディタの背後には何万文字ものゼロ幅文字(バイナリデータ)が潜んでおり、実行時に外部からマルウェアを取得・実行するバックドアとして機能します。
なぜ人間の目や通常のコードレビュー、さらには一般的なテキスト検索(grep)ですらこの攻撃を検知できないのでしょうか?その核心は、私たちが日常的に利用している「UTF-8」という文字コードの物理的なバイト構造とUnicode仕様にあります。
本記事では、インフラ・Webエンジニアが必ず知っておくべきUTF-8の可変長バイトの仕組みから、ゼロ幅文字(U+200B等)のHexダンプ実測検証、VSCodeにおける完全可視化設定、そしてCI/CDやGit Pre-commitでバックドア混入を自動遮断するPython検知コードまで、現場で即座に役立つ一次情報と防御策を徹底解説します。
1. UTF-8とは?エンジニアが押さえておくべき可変長エンコーディングの本質
Web開発やシステムプログラミングにおいて、UTF-8は世界のWebページの98%以上で採用されているデファクトスタンダード(事実上の標準)です。しかし、「Unicode」と「UTF-8」の概念の違いや、なぜ可変長設計になっているのかを正確に説明できるでしょうか。まずは文字コードの基本骨格を整理します。
Unicode(文字集合)とUTF-8(符号化方式)の決定的な違い
文字コードの議論で最も混同されやすいのが「Unicode」と「UTF-8」です。この2つは以下のように役割が明確に分かれています。
| 概念 | 分類 | 役割と具体例 | 例え話 |
|---|---|---|---|
| Unicode | 文字集合(Character Set) | 世界中の文字や記号、制御文字に一意な「背番号(コードポイント)」を割り当てた一覧表。 例:『A』= U+0041、『あ』= U+3042、『ゼロ幅スペース』= U+200B |
世界共通の「文字背番号名簿」 |
| UTF-8 | 文字符号化方式(Encoding Scheme) | Unicodeの背番号(コードポイント)を、コンピュータが記録・通信できる「0と1のバイト列」に変換する変換規則。 | 背番号を効率よく荷造り(圧縮・バイナリ化)する梱包ルール |
つまり、「Unicodeという規格番号があり、それをストレージやネットワーク上で無駄なく扱うための具体的なバイナリ表現形式がUTF-8」です。
1バイト〜4バイト可変長エンコーディングのビット仕様
UTF-8が爆発的に普及した最大の理由は、「ASCII(半角英数字)との100%完全上位互換」と「データ容量の最適化」を両立させた点にあります。
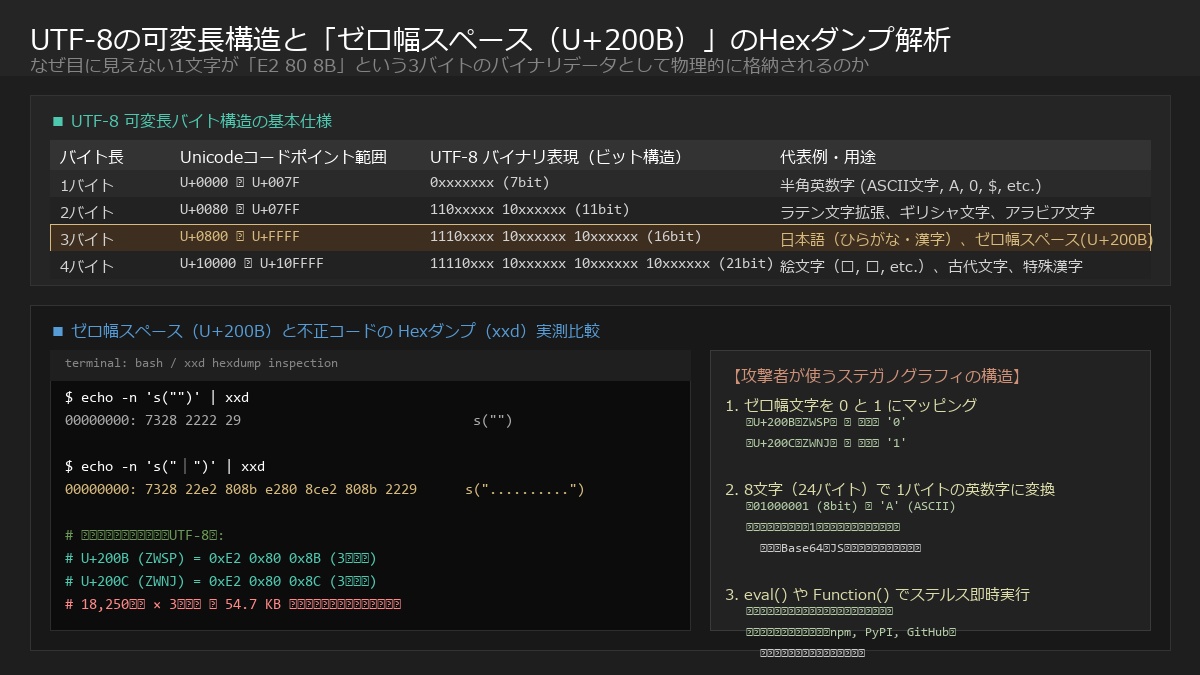
UTF-8は文字コードの範囲(コードポイント)に応じて、1バイトから最大4バイトまで動的にデータ長を変化させます。各バイトの先頭ビットを見るだけで、その文字が何バイト長で構成されているかが一意に判別できる美しいビット構造になっています。
| バイト数 | コードポイント範囲 | UTF-8 バイナリ表現(ビット構造) | 主な文字・記号の例 |
|---|---|---|---|
| 1バイト | U+0000 〜 U+007F |
0xxxxxxx(先頭が0で始まる7ビット) |
半角英数字、基本記号(ASCII互換) |
| 2バイト | U+0080 〜 U+07FF |
110xxxxx 10xxxxxx |
ギリシャ文字、キリル文字、ラテン文字拡張 |
| 3バイト | U+0800 〜 U+FFFF |
1110xxxx 10xxxxxx 10xxxxxx |
日本語(ひらがな、カタカナ、常用漢字)、ゼロ幅スペース(U+200B) |
| 4バイト | U+10000 〜 U+10FFFF |
11110xxx 10xxxxxx 10xxxxxx 10xxxxxx |
絵文字(😀, 🚀)、古代文字、サロゲートペア領域の漢字 |
英語圏のテキストはすべて1バイト(ASCIIと同じ)で収まるため、無駄なファイルサイズ肥大が起きません。一方で、日本語や中国語などの文字は3バイト、絵文字は4バイトとして同一ファイル内で共存できる柔軟性を持っています。
2. 【技術解剖】「見えないUnicode」を使った悪用手口とバイナリ検証
世界中の言語を網羅したUnicodeには、画面上に描画されない「不可視文字・フォーマット制御文字」が多数定義されています。攻撃者はこの仕様を悪用し、人間の視覚を完全に騙すバックドアを構築しています。
代表的な不可視Unicode文字とそのコードポイント
難読化やステガノグラフィ(隠蔽工作)によく使われる代表的な不可視文字には、以下のようなものがあります。
| 文字名称 | コードポイント | UTF-8 バイト列 | 本来の目的と仕様 |
|---|---|---|---|
| ゼロ幅スペース (ZWSP) | U+200B |
E2 80 8B |
単語の改行位置を示すが、幅を持たない不可視文字 |
| ゼロ幅非接合子 (ZWNJ) | U+200C |
E2 80 8C |
ペルシャ語などで文字同士が意図せず結合するのを防ぐ |
| ゼロ幅接合子 (ZWJ) | U+200D |
E2 80 8D |
絵文字の合成(👨👩👧👦など)やアラビア文字の結合を制御する |
| 左横書きマーク (LRM) | U+200E |
E2 80 8E |
双方向テキスト(アラビア語と英語の混在)の表示順を制御 |
| 右横書き強制 (RLO) | U+202E |
E2 80 AE |
テキストの描画方向を右から左へ反転(Trojan Source攻撃) |
Hexダンプ(xxd)によるバイナリレベルの実測検証
実際に、通常の空文字列と「ゼロ幅スペースが埋め込まれた文字列」がバイナリレベルでどう異なっているのか、ターミナルのxxdコマンドで検証してみましょう。
# 1. 通常の空文字列関数のHexダンプ
$ echo -n 's("")' | xxd
00000000: 7328 2222 29                             s("")

# 2. ゼロ幅文字(U+200B: ZWSP, U+200C: ZWNJ)が混入した文字列のHexダンプ
$ echo -n 's("\xe2\x80\x8b\xe2\x80\x8c\xe2\x80\x8b")' | xxd
00000000: 7328 22e2 808b e280 8ce2 808b 2229 s("..........")通常のテキストエディタやコンソール上では、どちらも全く同じs("")としか表示されません。しかし、後者のバイナリにはe2 80 8b(U+200B)やe2 80 8c(U+200C)という3バイトのUTF-8データがぎっしりと並んでいます。
攻撃者はどうやって不可視文字を実行コードに変換するのか?
冒頭で紹介したGitHubの不正コード事例では、18,250桁ものゼロ幅文字が埋め込まれていました。1文字あたり3バイト消費するため、これだけで約54.7 KBのデータ量になります。攻撃者はこの不可視文字を以下のようなアルゴリズムで復元・実行します。
| ステップ | 処理内容 | 技術的メカニズム |
|---|---|---|
| Step 1: 2進数マッピング | ゼロ幅文字をビット(0と1)に変換 | U+200B = 0U+200C = 1 として置換処理を行う |
| Step 2: バイト列の再構築 | 8ビットごとに1バイトの文字(ASCII)へ復元 | 01000001 ➡ 0x41 ➡ 文字『A』不可視文字列からBase64文字列やJSコードを完全再構築 |
| Step 3: ステルス動的実行 | 復元された悪意あるスクリプトを即時実行 | 難読化ローダー経由で外部のC2サーバーやWeb3コントラクト(Solana等)にアクセスし、本命マルウェアを展開 |
この手法の最も恐ろしい点は、「シグネチャベースのウイルス対策ソフトや静的解析ツール、GitHubのコードレビュー担当者の目をすべて同時に欺くことができる」点です。ソースコード上は危険な関数名やURLが一切平文で露出していないため、人間の目視レビューを軽々と突破してしまいます。
3. VSCodeによる完全防衛!不可視文字を一発で可視化する設定マニュアル
このような見えない脅威からプロジェクトを守るための第一歩は、開発者が日常的に使用しているエディタで「見えない文字を見える化」することです。
従来の「renderControlCharacters」だけでは防げない理由
これまで多くの技術記事で「VSCodeで制御文字を表示するには editor.renderControlCharacters: true を設定しよう」と紹介されてきました。しかし、この設定だけではゼロ幅スペース(U+200B)を完全に防ぐことはできません。
なぜなら、Unicode規格においてゼロ幅スペースは「制御文字(Control Characters: Ccカテゴリ)」ではなく、「フォーマット文字(Format: Cfカテゴリ)」や特殊スペースとして分類されているためです。制御文字設定だけをONにしていても、エディタ上では空白としてすら描画されず、完全に見落としてしまいます。
VSCodeの標準機能「Unicodeハイライト」の真価
VSCodeではバージョン1.63以降、悪意あるUnicode悪用(Trojan Source攻撃や不可視文字挿入)に対抗するため、「Unicode Highlight(Unicodeハイライト機能)」が標準実装されました。
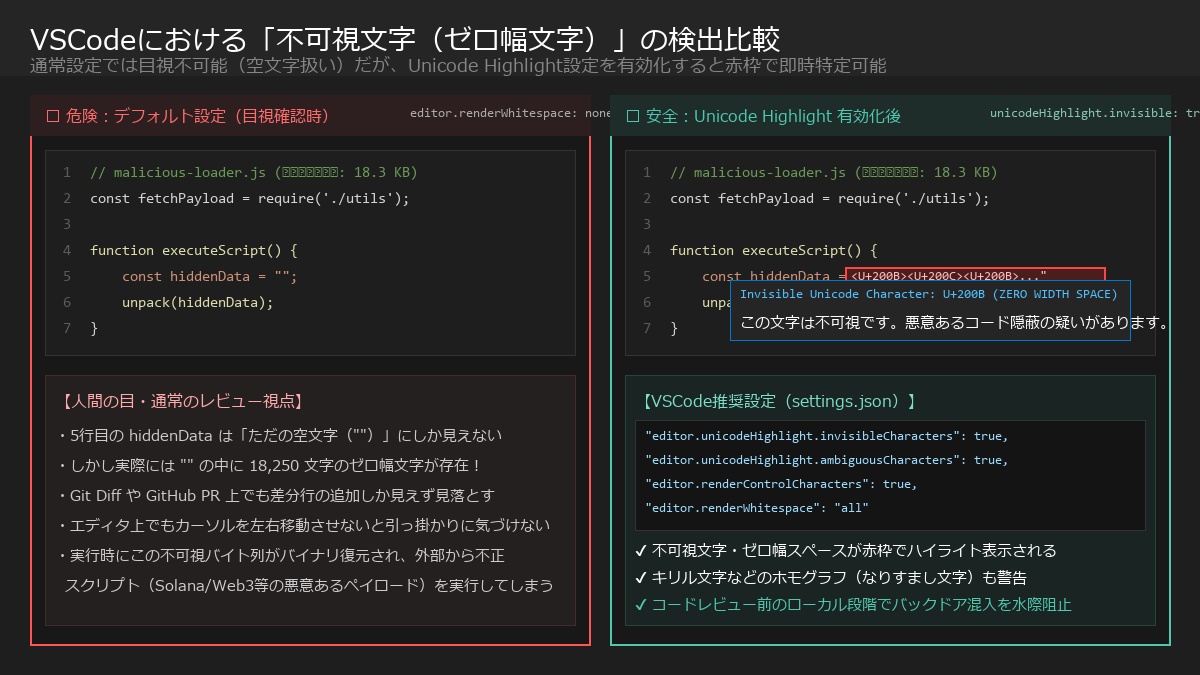
上記の比較図をご覧ください。左側のデフォルト設定ではただの空文字にしか見えないコードが、Unicodeハイライト機能を有効化することで、赤枠の警告ボックス(<U+200B>)として強烈に視覚化されます。カーソルを合わせると、「Invisible Unicode Character」という警告メッセージとコードポイントが明示され、不審なバックドアを瞬時に見抜くことができます。
VSCode設定(settings.json)の推奨構成
エンジニアが開発環境に今すぐ追加すべき settings.json の推奨設定は以下の通りです。
{
  // 不可視Unicode文字(ゼロ幅文字など)を強調表示する(最重要)
  "editor.unicodeHighlight.invisibleCharacters": true,

  // ASCII文字と紛らわしい類似文字(キリル文字のaなど:ホモグラフ攻撃対策)を強調表示
  "editor.unicodeHighlight.ambiguousCharacters": true,

  // 非ASCII文字全般の強調表示(日本語コメント等が多い場合はfalseで調整可能)
  "editor.unicodeHighlight.nonBasicASCII": false,

  // 制御文字(改行・タブ等以外の特殊コード)を視覚化
  "editor.renderControlCharacters": true,

  // 全ての半角スペース・タブを明示的にドット表示
  "editor.renderWhitespace": "boundary"
}
この設定を投入しておくだけで、外部からプルしたソースコードや、コピー&ペーストしたスニペットに不可視文字が混入していた場合、保存する前に一瞬で気づくことが可能です。
4. 現場導入!CI/CDパイプラインとGit Pre-commitによる自動検知スクリプト
エディタの設定はローカル環境における有効な防壁ですが、開発チーム全員が同じエディタを使っているとは限りません。チーム全体およびサプライチェーンを守るには、「コミット時」および「CI/CD(プルリクエスト時)」の自動検査パイプラインを構築することが必須です。
実装1: Pythonによる不可視・危険Unicode文字スキャンツール
リポジトリ内のソースコードを再帰的に走査し、ゼロ幅文字や危険な双方向テキスト制御文字(Trojan Source)を検出して行番号と文字コードを出力するPythonスクリプトです。外部ライブラリ不要で、標準ライブラリのみで即座に動作します。
import os
import sys
import unicodedata

# 検出対象とする危険な不可視・制御文字のUnicode符号位置
SUSPICIOUS_CODEPOINTS = {
    0x200B: "Zero Width Space (ZWSP)",
    0x200C: "Zero Width Non-Joiner (ZWNJ)",
    0x200D: "Zero Width Joiner (ZWJ)",
    0x200E: "Left-to-Right Mark (LRM)",
    0x200F: "Right-to-Left Mark (RLM)",
    0x202A: "Left-to-Right Embedding (LRE)",
    0x202B: "Right-to-Left Embedding (RLE)",
    0x202C: "Pop Directional Formatting (PDF)",
    0x202D: "Left-to-Right Override (LRO)",
    0x202E: "Right-to-Left Override (RLO - Trojan Source)",
    0xFEFF: "Byte Order Mark / Zero Width No-Break Space",
}

# 検査対象外とする拡張子やディレクトリ
EXCLUDE_DIRS = {".git", "node_modules", "venv", "__pycache__", "dist", "build"}
TARGET_EXTS = {".js", ".ts", ".py", ".go", ".rs", ".java", ".php", ".sh", ".json", ".yml"}

def inspect_file(file_path):
    issues = []
    try:
        with open(file_path, "r", encoding="utf-8", errors="replace") as f:
            for line_no, line in enumerate(f, start=1):
                for char_idx, char in enumerate(line):
                    cp = ord(char)
                    if cp in SUSPICIOUS_CODEPOINTS:
                        issues.append({
                            "line": line_no,
                            "col": char_idx + 1,
                            "char_name": SUSPICIOUS_CODEPOINTS[cp],
                            "codepoint": f"U+{cp:04X}"
                        })
    except Exception as err:
        print(f"[WARN] Failed to read {file_path}: {err}")
    return issues

def scan_repository(root_dir="."):
    total_violations = 0
    print(f"=== Unicode Security Scanner: Scanning '{root_dir}' ===")

    for dirpath, dirnames, filenames in os.walk(root_dir):
        dirnames[:] = [d for d in dirnames if d not in EXCLUDE_DIRS]
        for fname in filenames:
            ext = os.path.splitext(fname)[1].lower()
            if ext in TARGET_EXTS:
                full_path = os.path.join(dirpath, fname)
                found = inspect_file(full_path)
                if found:
                    print(f"\n[ALERT] Suspicious character found in: {full_path}")
                    for item in found:
                        print(f"  Line {item['line']}:{item['col']} -> {item['char_name']} ({item['codepoint']})")
                        total_violations += 1

    if total_violations > 0:
        print(f"\nFAILED: {total_violations} suspicious characters detected!")
        return 1

    print("\nSUCCESS: No hidden Unicode characters detected.")
    return 0

if __name__ == "__main__":
    scan_target = sys.argv[1] if len(sys.argv) > 1 else "."
    result_code = scan_repository(scan_target)
    sys.exit(result_code)
実装2: GitHub Actions によるプルリクエスト自動ブロック
上記のチェックスクリプトをGitHub Actionsに組み込み、不可視文字が混入したコミットを含むプルリクエストをCIで自動遮断するワークフロー(.github/workflows/unicode-lint.yml)の構成例です。
name: Security - Invisible Unicode Check

on:
  pull_request:
    branches: [ main, master, develop ]
  push:
    branches: [ main, master ]

jobs:
  unicode-lint:
    runs-on: ubuntu-latest
    steps:
      - name: Checkout code
        uses: actions/checkout@v4

      - name: Set up Python
        uses: actions/setup-python@v5
        with:
          python-version: '3.11'

      - name: Run Invisible Character Scan
        run: |
          python scripts/check_unicode_security.py .
これにより、第三者のコントリビューターが作成したプルリクエストや、外部ライブラリの更新PRに見えないコードが仕込まれていた場合、マージされる前に自動でCIが赤(Fail)になり、サプライチェーン攻撃を水際で防御できます。
実装3: Git Pre-commit フックによるローカルコミット阻止
開発者のローカル環境でコミット時に即座に弾きたい場合は、.git/hooks/pre-commit に以下のシェルスクリプトを配置(実行権限 chmod +x)します。
#!/bin/bash
# .git/hooks/pre-commit: コミット対象ファイルの不可視Unicode文字を検査

echo "[Pre-Commit] Checking staged files for invisible Unicode characters..."

# ステージングされた対象ファイルを抽出
STAGED_FILES=$(git diff --cached --name-only --diff-filter=ACM | grep -E '\.(js|ts|py|go|rs|json|sh)$')

if [ -z "$STAGED_FILES" ]; then
    exit 0
fi

# ゼロ幅スペース (E2 80 8B 等) のバイトパターンをgrep検索
HAS_ERROR=0
for FILE in $STAGED_FILES; do
    if grep -P '[\x{200B}\x{200C}\x{200D}\x{200E}\x{200F}\x{202E}]' "$FILE" > /dev/null 2>&1; then
        echo "[SECURITY ERROR] Invisible character detected in: $FILE"
        HAS_ERROR=1
    fi
done

if [ $HAS_ERROR -eq 1 ]; then
    echo "Commit rejected! Please remove invisible characters before committing."
    exit 1
fi

exit 0
5. 実務におけるUTF-8の落とし穴とエンジニアの必須知識
セキュリティ対策に加えて、日頃のWebシステム運用やデータベース設計でエンジニアが直面しやすい「UTF-8の落とし穴」を3つ解説します。
落とし穴1: BOM(Byte Order Mark)付きUTF-8によるシステム誤動作
Windowsの古いメモ帳などでファイルを保存した際、ファイルの先頭に0xEF 0xBB 0xBFという3バイトの「BOM(Byte Order Mark)」が付与されることがあります。
- 発生するトラブル: PHPスクリプトの先頭にBOMがあると、
session_start()やheader()関数を呼ぶ前に「謎の空白が出力された」と判定され、Headers already sentエラーが発生して画面が真っ白になります。また、シェルスクリプトの1行目(シバン#!/bin/bash)の前にBOMがあると、OSがシバンを認識できずスクリプトが起動しなくなります。 - 対策の鉄則: Web開発およびプログラムソースコードは必ず「UTF-8(BOMなし / UTF-8 without BOM)」で統一して保存してください。
落とし穴2: MySQLにおける「utf8」と「utf8mb4」の罠
データベースにMySQLやMariaDBを使用している場合、文字コード設定に重大な落とし穴が存在します。
| MySQL文字セット設定 | 最大バイト数 | 絵文字・特殊漢字の対応 | 運用の判定 |
|---|---|---|---|
utf8(utf8mb3) |
最大3バイトまで | ❌ 絵文字(😀等)を入力するとDBエラーで保存失敗 | 非推奨(絶対に使用してはならない) |
utf8mb4 |
最大4バイト対応 | ✔ 絵文字、古代文字、サロゲートペア漢字を完全格納 | 現代の標準(必須設定) |
MySQLの古いutf8設定は最大3バイトまでしか格納できない不完全な仕様でした。ユーザーがSNSの投稿やフォーム入力で絵文字を入力すると、データが途中で切り捨てられたり、SQLエラーでトランザクションがロールバックしたりします。新規システム構築はもちろん、既存のテーブルも必ずutf8mb4(照合順序: utf8mb4_unicode_ci または utf8mb4_0900_ai_ci)に設定してください。
落とし穴3: macOSとWindows/Linuxの「濁点」Unicode正規化問題(NFC vs NFD)
Macのファイルシステム(APFS/HFS+)で作成した日本語ファイル(例:「が.txt」)をWindowsやLinuxサーバーにアップロードすると、文字化けしたりファイルが見つからないエラーになることがあります。
- NFC(Windows/Linux等): 「が」を単一のコードポイント(
U+304C)として1文字で扱う方式。 - NFD(Macのファイル名等): 「か」(
U+304B)と結合濁点記号(U+3099)の2文字を組み合わせて「が」と表現する方式。
ファイル名検索や文字列の一致判定を行うWebAPIでは、サーバー側で受領した文字列に対してUnicode正規化(Pythonなら unicodedata.normalize('NFC', text))を適用するガードレールを設けておくことが現場運用の鉄則です。
💡 あわせて読みたいセキュリティ・開発関連記事
6. まとめ:文字コードの深層仕様を理解し、堅牢な防御壁を築こう
今回は、UTF-8の可変長バイト構造から、「見えないUnicode文字」を悪用した最新のコード隠蔽手口、そしてVSCodeとCI/CDによる完全防衛策までを網羅的に解説しました。
📌 本記事の重要ポイントまとめ
- UTF-8は可変長仕様: ASCIIは1バイト、日本語や不可視文字(U+200B)は3バイト、絵文字は4バイトで表現される。
- 見えない文字の脅威: ゼロ幅文字(ZWSP等)を2進数の0と1に見立ててエンコードすることで、人間の目や通常のgrepをすり抜けるバックドアが構築可能。
- VSCodeの防御策:
editor.unicodeHighlight.invisibleCharacters: trueを設定することで、不可視文字を赤枠ハイライトとして即座に捕捉可能。 - CI/CD自動化: Python検知スクリプトやGit Pre-commitフックを配備し、プルリクエストの段階で不可視文字を機械的に排除する。
- 実務のベストプラクティス: ソースコードは「BOMなしUTF-8」、DBは「utf8mb4」、文字列比較は「NFC正規化」を徹底する。
「文字コード」は一見すると枯れた基本技術に見えますが、その深層仕様を理解しているかどうかで、最新のサプライチェーン攻撃やバックドアを見抜けるかどうかが決定的に分かれます。
まずは今すぐご自身のVSCodeの settings.json を見直し、プロジェクトのCIパイプラインに不可視文字のセキュリティチェックを組み込んでみてください。