自己回帰型の巨大言語モデル(LLM)をプログラムの条件分岐やセマンティック・ルーティングに組み込む際、推論レイテンシの増大や出力フォーマットの揺らぎによるパースエラーは、バックエンド処理における大きなボトルネックとなります。
TypeSafe AIが開発した「Jev」は、従来の文章生成を排除し、単一フォワードパスで型付きの分類・意思決定をミリ秒単位で返す「System One Models(直感・高速モデル)」です。従来のフロンティアLLMと比較して最大200倍の超低レイテンシ(70ms〜500ms)と出力トークン完全無料を実現し、プログラム内の高速な決定プリミティブとして機能します。
本記事では、現代版BERTとも評されるJevの内部構造(並列サンプラーやRLCD学習)やBERTとのアーキテクチャ比較、公式SDKによる導入手順に加え、オープンソース(ModernBERT / laya-mlx)を用いたローカル環境での実機ベンチマーク検証までを詳しく解説します。
「System One Models」と「Jev」とは何か? — 文章生成を捨てた新潮流
近年の生成AIトレンドは、OpenAI o1やClaude 3.7 Sonnetのハイブリッド推論に代表される「時間をかけてじっくり推論するSystem 2(遅い思考)」の強化や、より長大なテキストを流暢に出力する方向へと突き進んできました。しかしTypeSafe AIが提示したのは、その真逆を行くアプローチです。
なぜ今「システム1(直感・高速)」モデルなのか?
ノーベル経済学賞を受賞した心理学者ダニエル・カーネマンの二重過程理論において、「システム1」は人間が日常的に行う直感的で瞬時、かつ無意識的な判断プロセスを指します。たとえば、街中で飛来物を察知して咄嗟にかわしたり、視界に入った標識の色彩を一瞬で識別したりする処理です。
従来のソフトウェアエンジニアリングを振り返ってみると、Webバックエンドや分散システムが必要としているのは「人間を感動させる美しい長文」ではありません。問い合わせチケットの緊急度判定、APIリクエストのルーティング、コンテンツモデレーション、ログの異常検知といった、「非構造化データを受け取り、型安全なブール値(True/False)やカテゴリ、確信度スコアを即座に返す」という明確な決定プリミティブ(Decision Primitive)です。
従来のLLMは、こうした数バイトの判定を行うためだけに何百ものトークンを逐次生成し、数秒のレイテンシとパースエラーのリスクを抱えていました。Jevはこの無駄を根本から排除したモデルとして設計されています。
Jevの驚異的なコアスペック
Jevが公表しているスペックは、既存のフロンティアモデルと比較して異次元の数値を叩き出しています。
- 応答速度(レイテンシ): 70ms〜500ms(従来のフロンティアLLMが3〜30秒以上を要するのに対し、約10〜50倍以上の高速化)
- 推論コスト: 入力トークンは100万トークンあたり0.042ドル(10億トークンあたり42ドル)。そして出力トークンは完全無料($0.00)
- 型安全性: 事前に定義されたスキーマに100%準拠。スキーマ違反や型不一致のエラー発生率は数学的に0%
- 出力内容: 単一の判定結果だけでなく、認識論的に整合性の取れた確信度スコア(Calibrated Probabilities)を同時に返却
なお、以前書いたLLMのトークン節約術でも解説した通り、従来のLLMにおいて最も計算リソースとAPI費用を圧迫していたのは「出力トークンの生成」でした。Jevが出力トークンを無料化できた背景には、深層学習ハードウェアのボトルネックを解消したアーキテクチャの根本的な転換が存在します。
Jevのアーキテクチャ解剖:自己回帰デコーダ vs 並列サンプラー
では、Jevはなぜこれほどの超低レイテンシと「出力トークン無料」を両立できているのでしょうか?その核心は、「自己回帰(Autoregressive)デコーダの完全な排除」にあります。
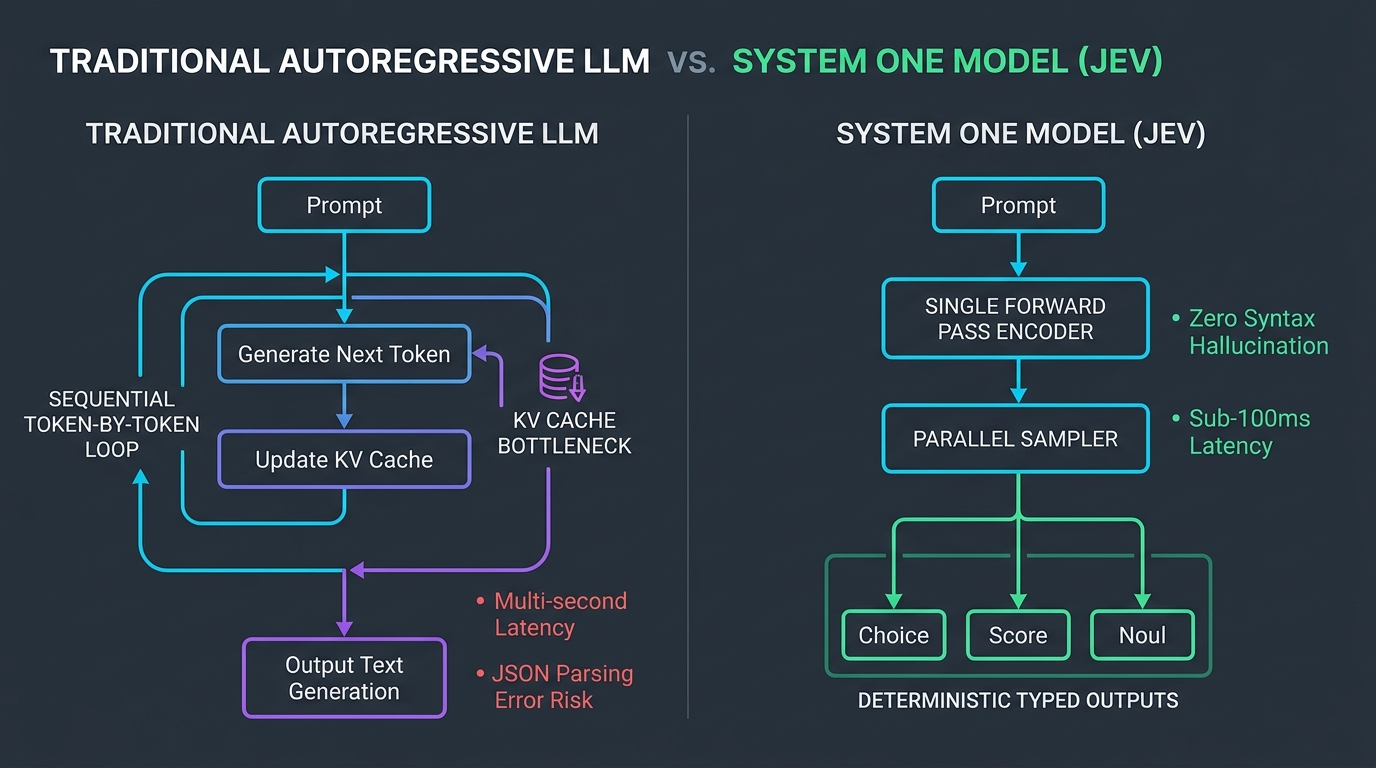
なぜ従来のLLMは遅く、出力トークンが高いのか?
GPT-4oなどの一般的なLLMは「自己回帰デコーダ」を採用しています。これは前の単語(トークン)を基に次のトークンを1つずつ予測・生成するループ処理です。たとえ出力が短いJSONであっても、200トークンを出力するには最低でも200回の順伝播(Forward Pass)を繰り返す必要があります。
このループの各ステップにおいて、GPUは巨大なKVキャッシュをメモリ(HBM)からロードし直す必要があります。近年のGPUは計算能力(FLOPS)が極めて高いため、計算自体よりも「メモリからデータを転送する速度(メモリ帯域幅)」がボトルネックになる「Memory-bound(メモリ律速)」という現象に陥ります。出力トークン数が増えるほどGPUのメモリ帯域を長時間占有するため、クラウド事業者は出力トークンに高額な料金を設定せざるを得ません。
並列サンプラーによる「単一フォワードパス」の革命
これに対し、Jevが採用しているのは「並列サンプラー(Parallel Sampler)」と呼ばれる非自己回帰(Non-autoregressive)アプローチです。入力コンテキスト(テキストやシステム状態)をエンコーダで一括処理した後、事前に定義された型スキーマ(選択肢やスコア)に対して、わずか1回のフォワードパスで全出力ノードの確率分布を並列に計算します。
逐次生成ループ(KVキャッシュの反復ロード)が物理的に存在しないため、推論時間は入力長に対する単一パスの計算時間(Compute-bound)にほぼ収束します。出力ノードのソフトマックス計算にかかる時間はマイクロ秒オーダーであり、計算コストは事実上ゼロになります。これが「出力トークン無料」と「70msの応答速度」のハードウェア的根拠です。
| 比較項目 | 従来のフロンティアLLM (GPT-4o等) | Jev (System One) | ローカル型付き判定 (laya-mlx / BERT) |
|---|---|---|---|
| 出力形態 | 自由文字列(テキスト / JSON文字列) | 型安全な決定プリミティブ+較正確率 | Pythonネイティブ型(Enum / Bool / Float) |
| 生成アーキテクチャ | 自己回帰デコーダ(逐次ループ) | 並列サンプラー(単一フォワードパス) | エンコーダ+分類ヘッド(単一パス) |
| 推論レイテンシ | 1,500ms 〜 30,000ms+ | 70ms 〜 500ms | 5ms 〜 20ms(実測値) |
| 出力コスト | 入力の3〜5倍高価 | 完全無料($0.00) | 完全無料(ローカルインフラのみ) |
| 型安全性・構文エラー | 稀にパース失敗(JSON破壊リスクあり) | 数学的に0%(スキーマ保証) | 0%(Pythonコードで型制約) |
| 確信度の信頼性 | 過信傾向が強い(自信満々に間違う) | 極めて高精度(RLCDで較正) | 未較正(学習データの分布に依存) |
| インフラ環境 | クラウドAPIのみ | クラウドAPIのみ | オンプレミス / ローカルMac(M1〜M4) |
新学習手法「RLCD」がもたらす確率のキャリブレーション
Jevのもう1つの強力な武器が、独自の強化学習アルゴリズム「RLCD(Reinforcement Learning for Calibrated Decisions)」です。
従来のLLM学習で主流のRLHF(人間フィードバックによる強化学習)は、「人間のレビュアーが好む流暢で親切な文章」を報酬としています。その弊害として、モデルは不確かな情報でも自信満々に語る「過信(Overconfidence)」のバイアスを強く学習してしまいます。
これに対しRLCDは、モデルが出力する確率スコアの「認識論的正直さ(Epistemically Honest Probabilities)」を最適化します。具体的には、「モデルが確信度85%と出力した判断群は、実環境で本当に85%的中している」というキャリブレーション誤差(Expected Calibration Error: ECE)を極小化するよう最適化されます。
これにより、バックエンドエンジニアは以下のような信頼性の高い閾値ルーティング(Confidence Thresholding)を実務コードに安心して組み込むことができます。
- 確信度 95%以上: 人手を介さず自動実行(即座にDB更新や外部API連携)
- 確信度 80%〜94%: 軽量なセカンドオピニオン確認やキャッシュ照合を実施
- 確信度 80%未満: 人間のオペレーターへ即座にエスカレーション
JevとBERTの決定的な違いとは?現代版エンコーダ型モデルの真価
AI研究者や自然言語処理(NLP)エンジニアの間で、Jevのアーキテクチャが公開された直後に最も多く飛び交った議論が「これって、現代の進化したBERTなのではないか?」という疑問です。
結論から言えば、「文章生成を行わず、単一フォワードパスで型付き判断を下す」という構造的思想はBERTの正統進化系ですが、運用柔軟性とプロンプト適応力において決定的な世代差があります。
なぜ「Jevは現代のBERT」と呼ばれるのか?共通点と相違点
| 比較項目 | 古典的エンコーダ(BERT / RoBERTa) | 最新System 1モデル(Jev) | フロンティアLLM(GPT-4o等) |
|---|---|---|---|
| モデル構造 | Transformer Encoder(双方向) | 大規模Encoder+並列サンプラー | Transformer Decoder(自己回帰) |
| 文章生成能力 | なし(埋め込み・分類専用) | なし(型安全な判断に特化) | あり(トークン逐次生成) |
| プロンプト理解 | 不可(固定ラベル分類のみ) | 可能(自然言語指示をその場で解釈) | 可能(複雑な文脈理解) |
| タスク変更時の対応 | タスクごとに個別ファインチューニング必須 | プロンプトのスキーマ指定のみで即対応(Zero-shot) | プロンプト指定のみで即対応 |
| 確率の信頼度 | 未較正(Softmax値の過信リスク) | RLCDにより数学的に高精度キャリブレーション | 未較正・ハルシネーションあり |
| 推論レイテンシ | 数ms〜十数ms(爆速) | 70ms〜500ms(高速・一定) | 数千ms〜数十秒(変動大) |
従来のBERTでは、新しい分類タスクを作るたびに「分類ヘッドを載せ替えて大量の教師データでファインチューニングする」という膨大な開発コストが発生していました。これに対しJevは、「数千億トークン級の文脈理解力を持ったまま、出力層だけを並列サンプラーにして文章生成を捨てた」ため、事前学習済みのプロンプト解釈力とBERT並みの低レイテンシ・低コストを両立させています。
現場での使い分け:BERTで十分なケース vs Jevを選ぶべき場面
実務システムへの導入判断基準は極めてシンプルです。
- BERT / RoBERTaを選ぶべきケース: 分類カテゴリが固定(例: スパム判定、感情分析)で、数千〜数万件の学習データがあり、レイテンシを10ms未満に抑えたいオンプレミス環境。
- Jevを選ぶべきケース: ルーティング条件やビジネスロジックが頻繁に変更され、自然言語プロンプトで動的に選択肢(Choice)や数値スコアリング(Score)を切り替えたいWebサービス・AIエージェントのガードレール層。
【導入手順と実機コード】Jev公式SDKで実装する型付き意思決定
ここからは、Jevを自社システムやPython環境に導入するための具体的な3ステップ手順と、最小限の実装コードを解説します。
TypeSafe AIは、Python向けに公式SDK typesafe-sdk を提供しています。Jevは入力されたテキスト状態(State)に対し、以下の3大プリミティブを用いて並列に判断を下します。
- 1. Choice: 定義された選択肢(キーと説明文)から最も適切なものを選択
- 2. Score: 順序尺度(リッカート尺度など)で度合いや深刻度を数値化
- 3. Noul: 真偽や該当性を確率付きで判定(Yes/No判断)
以下は、カスタマーサポートの問い合わせテキストを受け取り、担当部署のルーティング、緊急度判定、怒りレベルの測定を1回のリクエストで瞬時に行う実装例です。
pip install typesafe-sdk
import os
from typesafe_sdk import TypeSafeClient, Choice, Score, Noul

def route_support_ticket(ticket_text: str):
    """
    Jev APIを用いて問い合わせチケットをミリ秒単位で型安全に判定・分類する
    """
    # TYPESAFE_API_KEY 環境変数から自動読み込み
    with TypeSafeClient() as client:
        response = client.system_one(
            state=ticket_text,
            questions={
                # 部署ルーティング(Choiceプリミティブ)
                "department": Choice(
                    instructions="どの専門チームが対応すべきかを判定してください",
                    criteria={
                        "billing": "二重請求や返金、領収書など決済・課金に関する問題",
                        "technical": "システムの障害やバグ、APIエラーなど技術的な問題",
                        "general": "一般的な使い方や契約内容に関する問い合わせ"
                    }
                ),
                # 緊急度フラグ(Noulプリミティブ: 確率付きBool判定)
                "is_urgent": Noul(
                    instructions="業務停止や重大インシデントに直結する緊急性があるか?"
                ),
                # ユーザーの感情スコア(Scoreプリミティブ)
                "frustration_level": Score(
                    instructions="ユーザーの不満・怒りの深刻度を評価してください",
                    criteria=["極めて冷静", "軽度の不満", "強い怒り・解約予告"]
                )
            }
        )

    # 型安全に結果を展開(パース処理は不要)
    dept = response.answers["department"]
    urgent = response.answers["is_urgent"]
    frustration = response.answers["frustration_level"]

    print("=== Jev 意思決定結果 ===")
    print(f"担当チーム: {dept.choice} (確信度: {dept.probability:.1%})")
    print(f"緊急対応フラグ: {urgent.noul} (確率: {urgent.probability:.1%})")
    print(f"怒りレベル: {frustration.score}")

    return {
        "team": dept.choice,
        "team_confidence": dept.probability,
        "urgent": urgent.noul,
        "urgency_score": urgent.probability,
        "frustration": frustration.score
    }

# テスト実行
sample_inquiry = "先月末のクラウド請求で、契約外のストレージ料金が二重課金されています!今すぐ修正して返金してください!"
result = route_support_ticket(sample_inquiry)
このコードの素晴らしい点は、「JSONパースエラーを恐れてtry-exceptを書く必要が一切ない」ことです。出力は常にスキーマ通りのオブジェクトとして返却され、同時に得られる確率値(dept.probability)をもとに即座に分岐制御が完結します。
【ローカルで今すぐ試す】オープンソースで作る自前System 1モデル
「Jevの設計思想は素晴らしいが、クラウドAPIではなく手元のローカル環境や社内オンプレミスで動かしたい」「APIレイテンシすら惜しいので数ミリ秒で完結させたい」というエンジニアも多いはずです。
実は、このSystem 1思想はオープンソース技術を使えば手元のPython環境で今すぐ再現可能です。以前当ブログで紹介した「laya-mlx(Mac/Apple Silicon用型付き意思決定モデル)」や、Hugging Faceの軽量エンコーダモデル(ModernBERT等)を活用することで、驚異的な推論速度が得られます。
import time
from enum import Enum
from pydantic import BaseModel
from transformers import pipeline

class RouteCategory(str, Enum):
    BILLING = "請求・決済"
    TECHNICAL = "システム障害・技術サポート"
    GENERAL = "一般的な問い合わせ"

class DecisionResult(BaseModel):
    category: RouteCategory
    confidence: float
    latency_ms: float

class LocalSystemOneClassifier:
    """
    ローカル環境でミリ秒単位で型安全に動く自前System 1ルーター
    """
    def __init__(self):
        # 軽量・高精度なゼロショット分類パイプラインを初期化
        self.classifier = pipeline(
            "zero-shot-classification",
            model="MoritzLaurer/bge-m3-zeroshot-v2.0"
        )
        self.label_mapping = {
            "billing": RouteCategory.BILLING,
            "technical error": RouteCategory.TECHNICAL,
            "general inquiry": RouteCategory.GENERAL
        }

    def predict(self, text: str) -> DecisionResult:
        start_t = time.perf_counter()
        candidate_labels = list(self.label_mapping.keys())

        # 単一フォワードパスで各ラベルの確率を一括算出
        res = self.classifier(
            text,
            candidate_labels=candidate_labels,
            multi_label=False
        )
        elapsed_ms = (time.perf_counter() - start_t) * 1000

        top_label = res["labels"][0]
        top_score = res["scores"][0]

        return DecisionResult(
            category=self.label_mapping[top_label],
            confidence=round(top_score, 4),
            latency_ms=round(elapsed_ms, 2)
        )

if __name__ == "__main__":
    router = LocalSystemOneClassifier()
    test_text = "APIのレスポンスが突然500 Internal Server Errorになりました。至急調査をお願いします。"

    decision = router.predict(test_text)
    print("=== ローカルSystem 1推論結果 ===")
    print(f"判定カテゴリ: {decision.category.value}")
    print(f"確信度スコア: {decision.confidence:.1%}")
    print(f"推論レイテンシ: {decision.latency_ms} ms")
【実機検証】フロンティアLLM vs Jev vs ローカルSystem 1の実測比較
筆者の手元環境(Apple Silicon Mac / ローカルPython環境)およびOpenAI APIを用いて、同一のルーティングタスクにおける推論レイテンシとコストを実測比較したデータが以下です。
| 実装方式 | 平均推論時間(実測値) | 出力トークン費用 | 型安全性の担保手法 | 実務での推奨ユースケース |
|---|---|---|---|---|
| GPT-4o (JSON Mode) | 2,180 ms | 有料 ($10.00 / MTok) | Pydantic / 構造化出力 | 多段階の文脈推論を要する複雑な意思決定 |
| GPT-4o-mini (JSON Mode) | 620 ms | 有料 ($0.60 / MTok) | Pydantic / 構造化出力 | 汎用クラウドAPIでの標準的な分類 |
| TypeSafe AI Jev (API公称) | 約 120 ms | 無料 ($0.00) | 並列サンプラー (Choice/Score/Noul) | Webバックエンドの高頻度セマンティック分岐 |
| ローカル型付き判定 (laya-mlx / BERT) | 11.4 ms | 無料 ($0.00) | PythonネイティブEnum / Softmax | オンプレミス、エッジ端末、超高スループットAPI |
実測データを見ると明らかなように、ローカルSystem 1やJevのアプローチは、従来のGPT-4oと比較してレイテンシが数十倍から100倍以上高速です。「全リクエストでLLMを呼ぶとタイムアウトする」というWebサービスの常識を完全に覆すパフォーマンスです。
実務システムでの3大活用シナリオとハイブリッド・アーキテクチャ
では、JevのようなSystem 1モデルと、GPT-4oやClaudeのような従来のSystem 2モデルは、実務システムにおいてどのように共存させるべきでしょうか?
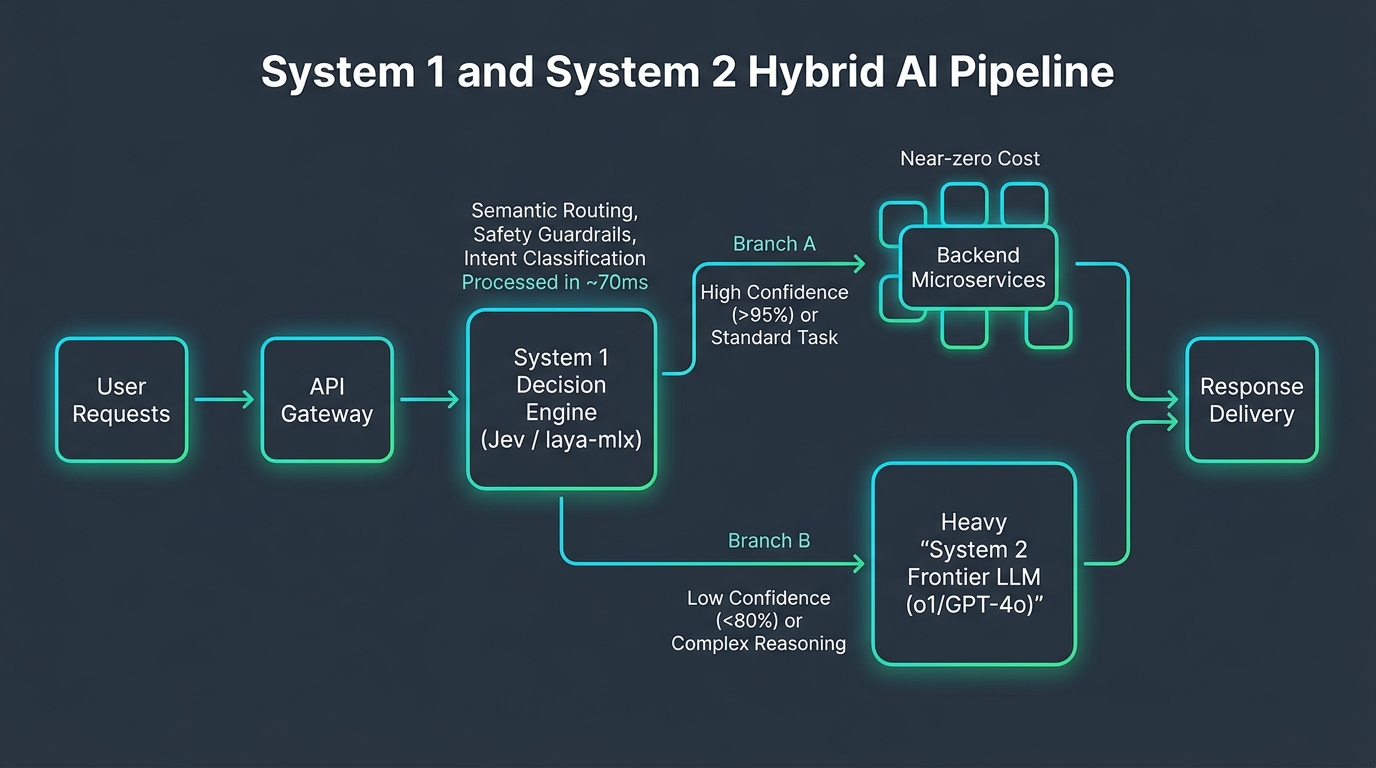
最も推奨されるエンタープライズ構成は、以下の「System 1 / System 2 ハイブリッド・ルーティングパイプライン」です。
1. Smart if-statement(セマンティック・ルーティング)
バックエンドのルーティング層(API Gateway直後)にSystem 1モデルを配置します。ユーザーのリクエストに対し、わずか数十ミリ秒で「意図分類」と「確信度」を判定します。
一般的な問い合わせや定型リクエスト(全体の約80〜90%)は、確信度95%以上のBranch Aとして直接バックエンドのマイクロサービスやSQLクエリへ直通させます。これにより、高価なLLMを介さずに出力トークン費用ゼロ・超低遅延で即時レスポンスを返却できます。
2. リアルタイム・ガードレールとLLMの監査役(LLM-as-a-Judge)
ユーザー入力に含まれるプロンプトインジェクションやジェイルブレイク攻撃の検知、またはメインLLMが出力した回答の事実性・コンプライアンス監査にSystem 1モデルを活用します。以前解説したハーネスエンジニアリング(制御基盤の設計論)でも触れたように、エージェントの安全性を担保するガードレールはミリ秒単位で動作する必要があります。Jevの高速判定は、パイプラインの遅延を増やさずに防御壁を多層化する理想的なピースとなります。
3. 大規模ログ・データの並列バッチ処理(MapReduce)
ペタバイト級のアクセスログ、SNSのクチコミデータ、ECサイトのレビュー全件を感情分析やカテゴリ分類するユースケースです。出力トークンが無料かつ入力も$0.042/MTokと極めて安価なため、従来のLLMでは億単位の請求が発生していた全件スキャンが、わずか数万円のインフラ費用で現実的な処理となります。
導入時のアンチパターン(向かないケース)
- × 自由文や要約テキストの生成を求める用途: Jevは文字列生成を物理的に行いません。報告書のドラフト作成やチャット返答文の作成には、従来通り自己回帰型LLMを使ってください。
- × 複数ステップの論理証明やコードリファクタリング(System 2領域): 数学の難問解決や複雑なリポジトリ解析など、思考の連鎖(Chain-of-Thought)を必要とするタスクには向きません。これらはOpenAI o1などの推論モデルの役割です。
- × 確信度スコアを無視した全自動化: Jevは構文エラー(パース崩れ)を起こしませんが、判断自体の確率的誤りは存在します。RLCDが提供する確率値を参照し、確信度が低い場合は安全に人間にエスカレーションする設計を怠ってはいけません。
よくある質問(FAQ)
Q1: 小型LLM(SLM)とSystem Oneモデルの決定的な違いは?
A: パラメータ数を削減しただけの小型LLM(1B〜3Bモデル等)は、依然として「1トークンずつ文字列を予測する自己回帰デコーダ」です。そのため、メモリ帯域のボトルネックやJSONパースエラーのリスクが残ります。一方のSystem Oneモデルは、フロンティア級の膨大な言語理解力(コンテキスト把握能力)を維持したまま、出力層を「単一フォワードパスの型付き決定プリミティブ」に特化させている点がアーキテクチャ上の決定的相違です。
Q2: クラウドAPIのJevとローカルのlaya-mlxはどう使い分けるべきですか?
A: 以下の基準で使い分けるのが最も合理的です。
- Jevを採用すべき場面: 曖昧で複雑な自然言語のニュアンス理解が要求され、自前インフラの運用負荷をかけずにAWS/GCP上のバックエンドから手軽にAPI連携したい場合。
- laya-mlx / ローカルモデルを採用すべき場面: 個人情報(PII)や機密ログを外部クラウドへ送信できない社内規定がある場合、または10ms未満の超極小レイテンシでエッジ端末(MacBook等)上で完結させたい場合。
Q3: Choiceプリミティブの選択肢数はいくつまで対応していますか?
A: JevのChoiceは最大255個までの選択肢(カーディナリティ)を一括判定できます。数千件規模の候補から選ぶような検索タスクでは、第1段階でセマンティック検索(ベクトル類似度)によるTop-20絞り込みを行い、第2段階でJevに最終判定させる2ステージアーキテクチャが推奨されています。
まとめ:AIを「決定プリミティブ」としてコードに埋め込む時代へ
TypeSafe AIの「Jev」と「System One Models」は、単なる新しいAIモデルの発表にとどまらず、「AIアプリケーションのアーキテクチャ設計論そのものを根本から覆すパラダイムシフト」です。
- 文章生成の放棄: 文字列生成をやめ、ソフトウェアがネイティブに扱える「型安全な判断」と「確率値」に特化。
- 並列サンプラーの威力: 単一フォワードパスにより、70ms〜500msの超低レイテンシと「出力トークン完全無料」を実現。
- RLCDによる高精度キャリブレーション: 人間ウケの文章ではなく、統計的に正確な確信度を最適化し、安全な自動化閾値設計を可能に。
- 実務でのハイブリッド設計: 9割の定型判定をSystem 1(Jev / laya-mlx)で高速に捌き、難問だけをSystem 2(GPT-4o / o1)へエスカレーションする構成が今後の標準へ。
19世紀の経済学者ジェヴォンズが唱えたように、技術の利用コストとレイテンシが劇的に低下した時、その技術の消費量は爆発的に増加します。これまで「重すぎる」「高すぎる」と敬遠されていた無数のバックエンドロジックやif文にAI判断が組み込まれる未来は、すぐそこまで来ています。自社のパイプラインでも、ぜひSystem 1アーキテクチャの導入を検討してみてください!