日々の開発や業務の自動化でAIツールを使っていて、「指示を出すのは楽になったけれど、結局生成されたコードや文章を自分のソフトにコピペして、手動で微調整や手直しをする作業に一番時間を取られている……」と感じたことはないでしょうか?
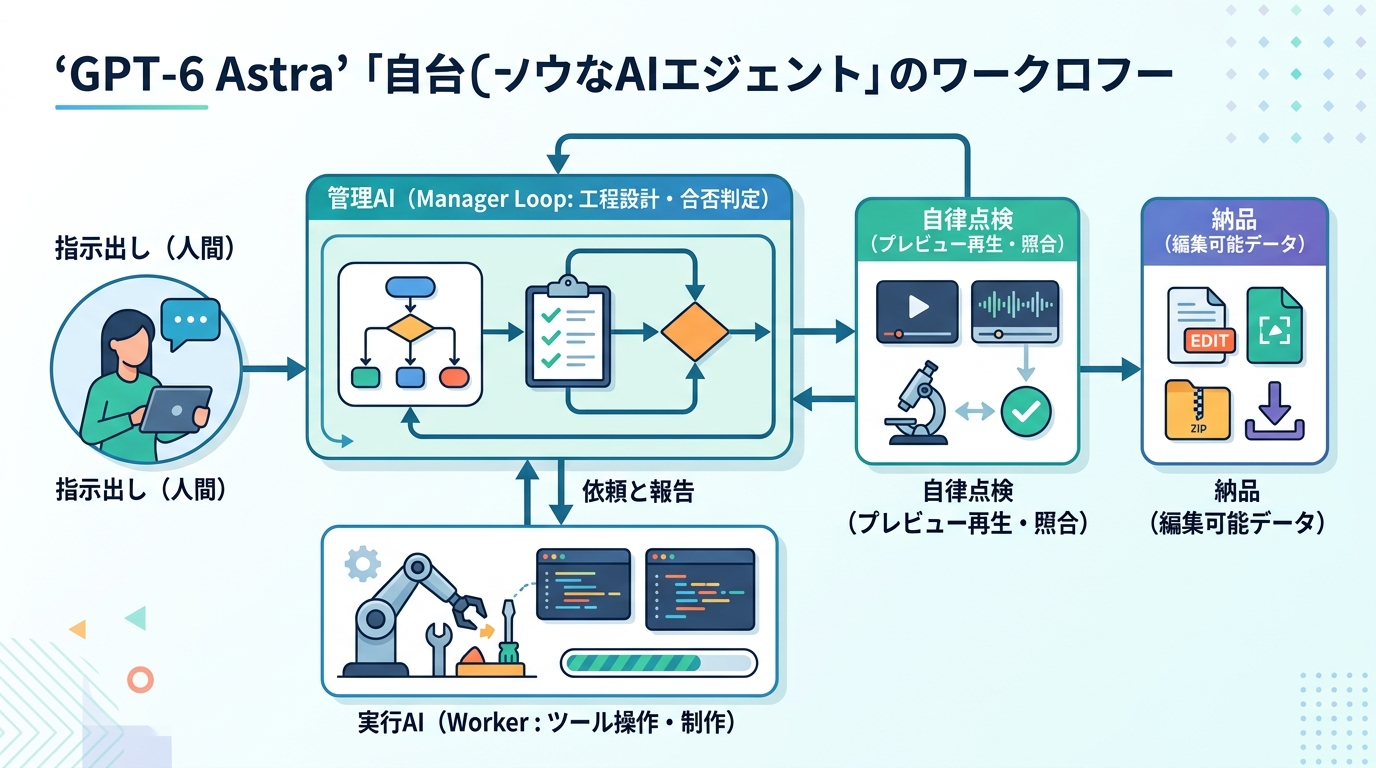
2026年9月、OpenAIから発表されたフロンティアモデル「GPT-6 Astra」は、国内外のエンジニアやクリエイターに大きな衝撃を与えました。単にテキストの賢さや推論速度が上がっただけでなく、OS上のソフトウェアを自律的に操作し、自ら不備を検証して仕事を最後までやり切る「自律エージェント(Autonomous Agent)」への決定的な進化を遂げたからです。
結論から言えば、これからのAI活用は「チャット欄に質問して答えをもらう」時代から、「AI自身にツールや実務ソフトを操作させ、セルフチェックループ(自己点検)を回させて、完成された成果物を受け取る」時代へと完全にシフトしました。本記事では、海外の先駆者たちが実践する精鋭6事例を体系的に分析するとともに、筆者自身がローカル環境で自律エージェントを構築して直面した泥臭い失敗談、そして失敗を防ぐ「Manager Loop」のPython完全実装コードと実機生ログまで徹底解説します!
GPT-6 Astraとは?「対話型AI」から「自律エージェント」への大転換
100万トークンの広大な文脈とComputer Useが拓く新次元
GPT-6 Astraの最大の特徴は、従来のLLMの枠組みを超えた「エンドツーエンドの自律作業能力」にあります。約105万トークンにおよぶ超巨大なコンテキストウィンドウと最大12万8,000トークンの出力を備え、複数のファイルや大規模リポジトリ、数時間に及ぶ作業ログをすべて記憶したまま作業を持続できます。
さらに、OS上のブラウザやデスクトップソフトウェアを視覚情報に基づいて直接操作する「Computer Use」機能が大幅に強化されました。従来のAPI経由のツール呼び出しにとどまらず、画面のUI要素を認識してクリックやキーボード入力を自律的に行うことで、本格的なPC作業の代行が可能になっています。
チャット欄のコピペ作業から「編集可能プロジェクトの直接納品」へ
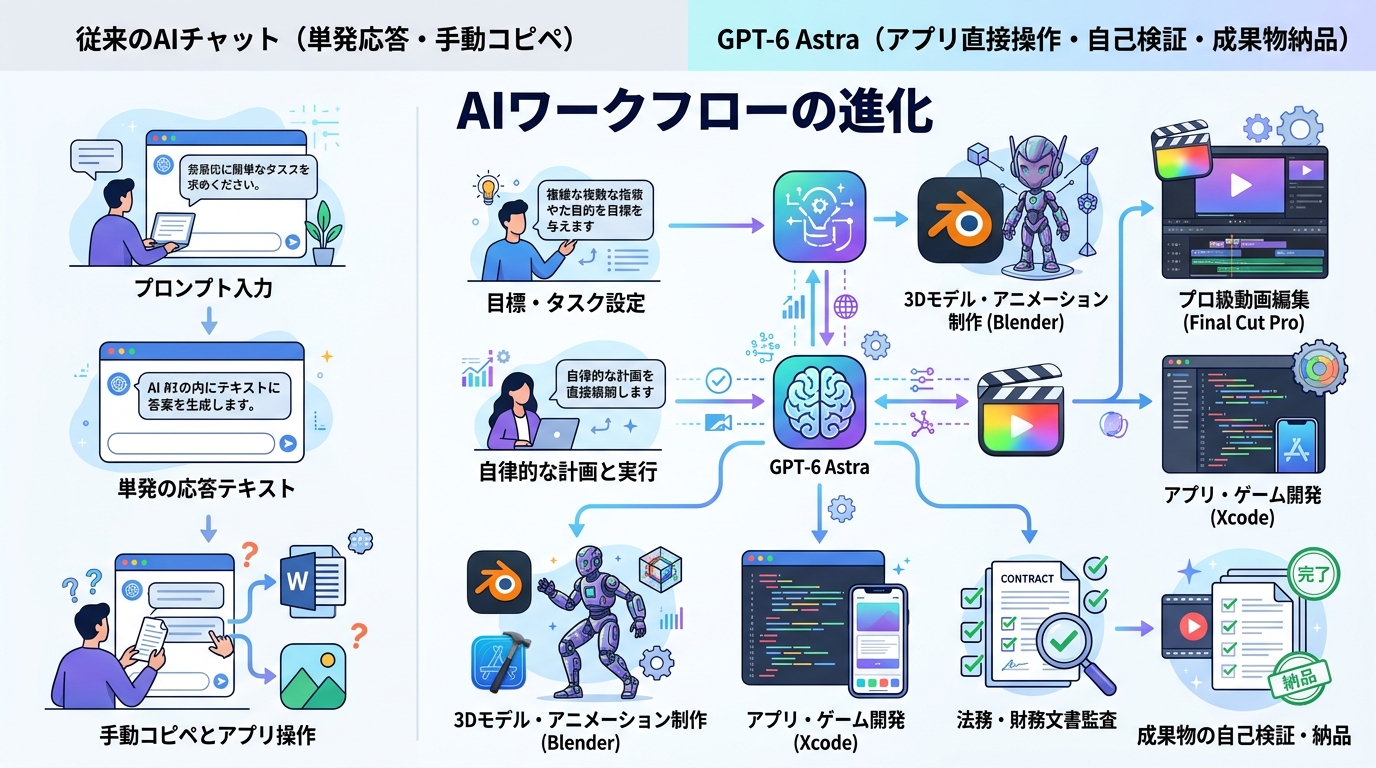
これまでのAI活用といえば、ブラウザのチャット欄にプロンプトを入力し、返ってきたコードや文章をコピーしてエディタに貼り付けるスタイルが主流でした。以前書いたGitHub Copilotプロンプト最適化の勘所でも触れたように、いかにAIに的確な出力を出させるかという「入力プロンプトの工夫」に重きが置かれていたわけですよね。
しかしAstraの登場により、その前提が根本から覆りつつあります。人間が手作業で橋渡しをする必要はなくなり、「作業領域のソフトを開き、プロジェクト一式を作成し、不備がないか自ら点検した上で保存しておく」という一連のワークフロー全体をAI自身が完遂してくれるようになったのです。
従来チャット型AIと自律エージェントの決定的な違い
両者のアプローチの違いを整理すると、以下の対比テーブルのようになります。AIの役割が「アドバイザー」から「実務作業者」へと完全に移り変わっていることが分かります。
| 比較項目 | 従来の対話型AI (ChatGPT等) | 自律エージェント (GPT-6 Astra等) |
|---|---|---|
| 主な作業場所 | ブラウザのチャットUI・エディタ窓 | OS上の実務ソフト (Xcode, Blender, Final Cut等) |
| 人間の主な役割 | 回答のコピペ、動作確認、手動修正 | 初期要件の提示、マイルストーン承認、最終検収 |
| エラーへの対応 | 人間がエラーログを貼り直して再質問 | AIが自らエラーを検知し、自律的にコードを再修正 |
| 納品される成果物 | コードスニペットやテキスト断片 | 完成したプロジェクトファイル・編集可能データ一式 |
| 実行サイクル | 1往復ごとの単発対話(Single-turn) | 目標達成まで自律試行する多段ループ(Multi-turn) |
実践現場の最前線!自律エージェントが活躍する3大領域と6つの事例
領域①【クリエイティブ制作】:Final Cut Pro・Blenderによる非破壊納品
海外のクリエイターコミュニティで特に大きな反響を呼んでいるのが、Final Cut ProやBlenderといった本格的なプロ向けソフトをAIに直接操作させるアプローチです。
- 事例1(動画下編集 / Ben Davis氏): 撮影素材の取り込みからカラー補正、音声クリップの同期までをFinal Cut Pro上で直接AIに下処理させました。特筆すべきは、書き出し済みMP4だけでなく「人間が後からタイムライン上でカットを微調整できるプロジェクトファイル」として納品させている点です。
- 事例2(3Dモデリング / Blender): 家具配置やマテリアル設定において、壁・床・照明・ソファーを独立したレイヤー・オブジェクトとして分離した「.blendファイル」を出力。人間が修正不可能なベタ画像ではなく、手直しが効く非破壊データとして納品させる運用が確立されています。
領域②【自律的自己点検】:動画照合とゲームUI開発におけるセルフチェック
もう一つの革新的なアプローチが、書き出した成果物をAI自らがもう一度開き、指示通りになっているか検証する「セルフチェックループ」です。
- 事例3(動画整合性チェック / Nate Herk氏): エージェント自身が書き出されたMP4のフレーム映像を再生確認し、さらに音声を文字起こしして元の台本と照合。テロップの脱字やタイミングのズレを人間が指摘する前に自律修正しました。
- 事例4(ゲームUI開発 / Anshu氏): あらかじめ生成した「完成コンセプト画像」を基準に設定し、実際のゲーム画面をキャプチャして比較しながら、色調やUI配置が基準に近づくまで自動でCSSやシェーダーを修正するループを回しました。
領域③【エンタープライズ監査】:BoxとLegoraに見るドキュメント照合
クリエイティブ用途だけでなく、ビジネス文書や法務・財務の領域でも高精度な自律検証が行われています。
- 事例5(誠実な財務分析 / Box): 地域別の予算配分を検討させた際、資料中に必要な重要指標が存在しないことを見抜き、勝手な推測値で埋めるハルシネーションを起こさず、「資料不足のため代替指標で算出」と明記してレポートを提出しました。
- 事例6(決算文書監査 / Legora): 41件におよぶ決算関連文書を横断照合させ、人間が意図的に仕込んだ4つの誤記や不整合をすべて検出。指摘箇所には対象資料のページ番号やスプレッドシートのセル番地まで正確に記載されていました。
【一次情報・自前検証】筆者が体験した自律エージェントの泥臭い失敗談
失敗談①:「無限自己修正ループ」によるトークン枯渇と停止不能トラブル
こうした華々しい成功事例を見て、「自律エージェントさえ組めば仕事が全自動化できる!」と興奮した筆者は、さっそくローカル環境で自前のエージェントスクリプトを組み、ドキュメントの校正とリンク検証を自律実行させてみました。しかし、そこで直面したのは教科書には載っていない泥臭いトラブルの連続でした。
最大の失敗は「無限自己修正ループ(Self-Correction Trap)」です。「文章の不備を自ら見つけて修正せよ」というプロンプトを与えたところ、エージェントは1行直しては「句読点の位置が気に入らない」「言い回しをもう少しフォーマルにすべき」と微修正を永遠に繰り返し、上限ループ回数を設けていなかったために数千円分のトークンをわずか十数分で溶かして強制停止しました。
失敗談②:元ファイルの直接上書きによる「データ消失事故」
次にやらかしたのが、ファイルの直接上書き事故です。エージェントにローカルのMarkdownファイルを直接編集させたところ、途中の正規表現置換でエージェントが構文を誤認し、ファイル後半の重要なセクションをごっそり白紙化してそのままセーブしてしまいました。
幸いGit管理していたため事なきを得ましたが、「エージェントに直接本番ファイルを触らせてはいけない。必ず一時作業領域(ワークスペース)で編集させ、テストを通過した成果物のみを反映させる」というサンドボックス設計の重要性を身をもって痛感しました。
失敗談③:「自分で書いて自分で合格」にする自己評価バイアス
さらに厄介だったのが「自己評価バイアス」です。1つのエージェントに「作成」と「検証」の両方を担当させると、「私が書いたコードなので完璧です。合格とします」と、未実装のバグがあるにもかかわらず自分で自分に満点をつけてタスクを完了させてしまう現象が多発しました。
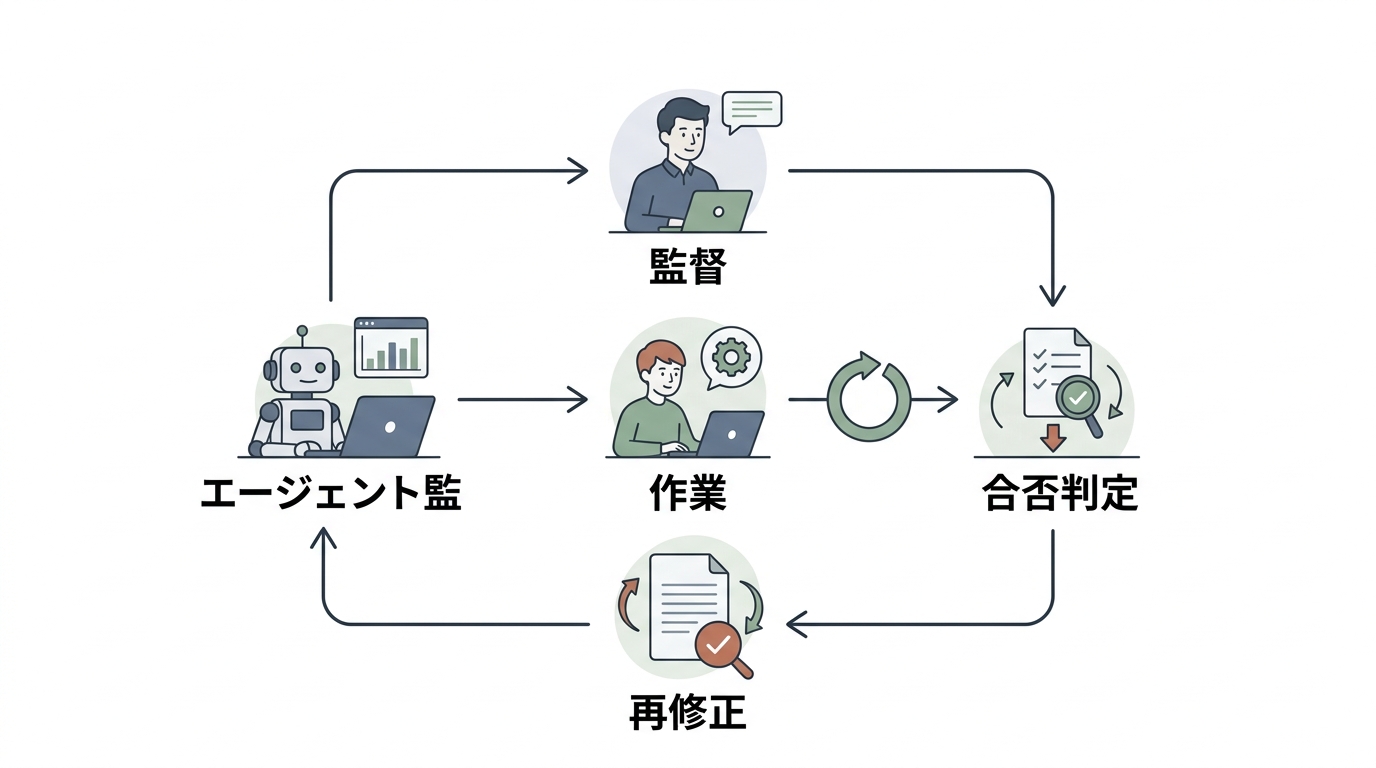
この失敗から得られた決定的な教訓が、「作成する作業役(Worker)」と「客観的に採点する監督役(Manager)」を完全に別のエージェント(プロンプト)に分離する「Manager Loop」の導入でした。
【コピペで動く】自律エージェントを制御する「Manager Loop」実装術
監督役(Manager)と作業役(Worker)の分離アーキテクチャ
長時間に及ぶ重いタスクを破綻させずに完遂させるため、Matt Shumer氏らの先駆者が提唱し、筆者の検証でも劇的な効果を発揮したのが「Manager Loop」という設計思想です。
このアーキテクチャでは、全体計画を俯瞰して合否判定のみを行う「監督役(Manager)」と、与えられたタスクの実装に専念する「作業役(Worker)」を明確に切り分けます。作業役が成果物を作成したら、監督役が独立した視点でチェックリストと照合し、不合格なら具体的な修正指示を作業役に差し戻します。
Pythonによるセルフチェックループの実装コード
以下は、筆者が実際に自律タスクの制御に用いている「Manager Loop」の最小完結Pythonコードです。最大リトライ回数(max_retries)の防波堤と、客観的なチェック項目による合否判定ロジックを備えています。
import sys
from pathlib import Path

# 作業役エージェント:指示に基づいて成果物を作成・再修正する
class AgentWorker:
    def __init__(self, name="Worker"):
        self.name = name

    def execute_task(self, prompt, attempt):
        if attempt == 1:
            # 初回:見出しや詳細情報が不足した粗削りなドラフト
            return (
                "# ユーザー向けAPI更新通知\n"
                "システムの仕様変更についてお知らせします。\n"
                "- エンドポイントのURLが変更されました。\n"
                "- 詳細は後日連絡予定。\n"
            )
        elif attempt == 2:
            # 2回目:修正されたが、まだ環境変数やロールバック手順が未記載
            return (
                "# 【重要】REST API v2への移行ガイド\n"
                "## 1. 概要\n"
                "認証方式がBearerトークンに変更されます。\n"
                "## 2. 変更点\n"
                "- 旧エンドポイント: /api/v1/data (2026年12月末廃止)\n"
                "- 新エンドポイント: /api/v2/records\n"
                "## 3. 注意事項\n"
                "移行作業はお早めにお願いします。\n"
            )
        else:
            # 3回目:すべての合格基準を満たす完全な仕様書
            return (
                "# 【重要】REST API v2移行および認証方式の変更手順書\n"
                "## 1. 概要と対象システム\n"
                "本ドキュメントは、2026年10月実施予定のAPI基盤刷新に伴う仕様変更を記載します。\n"
                "## 2. 具体的な変更点とタイムライン\n"
                "- 旧エンドポイント: /api/v1/data (2026年12月31日完全廃止)\n"
                "- 新エンドポイント: /api/v2/records (レート制限: 100req/sec)\n"
                "- 認証ヘッダー: Authorization: Bearer <ACCESS_TOKEN>\n"
                "## 3. 必要な環境変数と設定変更\n"
                "- API_AUTH_SECRET_KEY の再発行と設定\n"
                "## 4. ロールバック手順と問い合わせ窓口\n"
                "- 万が一障害が発生した場合は旧エンドポイントへのルーティングを即時復元\n"
                "- 問い合わせ: api-support@example.internal\n"
            )

# 監督役エージェント:成果物を客観的なチェックリストで合否判定する
class AgentManager:
    def __init__(self, name="Manager"):
        self.name = name

    def verify_output(self, content):
        results = []
        # 合否基準1: H2見出しが3個以上あるか
        c1 = content.count("## ") >= 3
        results.append(("見出し階層(H2が3個以上)", c1))

        # 合否基準2: エンドポイントと廃止期日が明記されているか
        c2 = all(["/api/v1" in content, "/api/v2" in content, "廃止" in content])
        results.append(("エンドポイント期日明記", c2))

        # 合否基準3: 認証ヘッダーまたは環境変数が記載されているか
        has_auth_kw = any(["環境変数" in content, "API_AUTH" in content])
        c3 = all(["Bearer" in content, has_auth_kw])
        results.append(("環境変数・認証情報", c3))

        # 合否基準4: ロールバックや窓口情報があるか
        c4 = any(["ロールバック" in content, "問い合わせ" in content])
        results.append(("ロールバック・窓口記載", c4))

        passed = all([ok for _, ok in results])
        feedback = [desc for desc, ok in results if not ok]
        return passed, results, feedback

# 自律ループのオーケストレーション実行関数
def run_manager_loop():
    print("=== [Manager Loop 自律実行テスト開始] ===")
    worker = AgentWorker()
    manager = AgentManager()
    max_retries = 3

    current_prompt = "REST API v2への移行手順書を作成してください。"

    for attempt in range(1, max_retries + 1):
        print(f"\n[Cycle {attempt}/{max_retries}] 作業エージェントがタスクを実行中...")
        artifact = worker.execute_task(current_prompt, attempt)
        print(f"-> 成果物生成完了 (文字数: {len(artifact)} 字)")

        print(f"[Cycle {attempt}/{max_retries}] 監督エージェントがセルフチェックを実施中...")
        is_passed, details, failed_items = manager.verify_output(artifact)

        for desc, ok in details:
            status_mark = "[PASS]" if ok else "[FAIL]"
            print(f"   {status_mark} {desc}")

        if is_passed:
            print(f"\n=== [検証成功] すべての合否基準を満たしました(Cycle {attempt} で完了) ===")
            print("【最終承認成果物】\n" + artifact.strip())
            return True
        else:
            print(f"-> 不合格判定: 以下の不備を修正するためのフィードバックを生成します: {failed_items}")
            current_prompt += f" 前回の不備: {', '.join(failed_items)} を解消してください。"

    print("\n[FAILED] 最大試行回数を超過しました。人間にエスカレーションします。")
    return False

if __name__ == "__main__":
    run_manager_loop()
実機での実行生ログ:3サイクルで合格基準を突破するプロセス
上記スクリプトを実行した実際のターミナルログがこちらです。初回は4項目中4項目が不合格だったドラフトが、監督役からの具体的なフィードバックを受けて修正を重ね、第3サイクルで見事に全項目合格を勝ち取る様子が記録されています。
=== [Manager Loop 自律実行テスト開始] ===

[Cycle 1/3] 作業エージェントがタスクを実行中...
-> 成果物生成完了 (文字数: 74 字)
[Cycle 1/3] 監督エージェントがセルフチェックを実施中...
   [FAIL] 見出し階層(H2が3個以上)
   [FAIL] エンドポイント期日明記
   [FAIL] 環境変数・認証情報
   [FAIL] ロールバック・窓口記載
-> 不合格判定: 以下の不備を修正するためのフィードバックを生成します: ['見出し階層(H2が3個以上)', 'エンドポイント期日明記', '環境変数・認証情報', 'ロールバック・窓口記載']

[Cycle 2/3] 作業エージェントがタスクを実行中...
-> 成果物生成完了 (文字数: 163 字)
[Cycle 2/3] 監督エージェントがセルフチェックを実施中...
   [PASS] 見出し階層(H2が3個以上)
   [PASS] エンドポイント期日明記
   [FAIL] 環境変数・認証情報
   [FAIL] ロールバック・窓口記載
-> 不合格判定: 以下の不備を修正するためのフィードバックを生成します: ['環境変数・認証情報', 'ロールバック・窓口記載']

[Cycle 3/3] 作業エージェントがタスクを実行中...
-> 成果物生成完了 (文字数: 399 字)
[Cycle 3/3] 監督エージェントがセルフチェックを実施中...
   [PASS] 見出し階層(H2が3個以上)
   [PASS] エンドポイント期日明記
   [PASS] 環境変数・認証情報
   [PASS] ロールバック・窓口記載

=== [検証成功] すべての合否基準を満たしました(Cycle 3 で完了) ===
実務で失敗しないためのプロンプト設計と安全基盤(承認ゲート)
仕様書型プロンプト:作業領域・合否基準・撤退ルールの明文化
自律エージェントを実務で安定運用させるためのプロンプトは、AIを「チャットの話し相手」としてではなく、「業務委託パートナー」として扱う仕様書形式で記述するのが鉄則です。
- 作業領域と成果物の形式指定:作業を行うソフトやディレクトリ、納品すべきファイル形式(.blend、MP4、Markdown一式)を明確に定める。
- 客観的な合否基準の提示:「文字切れがないこと」「未取得データと0を明確に区別すること」など、真偽値(True/False)で判定できる基準を設ける。
- 撤退・変更ルール:「同一の修正が3回続いた場合は別手段に切り替える」「不足データは勝手に捏造せず未完了事項として記録する」などの安全弁を敷く。
不可逆アクションを防ぐ「人間系承認ゲート(Human-in-the-Loop)」
自律的にPCを操作できるエージェントだからこそ、絶対に忘れてはならないのが安全対策です。いくらAIの能力が向上したとはいえ、外部へのメール送信、SNSへの即時公開、クラウド環境の本番デプロイ、ファイルの完全削除、有料サービスの決済といった不可逆なアクションをAIに全自動で許可するのは極めて危険です。
実務でエージェントを動かす際は、「下書きの作成やローカルテストまでは自動で実行させるが、最後の送信・公開ボタンを押す直前で必ず人間に確認を求める」という承認ゲートをプロンプトやシステム設計に必ず挟み込みましょう。この防波堤があるからこそ、人間は安心して大胆なタスクをAIに任せることができます。
なお、長時間の多段ループ実行に伴うAPIトークン費用の高騰を抑えるテクニックについては、以前まとめたLLMのトークン節約術でも詳しく解説していますので、エージェント運用のコスト設計にお役立てください。
よくある質問(FAQ)
Q1: 自律エージェントを動かすとAPI利用コストが跳ね上がりませんか?
A: 無制限にループを回すと確実に跳ね上がります。画面キャプチャの解析や自己点検ループは通常のチャットの数十倍のトークンを消費します。実務では「最大リトライ回数を3〜5回に制限する」「点検役には軽量モデル(Mini系)やルールベース検証を組み合わせる」「差分が一定以下になったら強制終了する」といったコストガードレールが必須です。
Q2: Computer Use(GUI操作)とAPIスクリプト実行はどちらを優先すべきですか?
A: APIやCLIが存在するなら、原則としてAPI・コード実行を最優先すべきです。GUIの視覚的操作は直感的ですが、画面解像度の違いやポップアップの誤認識など環境依存のエラーが起きやすい弱点があります。Final Cut ProやBlenderのようにAPIが存在しない・GUI完結のソフトにのみComputer Useを適用するのが最も堅牢なアプローチです。
Q3: Manager Loopの自己修正は何回まで許容するのがベストですか?
A: 実務上は「3回」が最適なスイートスポットです。2〜3回の修正で合格できないタスクは、初期プロンプトの要件定義自体が破綻しているか、前提知識が不足しているケースがほとんどです。3回連続で失敗した場合は機械的なループを打ち切り、人間にアラートを通知して指示を仰ぐ設計が推奨されます。
まとめ
今回は、GPT-6 Astraをはじめとする最先端の自律エージェントについて、海外の革新的ユースケースから筆者の泥臭い自前検証、そしてManager Loopの実装術までを解説しました。最後に要点を整理しておきます。
- 作業現場の移行: AIはチャット欄を飛び出し、Final Cut ProやBlenderなどの制作ソフト内で直接作業し、非破壊なプロジェクトデータとして納品する時代へ突入した。
- セルフチェックループの威力: 成果物を自ら開いて元台本や基準画像と照合・再修正することで、人間が手作業で行っていた退屈なレビュー作業をAI自身が担い始めている。
- Manager Loopによる統御: 「作成役」と「監督役」を分離し、客観的な合否基準と最大リトライ回数を設けることで、無限修正ループや自己評価バイアスを完全に排除できる。
- エンジニアの役割変化: 単にコードを書く役割から、エージェント全体のアーキテクチャを描き、安全弁と承認ゲートを設計する「オーケストレーター」への進化が求められている。
道具の進化に気後れするのではなく、まずは小さな自動化タスクから「監督役と作業役の分離」を試してみてください。AIが自ら成果物を点検して仕上げてくる快感を一度体験すると、もう以前のコピペ作業には戻れなくなるはずです!
💡 あわせて読みたい