「社内のマニュアルやNotion、PDF文書を検索して回答してくれる社内向けRAG(検索拡張生成)チャットボットを構築したものの、実際に全社公開してみたら『全く関係ない規則を引用して堂々と嘘をつく』『欲しい情報が全然返ってこない』とクレームが殺到し、どこを改善すればいいのか分からない…」
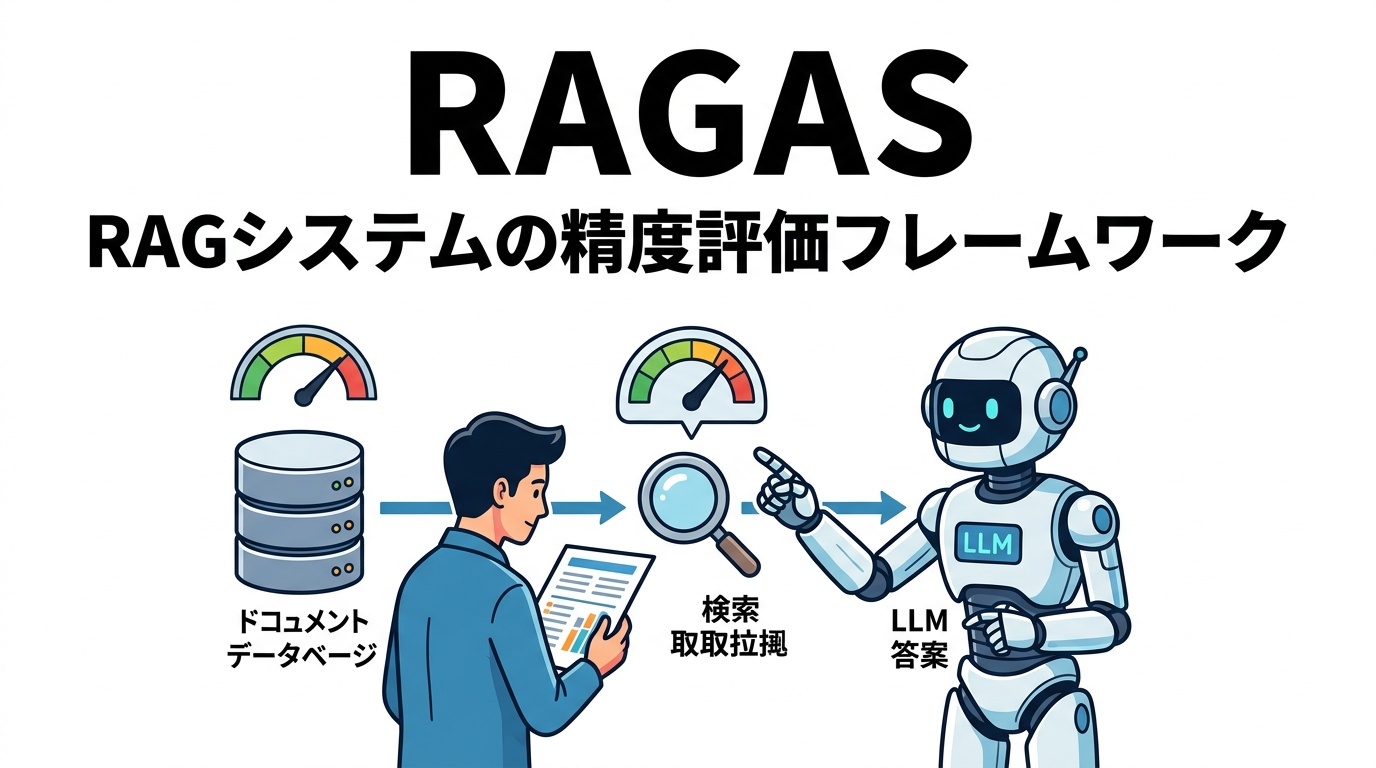
社内ナレッジの活用やカスタマーサポートの自動化でRAGシステムを導入したエンジニアなら、誰もが一度は直面する深い悩みです。前回の第10回:SWE-benchでは実務リポジトリのバグ修正能力を検証しましたが、連載第4弾「実務タスク・特化領域指標編」のラストを飾る今回は、企業のAIシステムで最も普及しているアーキテクチャを正しく診断・評価する救世主「RAGAS:RAG精度評価フレームワーク」を取り上げます。親記事のLLM評価指標の完全総覧【全体俯瞰編】でも、社内実務運用の成否を分ける最重要メトリクスとして位置づけました。
結論から言うと、「RAGASは、RAGシステムの内部を『検索[Retrieval]』と『生成(Generation)』の2つの独立したプロセスに解剖し、ハルシネーションの有無や検索ノイズの混入度合いを4つの客観指標で自動数値化するオープンソースの標準フレームワーク」です。
この記事では、人間による手動チェックの限界を打ち破るRAGASの4大指標(Faithfulness, Answer Relevance, Context Precision, Context Recall)の計算メカニズムから、障害原因を一発で見極めるトラブルシューティング診断表、そして現場で導入するPythonコードまでを徹底解説します!
なぜRAGの評価は難しいのか?「ブラックボックス」を解剖するRAGASの思想
BLEUや正解率(Accuracy)が使えない理由
通常のQAタスクであれば、「人間が書いた模範解答」とモデルの出力がどれくらい一致しているかを比較すれば評価できました。しかし、実務のRAGシステムにおいてこの手法は破綻します。
なぜなら、同じ「交通費の精算ルール」を尋ねる質問であっても、要約の粒度や言い回しは無数に存在し、単語の一致率(BLEUやROUGE)では回答の正しさを測れないからです。さらに致命的なのは、「回答がおかしい時、検索が悪いのか? それともLLMの生成が悪いのか?」という原因の切り分けがブラックボックスになってしまう点です。
- ケースA(検索の失敗): データベースから無関係な文書チャンクを拾ってきてしまったため、LLMがいくら賢くても的外れな回答しか出せなかった。
- ケースB(生成の失敗): 完璧なマニュアルが取得できていたのに、LLMが勝手な推測を付け足してハルシネーション(嘘)を出力してしまった。
この2つの障害は、対策(検索モデルの改善か、プロンプトの調整か)が180度異なります。そこでRAGASでは、RAGのパイプラインを「検索[Retrieval]」と「生成(Generation)」に完全に分離し、それぞれを独立した2大指標で採点します。
【核心】RAGASを支える4大指標とステップ計算メカニズム
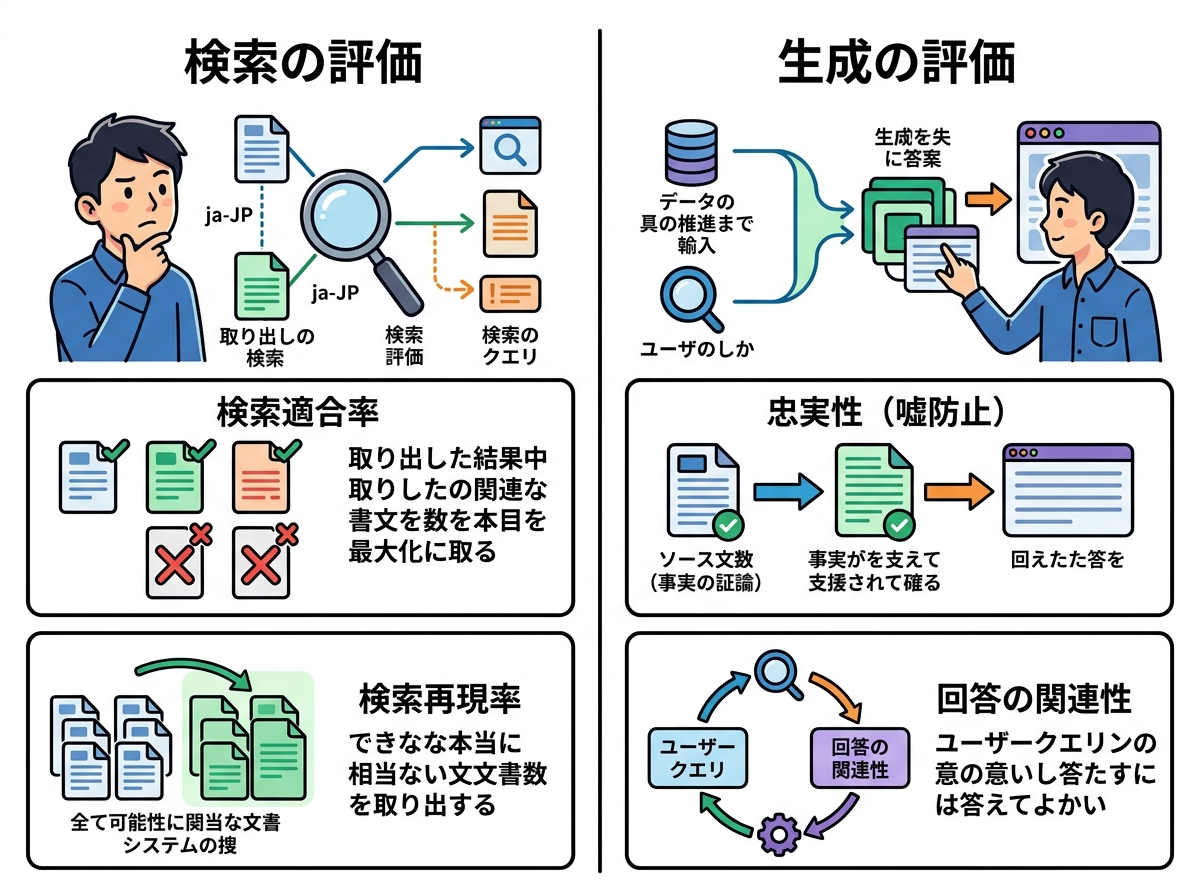
RAGASが提供する4つのコア指標は、下表のように美しい直交関係(2×2マトリクス)になっています。
| 評価対象 | 指標名 | 測定する問い(何を検証するか) | 正解データ(Ground Truth)の要否 |
|---|---|---|---|
| 生成(Generation) | Faithfulness(忠実性) | 検索された文書だけに基づいて回答しているか?(嘘・ハルシネーションの排除) | 不要(文書と回答のみで測定) |
| Answer Relevance(回答関連性) | ユーザーの質問に対して的確に答えているか?(脱線・的外れの排除) | 不要(質問と回答のみで測定) | |
| 検索[Retrieval] | Context Precision(コンテキスト適合率) | 必要な情報が検索結果の上位にランキングされているか?(ノイズの排除) | 必要(正解文または正解コンテキスト) |
| Context Recall(コンテキスト再現率) | 正解に必要な情報が検索結果の中に漏れなく含まれているか?(検索漏れの排除) | 必要(正解文 Ground Truth) |
特筆すべきは、「Faithfulness」と「Answer Relevance」の2大指標は、人間が苦労して正解データ(Ground Truth)を用意しなくても、日々の本番運用ログから自動計算できる点です。それぞれの具体的な計算ステップを見ていきましょう。
1. Faithfulness(忠実性):ハルシネーション(幻覚)の撲滅
モデルが「取得したコンテキスト情報のみ」に基づいて発言しているかを測る、RAGにおいて最も重要な指標です。
【Faithfulness の計算ロジック】
- 主張の分解: LLMを使って、生成された回答を独立した「文・主張(Statement)」に箇条書き分割する。
- 論理的裏付け検証: 各主張について、「検索されたコンテキストから論理的に演繹できるか?」を判定(Yes or No)。
- スコア算出:
裏付けられた主張の数 ÷ 全主張の総数
具体例: AIが「①出張旅費は事前申請が必要です。②日当は一律3,000円支給されます。③申請は領収書原本を郵送してください。」という3つの主張を回答したとします。社内マニュアルに①と②の記載はあったが、③は社内システムでの電子申請(AIのハルシネーション)だった場合、スコアは 2 / 3 = 66.7% となります。
2. Answer Relevance(回答関連性):的外れな回答の検知
質問の意図から外れた「頼んでもいない長文解説」や「脱線した回答」をペナルティ化する指標です。
RAGASの非常にユニークな点は、「生成された回答から、LLMを使って逆質問(この回答が答えになり得る質問)を複数生成させる」というアルゴリズムです。逆生成された質問群と、ユーザーが入力した元の質問を埋め込みベクトル(Embedding)に変換し、コサイン類似度の平均値をスコアとします。
例えば、「有給休暇の申請期限はいつまでですか?」と聞いたのに、AIが「有給休暇は勤続半年後に10日付与され…」と付与日数のマニュアルをそのまま返した場合、逆質問は「有給は何日付与されますか?」となり、元質問とのベクトル類似度が著しく低下して低いスコアが付きます。
3. Context Precision(コンテキスト適合率):検索結果の上位度
正解に必要なコンテキストが、検索結果のトップ(1位や2位)に正しくランキングされているかを評価します。情報検索分野の評価指標である MAP(Mean Average Precision)と同様の重み付け計算を行います。
たとえ検索結果の5件目に関連文書が含まれていても、1〜4件目が無関係なゴミ文書だった場合、LLMはノイズに惑わされて回答精度を落とします(Lost in the Middle現象)。上位に関連文書が集まっているほど高いスコアが与えられます。
4. Context Recall(コンテキスト再現率):情報の網羅性
人間が設定した模範解答(Ground Truth)を作成するために必要な情報が、検索結果の中にどれだけカバーされているかを測定します。
正解文を最小単位のファクト(Fact)に分解し、そのうち何割が検索コンテキスト群に記載されているかを カバーされたファクト数 ÷ 正解の全ファクト数 で算出します。これが低い場合、どれだけ生成AIのプロンプトを工夫しても、そもそも材料が足りないため絶対に満点の回答は作れません。
4大指標で一発特定!RAGのボトルネック診断マトリクス
RAGASの4つの数字が出揃うと、システムが抱える弱点と「次に打つべき具体的なエンジニアリング処方箋」が一目で特定できます。
🔍 RAGトラブルシューティング診断フローチャート(症状別の処方箋)
【生成側の課題】Faithfulness 低下
症状: 検索文書にない嘘・創作を語る
処方箋: プロンプトの回答制約強化 / Temperature を 0.0 に固定
【生成側の課題】Answer Relevance 低下
症状: 質問意図から脱線した長文引用
処方箋: 回答フォーマットの限定 / クエリ書き換え(Query Rewriter)
【検索側の課題】Context Precision 低下
症状: ゴミ文書が検索上位に混ざる
処方箋: リランカー(Cohere / bge-reranker)の導入
【検索側の課題】Context Recall 低下
症状: 必要な正解情報が検索から漏れる
処方箋: チャンクサイズの縮小 / ハイブリッド検索(BM25+ベクトル)
| 指標の症状 | システムのボトルネック | エンジニアが取るべき具体的処方箋 |
|---|---|---|
| Faithfulness が低い | 生成モデルのハルシネーション(勝手な創作) | プロンプトに「提供された文書に書かれていないことは絶対に答えるな」と厳命する。モデルの温度パラメータ(Temperature)を0.0に下げる。 |
| Answer Relevance が低い | 質問意図の無視・関係のない長文引用 | システムプロンプトで「質問に端的に答えよ」と回答形式を制限する。質問の言い換え(Query Rewriting)を導入する。 |
| Context Precision が低い | 検索結果に無関係なノイズが多く上位に来ている | ベクトル検索の後にリランカー(Cohere Rerankやbge-reranker等)を導入し、関連度の高いチャンクをトップに再配置する。 |
| Context Recall が低い | 検索漏れ(必要な文書チャンクがヒットしない) | チャンク分割サイズ(Chunk Size)を小さくしオーバーラップを増やす。ハイブリッド検索(BM25キーワード検索+ベクトル検索)を導入する。 |
Pythonコードで動かす!RAGAS評価の最小実装例
RAGASはPythonライブラリとして提供されており、わずか十数行のコードで手元の評価データセットを即座に採点できます。
内部では評価エンジン(Judge)としてOpenAIのGPT-4oやClaudeなどが呼び出され、文章の分解や論理推論判定が自動的に実行されます。CI/CDパイプラインにこのスクリプトを組み込んでおけば、「ドキュメントを更新したりプロンプトを変更した際に、RAGの回答精度が落ちていないか」を自動でリグレッションテストすることが可能です。
なお、評価用LLMのAPIコストを抑えつつ評価パイプラインを運用する具体的な工夫については、以前書いたLLMのトークン節約術でも詳しく紹介しています。
よくある質問(FAQ)
Q1: 正解データ(Ground Truth)を用意する時間がありません。RAGASは使えませんか?
A: 問題なく使えます。RAGASの4大指標のうち「Faithfulness(忠実性)」と「Answer Relevance(回答関連性)」の2つは、正解データ(Ground Truth)を一切必要としません。本番環境でユーザーが入力した質問、検索された文書、生成された回答の3点さえログに保存しておけば、日々の運用ログからリアルタイムでハルシネーション率を自動監視・ダッシュボード化することが可能です。
Q2: 日本語の社内マニュアルでも正確に採点できますか?
A: はい、高精度に採点できます。ただし、デフォルトの評価LLM(Judge)やEmbeddingモデルに安価な英語特化モデルを指定してしまうと、日本語の助詞や文脈のニュアンス判定でブレが生じることがあります。評価用LLMには日本語理解力の高いモデル(GPT-4oやClaude 3.5 Sonnet)を指定し、Embeddingモデルにも日本語対応の多言語モデル(text-embedding-3-large や bge-m3 等)を指定して評価することをおすすめします。
まとめ
今回は、社内文書QAや検索拡張生成の品質を科学的に診断・数値化する標準フレームワーク「RAGAS」について、4大指標の計算ロジックから実務での処方箋までを解説しました。要点を振り返ってみましょう。
- 検索と生成の分離評価: RAGの不具合が「検索(材料集め)」にあるのか「生成(調理)」にあるのかを切り分けて客観判定。
- 4大コア指標:
- Faithfulness: 文書に書かれた事実のみを述べているか(ハルシネーション検知)。
- Answer Relevance: 質問に対して的確に答えているか(脱線・的外れ検知)。
- Context Precision: 役立つ文書が検索上位に並んでいるか(ランキング品質)。
- Context Recall: 正解に必要な情報が漏れなく集まっているか(網羅率)。
- 本番運用の自動監視: Ground TruthがなくてもFaithfulnessとAnswer Relevanceは算出可能。CI/CDや本番ログ監視に最適。
ここまでで、連載第4弾「実務タスク・特化領域指標編」の3大テーマ[HumanEval、SWE-bench、RAGAS]をすべて完走しました!
次回からは、連載の最終コーナーとなる第5弾「事実性・安全性・運用指標編」へと進みます。第12回は、モデルがもっともらしく語る嘘や都市伝説トラップを暴くベンチマーク「第12回:TruthfulQAとHaluEvalで暴くLLMの嘘!ハルシネーション測定法」を解説します。お楽しみに!