社内の業務自動化やチャットボット開発でLLMを使っているとき、「売上データの集計や割引キャンペーンの計算を頼んだら、途中で条件を取り違えてトンデモな合計金額を返してきた…」という経験はありませんか?「文章はあんなに滑らかなのに、なぜ簡単な算数や論理パズルでポロッと間違えるんだろう?」と不思議に思ったエンジニアも多いはずです。
前回の第3回:MMLU & MMLU-Pro徹底解剖では、大学入試レベルの幅広い学術知識を測るテストを解説しました。連載第4回となる今回は、AIが「複雑な前提条件を正しく把握し、多段階の思考ステップを踏んで答えを導けるか」を厳密にテストする数学的推論ベンチマークの金字塔、GSM8kとMATHを徹底解説します。親記事のLLM評価指標の完全総覧【全体俯瞰編】でも推論力テストの中核として位置づけた重要指標です。
結論から言えば、「GSM8kは、小学校レベルの算数文章題から多段階の計算ステップ(立式)を論理破綻なく組み立てられるか」を測り、「MATHは、高校数学から数学オリンピック級の高度な概念操作や厳密な証明ができるか」を測るテストです。この記事では、なぜ算数文章題がAIにとって最大の難関だったのか、そして実務で業務ロジックを組む際にどう活かすべきかを分かりやすく紐解きます!
GSM8kとは何か?なぜ「小学校の算数」がAIにとって難問なのか
単なる計算力ではなく「言語から数式への翻訳力」を測る
GSM8k(Grade School Math 8K)は、2021年にOpenAIの研究チームによって提案された、8,500問の高品質な小学校レベルの算数文章題データセットです。
「たかが小学校の算数なら、AIにとっては朝飯前では?」と思われがちですが、実はこれが言語モデルにとって極めて高い壁でした。なぜなら、電卓のように「1234 × 5678」を計算させるのではなく、「日常の文章から状況を正しく把握し、解くために必要なステップを自ら組み立てる能力」が求められるからです。
問題文の中には、解答に関係のないノイズ情報が含まれていたり、暗黙の前提(1週間は7日、1ダースは12個など)が隠されていたりします。GSM8kは、言語モデルがただ言葉を暗記しているだけなのか、それとも言葉の裏にある「論理的な因果関係」を理解して立式できているのかを暴き出すリトマス試験紙なのです。
【実例検証】GSM8kの典型的な多段階思考ステップ
具体的にどのような問題が出題され、どう思考するのか、身近な例題でシミュレーションしてみましょう。
【GSM8kスタイルの典型例題】
問題: 鈴木さんはベーカリーで1個160円のクロワッサンを4個、250円のカフェラテを2杯買いました。お店の500円割引クーポンを利用し、残りの支払いを友人と2人で均等に割り勘することにしました。鈴木さんが支払う金額は何円でしょうか?
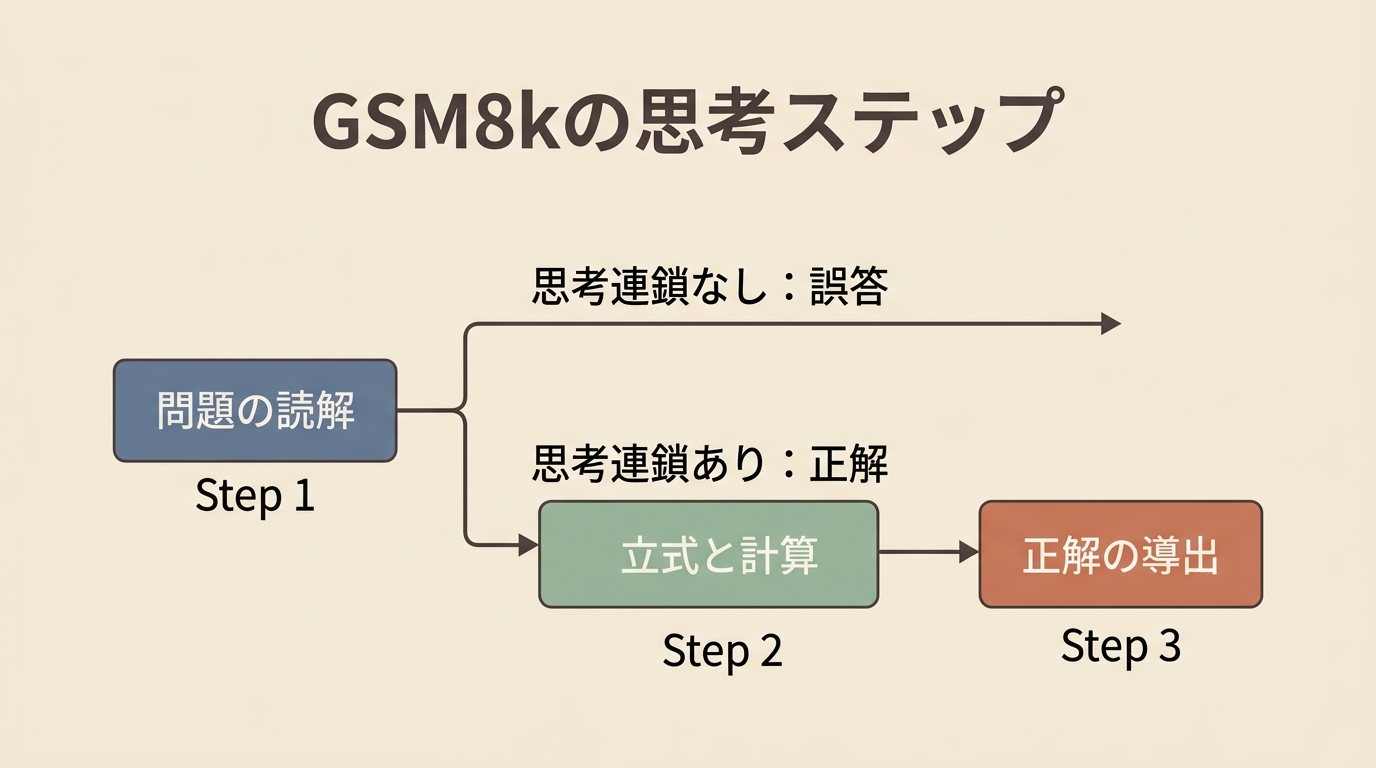
この問題を正しく解くためには、モデルは以下の5つの論理ステップを順番に連鎖させる必要があります。
- ステップ1(パンの小計): 160円 × 4個 = 640円
- ステップ2(飲み物の小計): 250円 × 2杯 = 500円
- ステップ3(合計金額の計算): 640円 + 500円 = 1,140円
- ステップ4(割引の適用): 1,140円 - 500円 = 640円
- ステップ5(割り勘の計算): 640円 ÷ 2人 = 320円
人間なら当たり前に解ける計算ですが、LLMが一発で答えを出そうとすると、ステップ2を飛ばしてしまったり、割引を引く前に割り勘してしまったりと、途中の論理連鎖が破綻して誤答を連発していました。途中のステップが1つでも狂えば最終回答が0点になるため、多段階推論の精度を評価するのに最適なベンチマークとなったのです。
MATHベンチマークの凄み:高校数学から数学オリンピックへの跳躍
全7分野・難易度レベル1〜5の超難関テスト
GSM8kが「小学校レベルの基礎思考力」だとすれば、その遥か高みに君臨する最難関ベンチマークが「MATH」です。2021年にUCバークレーのDan Hendrycks氏らによって発表されました。
アメリカの高校数学競技会(AMC 10、AMC 12、AIME)などから収集された12,500問で構成されており、初等代数、代数、幾何、数論、数え上げ・確率、中間代数、微積分の全7分野をカバーしています。各問題には難易度レベルが1(標準)から5(数学オリンピック級の超難問)まで設定されています。
MATHの最大の特徴は、選択肢を選ぶマークシート方式ではなく、「最終的な数式や数値をLaTeX形式で正確に導き出さなければならない記述式」である点です。記号の変形、補助線を引くような幾何学的ひらめき、複雑な場合分けなど、本物の数学的知能が試されます。
なぜMATHが「AI推論のフロンティア」と呼ばれるのか
GPT-3.5が登場した当時、MATHベンチマークの正解率はわずか10%未満に過ぎませんでした。大学レベルの知識を問うMMLUで70%を取れていたモデルでも、MATHの難問の前には手も足も出なかったのです。
しかし、GPT-4で約50%前後、そして思考時間を動的に使って自己修正を行う最新の推論特化モデル(OpenAI o1など)の登場によって、正解率は一気に70%〜80%超えという異次元の領域へと突入しました。現在では、最先端LLMの推論限界をテストする最高峰の指標として世界中から注視されています。
💡 あわせて読みたい
Chain-of-Thought(CoT)の威力:なぜ「一呼吸置く」と解けるのか?
「ステップ・バイ・ステップで考えよう」が起こした大革命
GSM8kやMATHのスコア向上を語る上で欠かせないのが、Chain-of-Thought(CoT:思考の連鎖)という技術です。
プロンプトの末尾に「Let’s think step by step(一歩ずつ順を追って考えよう)」と一言添えるだけで、モデルの正解率が劇的に跳ね上がったという現象は世界中に大きな衝撃を与えました。
なぜこの一言で急激に賢くなるのでしょうか?言語モデルは「直前に出力されたテキスト」を次の予測の文脈として利用します。いきなり「答えは320円です」と出力させようとすると、頭の中で一度も計算を保持する場所がないため失敗します。しかし、思考ステップを文章として出力させると、「自分が直前に計算した途中の数値を文脈(ワーキングメモリ)として再利用しながら次のステップに進める」ため、計算ミスや論理の脱線が劇的に減るのです。
以前書いたLLMのトークン節約術でも解説したように、思考プロセスを出力させることはトークン消費の増加を招きますが、複雑な推論においては不可欠な投資と言えます。
テスト時計算(Test-Time Compute)への進化
この考え方がさらに発展したのが、昨今の「テスト時計算(推論時計算量)」の最適化です。
モデルが回答を生成する際に、バックグラウンドで思考の枝を何本も探索し、途中で矛盾があれば自ら引き返して解き直す(Self-Correction)。この自己検証ループを徹底的に回すことで、MATHのような数学オリンピック難問でも人間の一流数学者に匹敵する解答を導き出せるようになっています。
実務でどう活かす?業務自動化における数学ベンチマークの正しい見方
実務の教訓:純粋な四則演算をLLM単体に任せてはならない
エンジニアとして実務システムを設計する際、GSM8kやMATHのスコアから何を学ぶべきでしょうか?現場で絶対に忘れてはならない教訓が1つあります。
それは、「どれほどGSM8kが満点に近いモデルであっても、純粋な四則演算や桁数の多い計算をLLM単体にやらせてはならない」ということです。
LLMはどこまで行っても「次に来るもっともらしいトークンを確率的に予測するニューラルネットワーク」です。電卓のように確定的なALU(演算装置)を内蔵しているわけではないため、8桁×8桁の掛け算や小数点以下の丸め処理などでは、確率的なズレによって平気で誤った数字を出力します。経理や在庫管理などの数字をLLMのテキスト出力だけで完結させるのは極めて危険です。
「LLMが立式し、Pythonが計算する」最強の実務アーキテクチャ
では、GSM8kの推論力は実務で役に立たないのかというと、全く逆です。実務における真の価値は「複雑な業務ルールを読み解いて、条件分岐や計算式を組み立てる力(立式能力)」にあります。
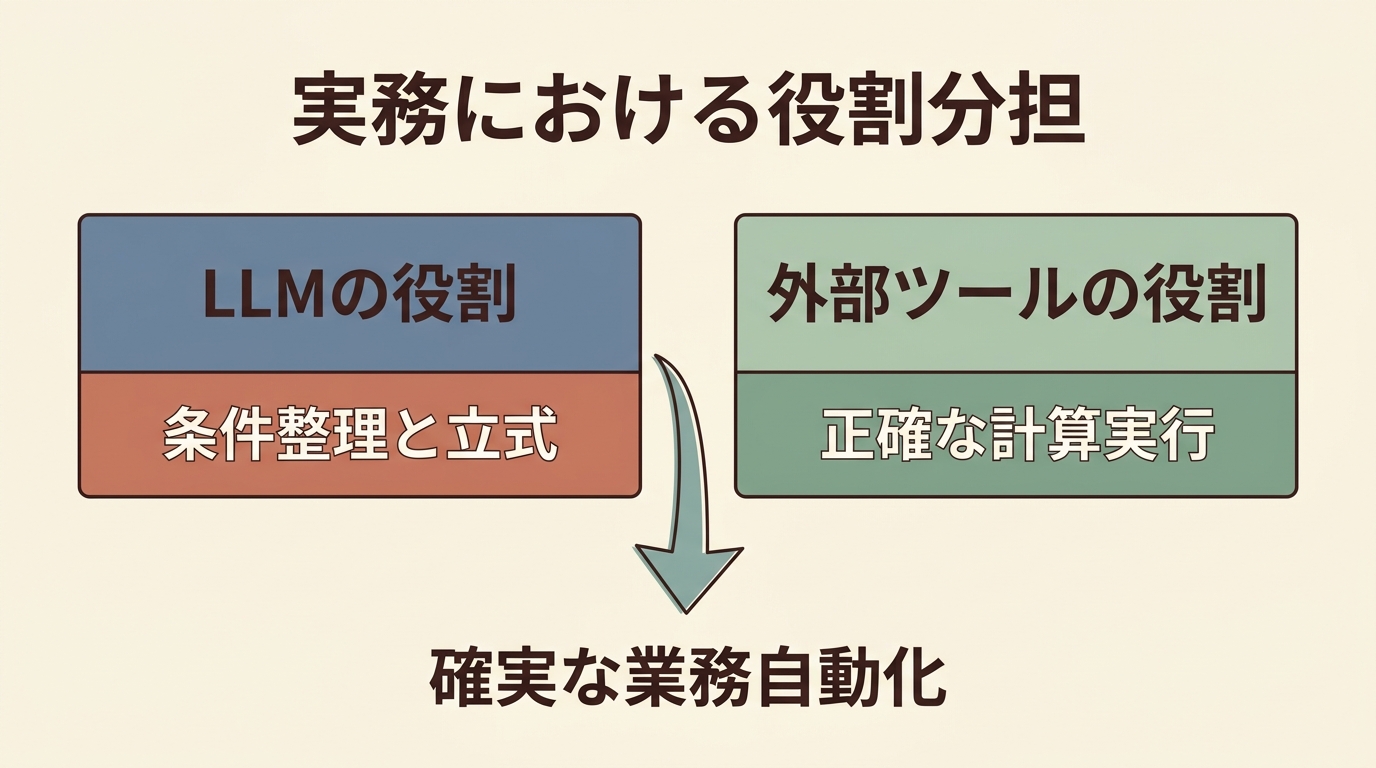
現場でのベストプラクティスは、以下のような「役割分担(Tool-Use / Code Interpreter)」アーキテクチャを採用することです。
- LLMの役割: ユーザーの自然言語や契約書から「どの条件のときに、どの計算式を適用すべきか」を論理的に整理し、Pythonの計算コードを生成する。
- 外部ツールの役割: 生成されたコードを安全なPythonサンドボックスや電卓ツールで実行し、100%正確な数値を確定的に算出する。
GSM8kやMATHのスコアが高いモデルほど、この「条件分岐の整理とコード生成」の精度が極めて高くなります。頭脳(ロジック)はLLMが担当し、手足(電卓)はプログラムが担当する。この切り分けこそが、AIによる業務自動化を成功させるカギとなります。
まとめ
今回は、LLMの多段階推論力を試す数学ベンチマーク「GSM8k」と「MATH」について、その出題の真意から実務への落とし込み方までを徹底解説しました。要点を整理しておきましょう。
- GSM8k: 小学校算数の文章題を通じて、問題文の読解から多段階の計算ステップ(立式)を論理的に組み立てられるかを測る指標。
- MATH: 高校数学から数学オリンピック(AIME)級の難問を記述式で出題し、記号操作や厳密な証明能力を試す最高峰テスト。
- CoT(思考の連鎖)の重要性: 思考ステップをトークンとして外出しすることで、直前の計算結果をメモリとして再参照し、推論精度が劇的に向上する。
- 実務でのアーキテクチャ: 計算そのものをLLMにやらせるのではなく、「LLMが論理を整理・立式し、Pythonコード実行で確定的な計算を行う」役割分担が鉄則。
数学的な思考力をクリアしたところで、次回はいよいよ最先端フロンティアモデルの思考限界を暴くGoogle検索耐性テスト、「第5回:GPQAとBBHの凄さ!最先端LLMの推論限界を暴く博士レベルベンチマーク」に進みます!こちらもぜひ楽しみにしていてくださいね。
💡 あわせて読みたい