社内ドキュメントやチャットログ、障害報告書などをAIに読み込ませてみたものの、「結局だれが、いつ、何を決定したんだっけ?」と尋ねると、関係のない断片をそれっぽく繋ぎ合わせたハルシネーションが返ってきて頭を抱えた経験はないでしょうか?
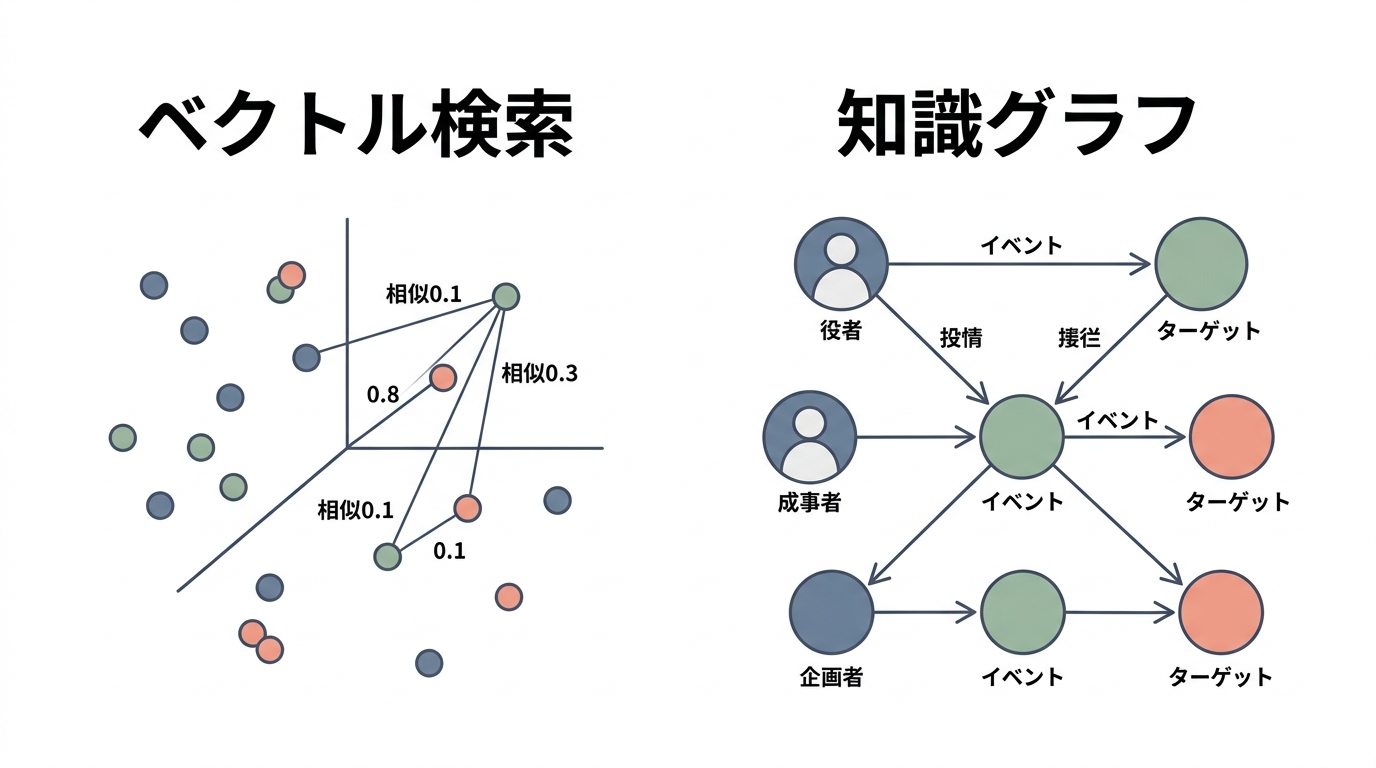
従来のベクトル検索(RAG)は、単語や文章の「意味の近さ(コサイン類似度)」を計算して最も近いテキストを拾い出す仕組みです。そのため、文章同士の因果関係や時間軸の前後関係、複数ステップにまたがる経緯を正確に追跡することが根本的に苦手でした。
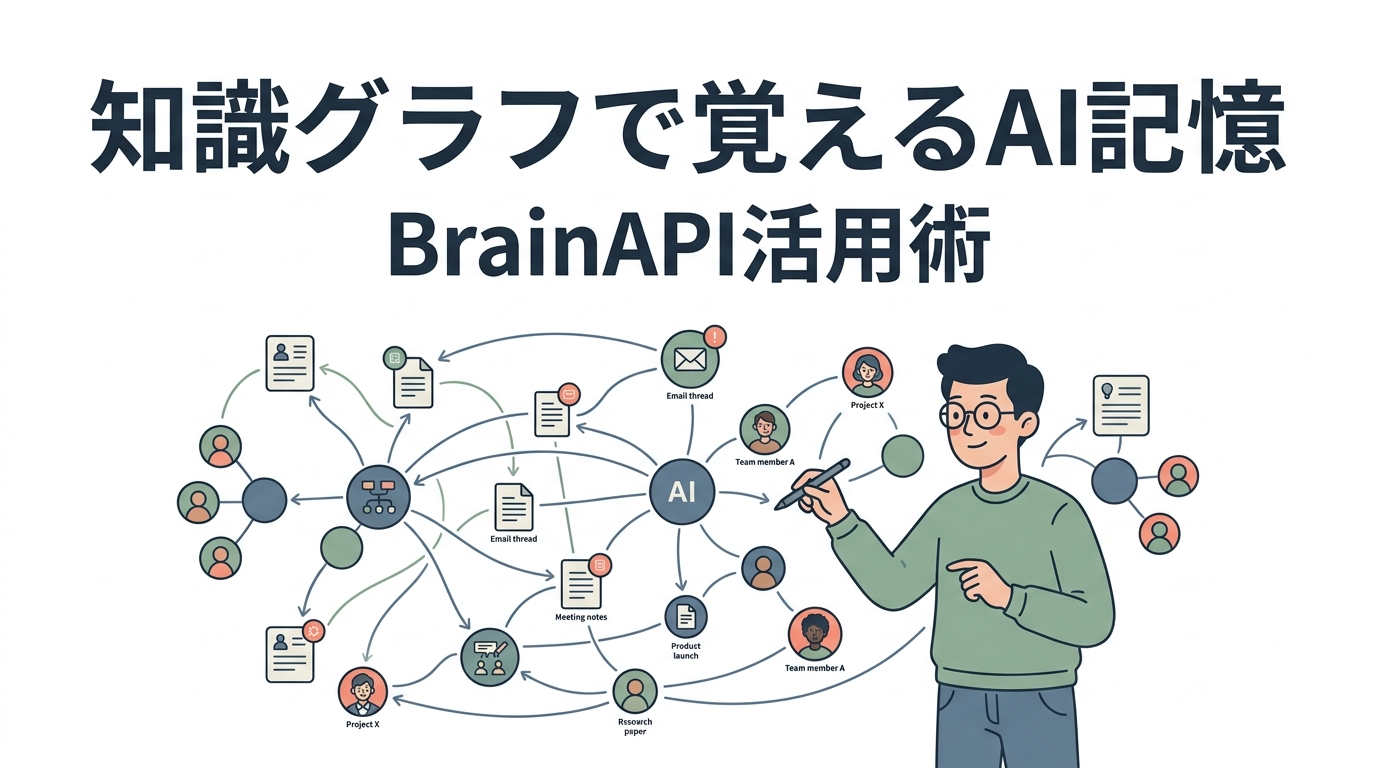
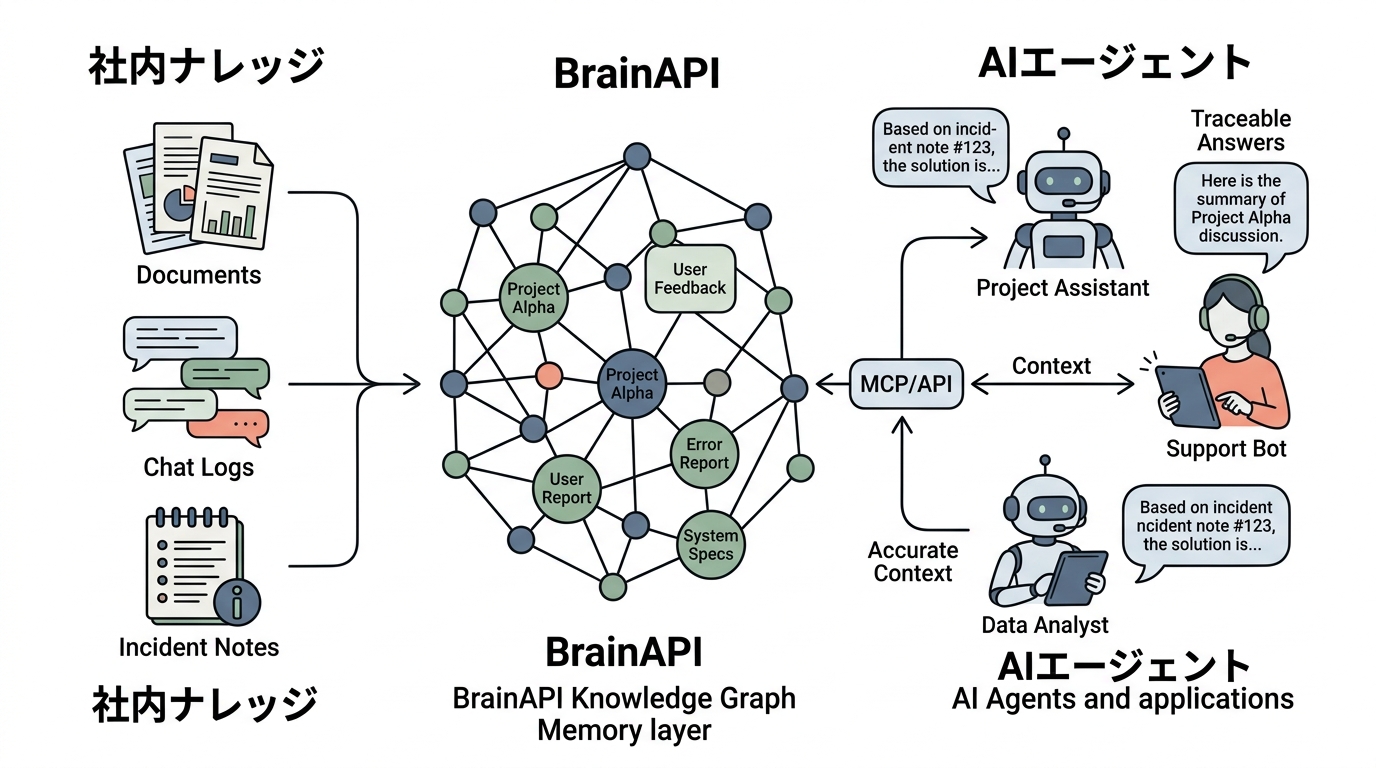
そんな課題を解決するアプローチとして登場したのが、文章から自動でナレッジグラフ(知識グラフ)を編み上げ、AIに根拠の追える長期記憶を与えるオープンソースの記憶レイヤー「BrainAPI」です。本記事では、BrainAPIが従来のRAGとどう異なり、実務の開発現場や自律型AIエージェントで具体的にどう活用していけるのかに重点を置いて詳しく解説します。
BrainAPIとは何か?「推測」から「歩けるグラフ」への転換
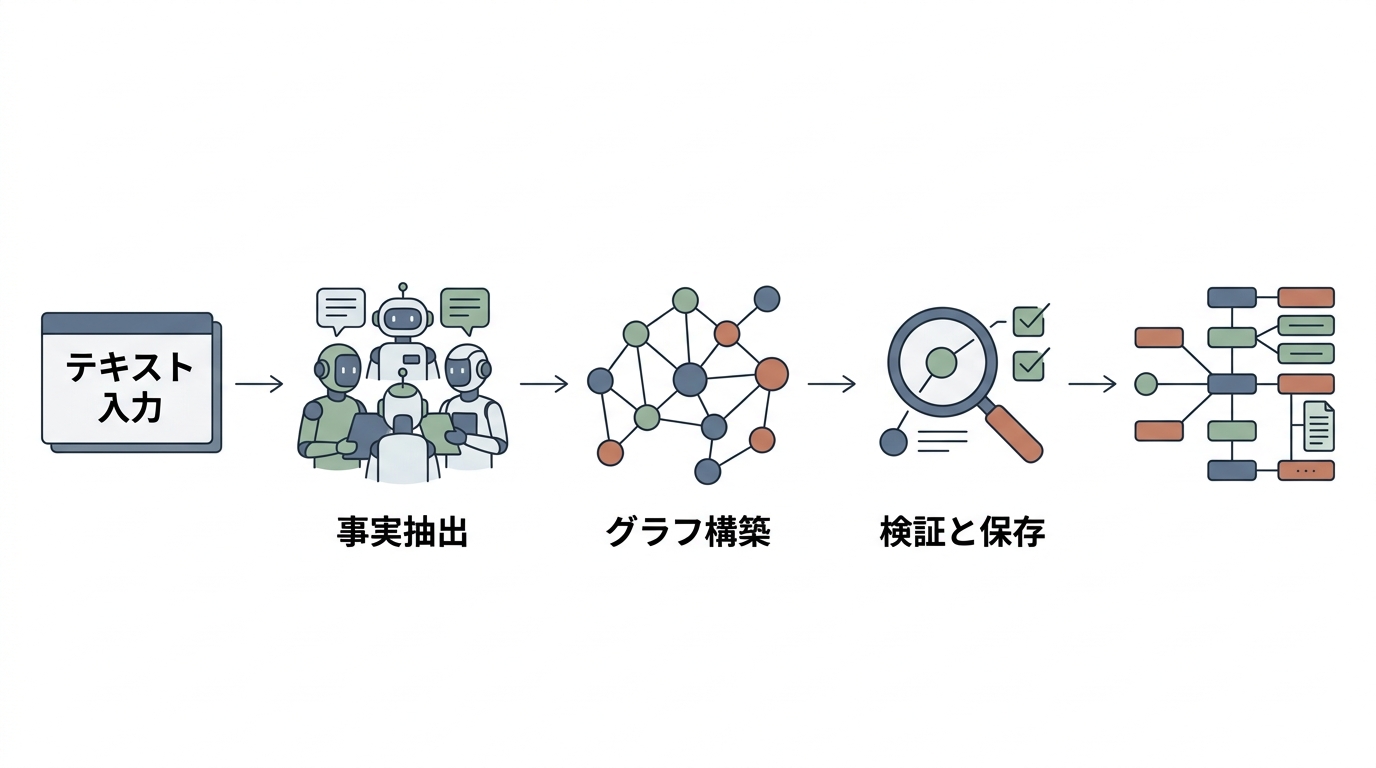
BrainAPIは、非構造化テキストを投入するだけで、裏側で動作する複数のAIエージェントが連携して「イベント中心の知識グラフ」を自律生成するAIメモリレイヤーです。私たちが普段扱っている自然言語のメモや日報、Slackのやり取りを渡すだけで、システムが自走して構造化されたグラフデータベースを構築してくれます。
最大の特徴は、単に「AとBが関連している」というフラットな関係性を記録するのではなく、「誰が(Actor)・どんな行動を起こし(Event)・何に働きかけ(Target)・どんな文脈や日時の下で起きたか(Context)」という4要素をひとつのイベントハブとしてモデル化する点にあります。開発元はこの構造を「帰属の三角形(Triangle of Attribution)」と呼んでいます。
たとえば、「エミリーが2024年3月8日にロンドンでAI倫理ミートアップを主催した」という文章を読み込ませた場合、BrainAPIは次のようなトリプル(主語・述語・目的語)のつながりとして保持します。
- 主体(Actor): エミリー(Emily)
- 行動ハブ(Event): 主催イベント(Organizing Event)
- 対象(Target): AI倫理ミートアップ(AI Ethics Meetup)
- 文脈・日時(Context): ロンドン(London) / 2024年3月8日
このモデル化によって、「2024年第1四半期にロンドンでAIイベントを企画したのは誰?」という、時間・場所・カテゴリを複合的に掛け合わせた質問に対しても、グラフのエッジをたどって確実な回答を導き出せます。ベクトル空間の「当て推量」ではなく、検証可能なグラフの歩行路(Walkable Path)として答えが得られるのが決定的な強みです。
従来技術との違い — ベクトルRAG・既存GraphRAGとの徹底比較
ベクトル検索とナレッジグラフは何が違うのか?
一般的なベクトルRAGでは、文章を一定の文字数で区切って(チャンキング)、高次元ベクトルに変換して類似度を計算します。しかし、この方式では「時系列の変化」や「主語と述語の正確な結びつき」が埋もれてしまいがちです。以前書いたAIコーディングやプロンプト最適化の知見でも触れたように、LLMに渡すコンテキストの精度が低ければ、いくら高性能なモデルを使っても精度の高い回答は得られません。
BrainAPIは、過去の事実を上書きせずに新しい出来事をノードとして追加していく「追記専用(Append-only)」の設計思想を採っています。これにより、「以前は仕様Aだったが、先週のミーティングで仕様Bに変更された」という事実の変遷(来歴)をそのまま保持できるため、エージェントが過去の判断理由まで遡って理解できるようになります。
| 比較項目 | 従来のベクトルRAG | 一般的なGraphRAG | BrainAPI(イベント中心グラフ) |
|---|---|---|---|
| 検索の仕組み | コサイン類似度(近似近傍探索) | エンティティ間リンク+コミュニティ要約 | イベントハブを経由するグラフ歩行(トラバーサル) |
| 時間・因果の把握 | 苦手(チャンク間の時系列が断絶) | 関係性に時間は保持しにくい | 得意(日時・場所・主客がイベントノードに直結) |
| 回答の根拠(透明性) | 類似度スコアのみ(中身の推論はブラックボックス) | 抽出されたエンティティ群 | 導出に使われたグラフパス(Triples)を完全提示 |
| 更新と履歴管理 | 古いベクトルの削除または再計算 | グラフノードの上書き・統合 | 追記専用(過去の変遷が100%残る) |
自動構築を支える「4体のエージェントスワーム」
知識グラフの最大のハードルは「グラフ構築とメンテナンスの手間」でした。手動でのオントロジー定義や関係性の記述は、現場のエンジニアにとって重すぎる負担です。BrainAPIはこの課題を、4つの役割に特化したAIエージェントのチームワーク(エージェントスワーム)によって自動化しています。
- Scout(スカウト): 文章全体を精読し、人物、ツール、イベント、数量などのあらゆるエンティティを漏れなく抽出します。
- Observations Agent(観察官): 既存の文脈や過去に知っている事実を踏まえながら、今回の文章に含まれる新しい事実メモを記述します。
- Architect(設計士): スカウトが抽出したエンティティをもとに、行動を中心としたイベントハブ関係(Actor → Event → Target)を組み立てます。
- Janitor(門番・整理係): 設計士の成果物を検証し、誤った関係性がないか、既存のグラフに同一のノードや重複した事実が存在しないかを厳しくチェックします。不備があれば設計士に差し戻して修正ループを回します。
このように、「抽出」「文脈整理」「構築」「厳密な検証」を分業させて相互レビューを行わせることで、ハルシネーションの混入を抑えた高品位なグラフを自動生成しています。
💡 あわせて読みたい
実務でどう使い倒すか?BrainAPIの4大実践活用シナリオ
活用シナリオ①:障害対応・インシデント履歴の「経緯と担当者」特定
システム開発やインフラ運用の現場において、最も価値を発揮するのが「インシデント対応メモや日報の構造化」です。過去の障害記録をBrainAPIに投入しておくと、「過去にデータベースのコネクション枯渇が起きた際、誰がどの設定ファイルを修正して解決したか?」といった質問に対し、当時の担当エンジニア、対象サーバ、実行コマンド、発生日時が結びついた正確な回答が返ってきます。
単なるドキュメント検索では「コネクション枯渇」という単語が含まれる数十件の記事がヒットしてしまい、どれが該当の解決策かわかりません。しかし、イベント中心グラフであれば「障害発生イベント」と「対応完了イベント」が因果関係で直結しているため、無駄な調査時間を劇的に削減できます。
活用シナリオ②:MCP連携による「長期記憶を持つ自律型AIエージェント」
BrainAPIは標準で MCP(Model Context Protocol)サーバー を内蔵しています。これにより、Claude Desktopや各種AIコーディングツール、自作の自律エージェントの外部メモリとして即座に接続可能です。
通常、LLMとのセッションが切れると過去のやり取りや設計方針は忘却されてしまいます。しかし、エージェントにBrainAPIのMCPツールを持たせることで、「前回のミーティングで決定したAPI命名規則」や「特定のモジュールを実装した背景」をエージェント自身が必要に応じてクエリし、過去のコンテキストを引き継ぎながら作業を継続できるようになります。
活用シナリオ③:顧客の声・商談メモからの潜在ニーズ分析とレコメンド
BrainAPIには、ノード同士の関係性や類似兄弟要素をスコアリングする /retrieve/entity/synergies や /retrieve/recommend といった専用エンドポイントが用意されています。
たとえば、営業の商談ログやサポートへの問い合わせチケットを蓄積しておくと、「プロダクトAの解約を検討したユーザー群は、その直前にどんな要望イベントを発行していたか?」といった行動パスに基づいたレコメンデーションや原因分析が可能です。一般的な協調フィルタリングのように単純なクリックの共起関係を見るのではなく、「実際の業務イベントの流れ」に基づいた高度な意思決定支援が実現します。
活用シナリオ④:回答根拠の100%監査・コンプライアンス対応
医療、金融、法務などのミッションクリティカルな分野では、「AIが回答を導き出した根拠を人間が検証できるか」が最大の導入障壁となります。
BrainAPIの /retrieve/context は、生成された回答文だけでなく、その回答を組み立てるために辿ったグラフのトリプル一覧(Triples)を返却します。「どのドキュメントの、どのノードとどのエッジを通ってその結論に至ったのか」が完全に可視化されるため、監査ログとしての信頼性が極めて高く、ハルシネーションによるリスクを最小限に抑えられます。
ローカル導入と実装コード — 最速セットアップから呼び出しまで
TUIによるワンコマンド立ち上げ
BrainAPIは、専用のCLIツール(TUI)を使うことで、DockerコンテナやローカルPython環境を迷わずセットアップできます。Node.js環境があれば、以下のコマンドですぐに初期化ウィザードを実行できます。
# TUIツールのインストールと初期化
npm install -g brainapi-tui
brainapi init

# バックエンド・API・MCPサーバー・Webコンソールの一括起動
brainapi start
起動が完了すると、http://localhost:8000/console で美しいWebコンソール画面が立ち上がります。セットアップ時に発行されたトークン(BRAINPAT_TOKEN)でログインすれば、現在蓄積されている知識グラフの視覚的ネットワークや、エンティティの結びつきをブラウザ上で直感的に確認できます。
Python SDKによるデータ投入とコンテキスト取得
公式のPython SDK(lumen_brain)またはシンプルなREST APIを用いることで、自社のアプリケーションに数行で組み込めます。以下は、新しい出来事を知識グラフへインジェストし、自然言語でコンテキストと根拠パスを取得する最小のコード例です。
from lumen_brain import BrainAPI

# クライアントの初期化
client = BrainAPI(api_key="your-pat-token", base_url="http://localhost:8000")

# 1. 出来事(非構造化テキスト)の投入
client.ingest.text(
    "2026年9月15日、田中エンジニアが決済基盤マイクロサービスのRedisキャッシュ障害を復旧させた。"
)

# 2. 複合的な条件でコンテキストを問い合わせ
result = client.retrieveContext("先週の決済基盤で発生した障害の担当者と対応内容は?")

# 回答テキストの表示
print("【回答】:", result.text_context)

# 導出根拠となった知識グラフのパス(トリプル一覧)
print("【推論パス】:", result.triples)
Claude DesktopへのMCP接続設定
BrainAPIが提供するMCPサーバー(デフォルトポート 8001)をClaude Desktopに登録するには、設定ファイル(claude_desktop_config.json)に以下の記述を追加するだけです。
{
  "mcpServers": {
    "brainapi-local": {
      "command": "npx",
      "args": ["-y", "@pyroprompts/mcp-stdio-to-streamable-http-adapter"],
      "env": {
        "URI": "http://localhost:8001/mcp",
        "MCP_NAME": "brainapi-local",
        "BEARER_TOKEN": "your-pat-token"
      }
    }
  }
}
これで、Claude Desktopで会話しながら「このログをBrainAPIに記憶しておいて」「前回の障害対応の記録を調べて」と指示できるようになります。
導入時の落とし穴とアンチパターン(向かない用途)
非常に魅力的なBrainAPIですが、何でも解決できる銀の弾丸ではありません。現場で導入を検討する際は、以下のトレードオフを意識しておく必要があります。
- インジェスト時のLLMコストと時間: 1つのテキストを処理するたびにエージェントスワームが複数回のLLM呼び出しを行うため、通常のベクトル埋め込み作成(Embedding APIを1回呼ぶだけ)に比べてAPI利用料と処理時間がかかります。大量バッチ投入時は
lightweightパイプラインモードを活用するなどの工夫が必要です。 - 固定スキーマ・数値集計には不向き: 「売上上位10社を合計する」「在庫数を更新する」といった用途には、従来のRDB(PostgreSQLなど)を使った単一SQLの方が圧倒的に高速で正確です。BrainAPIはあくまで「非構造化テキストからの文脈・因果関係の抽出」に特化しています。
- ライセンス形態(BSL 1.1)への留意: BrainAPIは非商用利用や開発検証環境では無償で利用できますが、本番サービスとして自社クラウド等に組み込んで提供する商用利用には商用ライセンスが必要です(※2030年8月にApache 2.0へ自動移行する条項付き)。
よくある質問(FAQ)
Q1: 既存のベクトルデータベースはすべて置き換わるのでしょうか?
A: 置き換わるのではなく、相互補完する関係です。BrainAPIの内部でも、高速な初期絞り込みのためにPostgreSQLのpgvectorやMilvusなどのベクトル検索エンジンが併用されています。「大まかな意味の近さで候補を絞り込むベクトル検索」と、「絞り込んだ候補同士の正確な関係や時間軸を確定させる知識グラフ」のハイブリッド構成こそが、最も精度の高いアーキテクチャとなります。
Q2: 日本語の文書でもエンティティや関係性を正しく抽出できますか?
A: はい、高い精度で抽出可能です。BrainAPIのエージェントスワームは内部でOpenAIやAnthropic、DeepSeekなどの高機能なLLMを呼び出しているため、日本語特有の文脈や助詞のニュアンスも理解してグラフ化します。また、プラグイン機能を使って抽出プロンプトを日本語のドメイン用語に合わせてカスタマイズすることも可能です。
Q3: 追記型(Append-only)とのことですが、個人情報などの削除はどう対応しますか?
A: 基本設計は過去の履歴を失わない追記型ですが、GDPRやプライバシー保護のための削除要求に対応するための管理用APIやノード特定機能が整備されています。コンソール画面またはREST APIから対象ノードを指定して論理削除・物理削除を行う運用が可能です。
まとめ
今回は、非構造化テキストからイベント中心の知識グラフを自動構築し、AIに根拠ある長期記憶を提供する「BrainAPI」の仕組みと実務活用術について解説しました。
- 類似度から関係性へ: ベクトル検索の「当て推量」を脱却し、誰が・いつ・何をしたかを歩けるグラフとして保持。
- エージェントスワームによる自動化: 4体の専門AIが分業して高品質なグラフを自律生成し、オントロジー作成の手間を解消。
- 実務での高い拡張性: MCPサーバーやREST API経由で、障害履歴検索から自律エージェントの長期記憶まで幅広く組み込み可能。
LLMを単なるチャットボットにとどめず、過去の文脈や組織のナレッジを正しく継承した「自律的な現場アシスタント」へ進化させたいエンジニアにとって、BrainAPIは非常に有力なアーキテクチャの選択肢になるはずです。まずは手元のメモや日報を投入して、生成されるグラフのつながりを体験してみてはいかがでしょうか。