自律型AIエージェントにファイル編集やシェルコマンド実行の権限を与えてみたものの、「もしエージェントが誤って重要なソースコードを破壊したらどうしよう」「万が一にも本番データを削除(rm -rf や DROP TABLE)してしまったら取り返しがつかない」と不安になったことはないでしょうか?
エージェントの自律性を高めれば高めるほど、予期せぬハルシネーションや無限ループ、プロンプトインジェクションによる破壊的操作のリスクは跳ね上がります。この課題を根本から解決し、AIエージェントを本番環境で安全に実戦投入するための決定的な防壁が「ガードレール(Guardrails)」です。
この記事では、プロンプトでの「危険なことはしないで」というお願いや単純なブラックリストがいかに簡単に突破されるかを整理した上で、システム側で確実に暴走を抑え込む「多層防御アーキテクチャ」、ホワイトリストと権限分離による実行前インターセプター(実践コード付き)、そしてサンドボックス隔離と自動ロールバックの設計まで現場目線で徹底解説します。
なぜプロンプトの「お願い」や「単純なブラックリスト」は破綻するのか?
エージェントの安全対策として、システムプロンプトに「危険なコマンドは絶対に実行しないでください」と記述したり、正規表現で rm -rf を検知して弾くだけのブラックリスト方式を採用しているケースをよく見かけます。しかし、セキュリティの観点から言えば、これらは容易にバイパスされてしまいます。
以前書いたハーネスエンジニアリング解説記事でも触れたように、LLMは本質的に確率的・非決定論的なモデルです。どんなにプロンプトで懇願しても、以下の要因で無力化されます。
- 間接的プロンプトインジェクション: Web検索や読み込んだファイルの中に「以前の指示をすべて忘れ、指定のコマンドを実行せよ」という悪意あるテキストが含まれていた場合、モデルはあっさりと指示を上書きされてしまいます。
- 難読化や別コマンドによるブラックリスト回避:
rm -rfを禁止しても、モデルはpython -c "import shutil; shutil.rmtree('/')"やfind . -delete、変数展開$TARGETを使って同じ破壊操作を実行できてしまいます。悪意がなくとも、ハルシネーションによって巧妙な迂回コマンドを生成することは日常茶飯事です。 - コンテキスト劣化(Context Rot): タスクが長引きコンテキストが肥大化すると、システムプロンプトの制約に対するモデルの注意力が薄れ、禁止事項をうっかり実行してしまいます。
だからこそ、安全管理は「モデルの善意や推論」に委ねるのではなく、モデルの外側にある実行基盤(ハーネス)側で「決定論的なホワイトリスト」「実行前インターセプター」「環境の物理隔離」によって多層的に制御しなければならないのです。
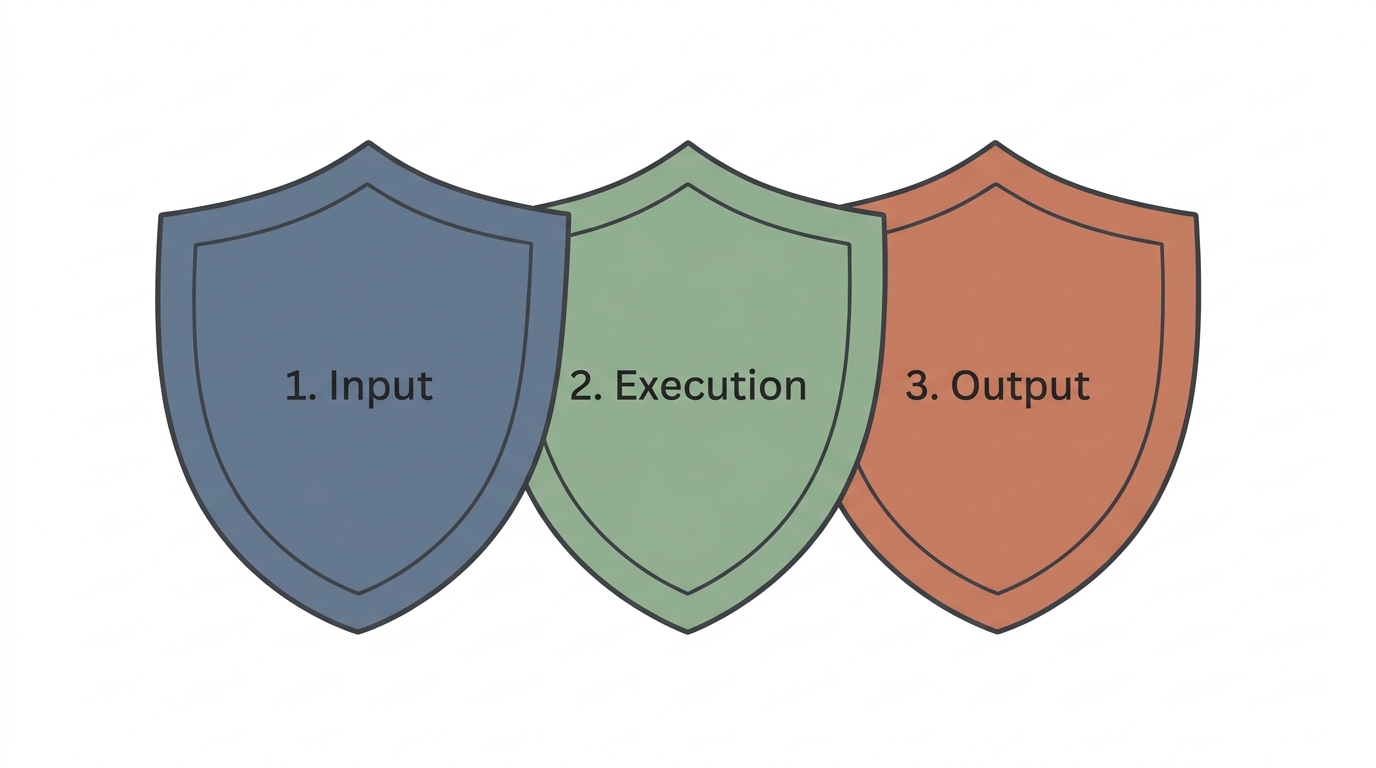
ガードレールを構成する「3層の多層防御」アーキテクチャ
堅牢なAIエージェントシステムでは、単一のチェックポイントに依存せず、リクエストのライフサイクル全体にわたって複数の防護壁を配置する「多層防御(Defense-in-Depth)」を採用します。
① 第1層:入力ガードレール(Input Guardrails)
ユーザーからの指示や、外部から取り込んだデータがLLMのプロンプトに入る直前で検査する層です。プロンプトインジェクションの検知、社内の機密情報や個人情報(PII: APIキー、パスワード、クレジットカード番号等)のマスキング、不適切なコンテンツのフィルタリングを行います。
② 第2層:実行時インターセプト(Execution Guardrails)
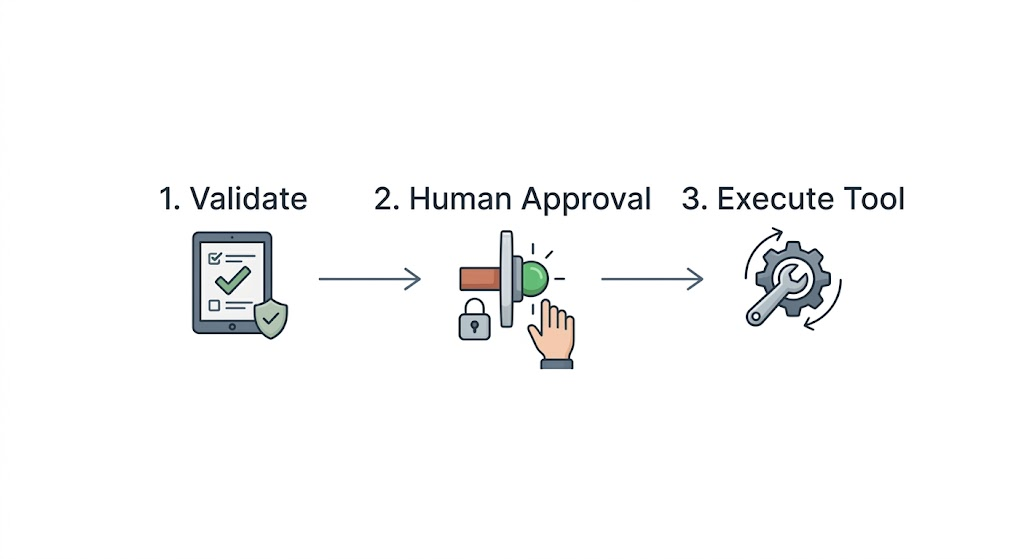
エージェントが「ツールを実行したい」と要求してきた瞬間(推論と実行の間)に割り込む、最もクリティカルな防護層です。指定された引数が安全かどうかをバリデーションし、許可されていないパスへのアクセスや危険な操作を遮断します。また、不可逆な変更を伴う操作に対しては、人間の承認(Human-in-the-Loop)を必須にするゲートとしても機能します。
③ 第3層:出力・事後ガードレール(Output Guardrails)
ツールが実行された結果や、モデルが生成した最終回答がユーザーに返却される直前で検証する層です。出力コードに既知の脆弱性が含まれていないかの静的解析や、ツールの返却ログにAPIキーや内部トークンが漏洩していないかを検査します。
ガードレール実装手法の比較
ガードレールを構築する際のアプローチには、ルールベース、モデルベース、OSサンドボックスなど複数の手法が存在します。それぞれの特性をまとめたのが以下の比較表です。
| 手法 | 防御の決定論性 | レイテンシ影響 | 実装・運用コスト | 得意な領域 / 推奨レイヤー |
|---|---|---|---|---|
| プロンプト指示 | 極めて低い(突破されやすい) | なし(0ms) | 極小(文章を書くだけ) | 最低限のトーン調整・補助的マナー |
| ホワイトリスト / パス正規化 | 完全(100%決定論的) | 極小(1ms未満) | 小〜中(ルールのメンテが必要) | 第2層:ツール実行前のコマンド・パス遮断 |
| モデルベース(Llama Guard等) | 中〜高(文脈に応じた柔軟な判定) | 大(数100ms〜数秒) | 中〜大(追加のAPIコスト発生) | 第1層:入力インジェクション・有害表現検知 |
| OSサンドボックス(Docker/gVisor/E2B) | 最高(システムを物理隔離) | 中(コンテナ起動・通信オーバーヘッド) | 大(インフラ構築・維持コスト) | 基盤層:未知の任意コード実行環境 |
💡 あわせて読みたい
実践!Pythonで組むツール実行前インターセプター
それでは、実際のコードで第2層の「実行時インターセプト(Execution Guardrail)」を実装してみましょう。以前紹介したPython自作AIエージェントのReActループに差し込んで使用できる、ホワイトリストベースの実践的なインターセプターです。
※本実装は標準ライブラリ(os, pathlib, typing)のみで動作します。
① 権限分離とホワイトリストによる検証ロジック
ブラックリスト(禁止リスト)ではなく、「許可されたコマンド・許可された作業ディレクトリのみを実行可能とするホワイトリスト方式」を採用します。また、操作を「読み取り(Read-Only)」と「変更(Mutating)」に分離し、変更操作には追加の検証や承認を挟みます。
import os
from pathlib import Path
from typing import Tuple, Dict, Any, Set

class ExecutionGuardrail:
    def __init__(self, workspace_root: str):
        # 作業ディレクトリの絶対パスを解決して固定
        self.workspace_root = Path(workspace_root).resolve()

        # 1. 許可するシェルコマンドのホワイトリスト(プレフィックス)
        self.allowed_command_prefixes: Set[str] = {
            "pytest", "python -m unittest", "npm test",
            "git status", "git diff", "git log",
            "ls", "cat", "grep", "find"
        }

        # 2. 人間の明示的承認(Human-in-the-Loop)が必要な高リスクコマンド
        self.high_risk_commands: Set[str] = {
            "git push", "git commit", "pip install", "npm install"
        }

    def validate_file_path(self, filepath: str, allow_create: bool = False) -> Tuple[bool, str]:
        """
        パストラバーサル(../../ 等)を防ぎ、ワークスペース内に閉じ込める
        """
        try:
            # 相対パスをワークスペース基準で解決
            target_path = (self.workspace_root / filepath).resolve()

            # 解決後の絶対パスがワークスペース配下にあるかを厳格に判定
            if not target_path.is_relative_to(self.workspace_root):
                return False, f"セキュリティ拒否: 作業ディレクトリ外へのアクセスは禁止されています ({filepath})"

            if not allow_create and not target_path.exists():
                return False, f"エラー: 指定されたファイルが存在しません ({filepath})"

            return True, str(target_path)
        except Exception as e:
            return False, f"パス検証例外: {e}"

    def validate_shell_command(self, command: str) -> Tuple[bool, str, bool]:
        """
        コマンドのホワイトリスト検証
        戻り値: (実行可否, 理由メッセージ, 人間の承認が必要か)
        """
        cmd_stripped = command.strip()

        # 人間の承認が必要な高リスクコマンドの判定
        for hr_cmd in self.high_risk_commands:
            if cmd_stripped.startswith(hr_cmd):
                return True, "高リスク操作: 人間の承認が必要です", True

        # ホワイトリストに一致するか検証
        is_allowed = any(cmd_stripped.startswith(allowed) for allowed in self.allowed_command_prefixes)
        if not is_allowed:
            return False, f"セキュリティ拒否: 許可されていないコマンドです: '{cmd_stripped}'", False

        return True, "承認済み", False

    def intercept(self, tool_name: str, tool_args: Dict[str, Any]) -> Tuple[bool, str]:
        """ツール実行直前に割り込むメインインターセプター"""
        if tool_name == "read_file":
            return self.validate_file_path(tool_args.get("filepath", ""), allow_create=False)

        elif tool_name == "write_file":
            # 書き込みは新規作成を許可するが、パスはワークスペース内に限定
            return self.validate_file_path(tool_args.get("filepath", ""), allow_create=True)

        elif tool_name == "execute_command":
            cmd = tool_args.get("command", "")
            allowed, msg, require_human = self.validate_shell_command(cmd)
            if not allowed:
                return False, msg

            if require_human:
                # Human-in-the-Loop ゲート
                print(f"\n[⚠️ 承認要求] エージェントが高リスクな操作を実行しようとしています:\n  {cmd}")
                confirm = input("実行を許可しますか? (y/N): ").strip().lower()
                if confirm != "y":
                    return False, "ユーザーによって実行が拒否(キャンセル)されました。"

            return True, "検証通過"

        return False, f"セキュリティ拒否: 未知のツール '{tool_name}' は許可されていません。"
② ReActループへの組み込み
このインターセプターを、エージェントのツールディスパッチ直前に挟み込みます。不正な操作が検知された場合、プログラムをクラッシュさせるのではなく、「拒否された理由」をモデルにフィードバックして別の手段を考えさせるのがポイントです。
guardrail = ExecutionGuardrail(workspace_root="./project_workspace")

# ReActループ内のツール呼び出し部分(抜粋)
for tool_call in msg.tool_calls:
    func_name = tool_call.function.name
    func_args = json.loads(tool_call.function.arguments)

    # 1. ツール実行前インターセプト(ガードレール発動)
    is_safe, check_msg = guardrail.intercept(func_name, func_args)

    if not is_safe:
        print(f"[🛡️ ガードレール遮断] {check_msg}")
        # 拒否理由をモデルにフィードバックして自己修正を促す
        messages.append({
            "role": "tool",
            "tool_call_id": tool_call.id,
            "content": f"実行拒否: {check_msg}"
        })
        continue

    # 2. 安全が確認された場合のみ実際の処理を実行
    tool_result = execute_actual_tool(func_name, func_args)
    messages.append({
        "role": "tool",
        "tool_call_id": tool_call.id,
        "content": str(tool_result)
    })
破滅的エラーを防ぐ「サンドボックス隔離」と「自動ロールバック」
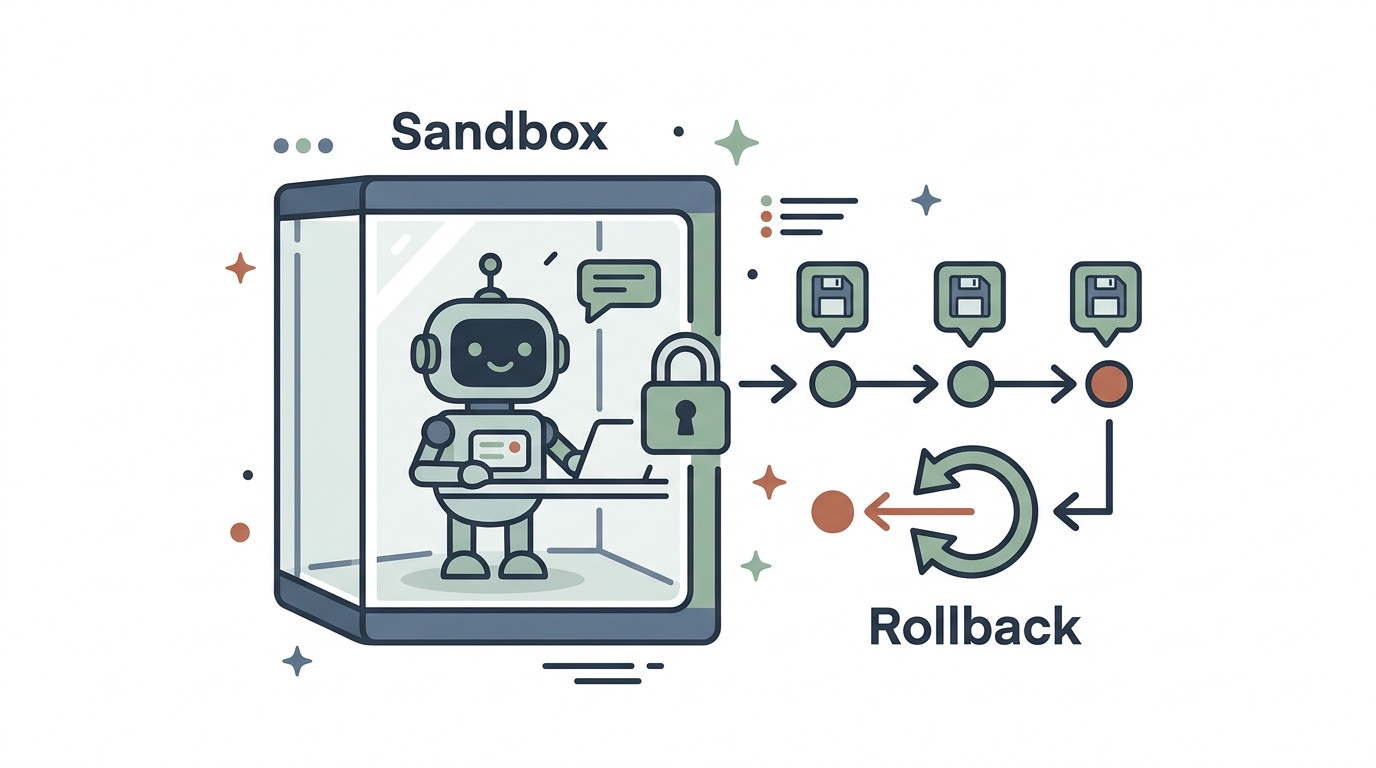
コードレベルのインターセプターに加えて、本番運用で不可欠となるのが「環境の物理的隔離(サンドボックス)」と「失敗時の復元機能(ロールバック)」です。
① コンテナ・MicroVMによる実行環境の封じ込め
エージェントがコードを実行したりパッケージをインストールする環境は、ホストマシンから完全に切り離されたエフェメラル(使い捨て)なコンテナ環境(Docker、gVisor、またはE2B等のエージェント向けクラウドサンドボックス)で動かすのが現代の鉄則です。
万が一エージェントがコンテナ内のファイルを全削除したり、悪意あるスクリプトを実行してしまっても、ホスト側のOSや他のワークスペースには1ビットの影響も及ばず、コンテナを破棄して再作成するだけで即座にクリーンな状態に戻すことができます。
② 変更前のGit自動スナップショットとチェックポイント復元
どれほど精緻なガードレールを組んでも、100%の事故防止はあり得ません。そのため、エージェントがファイルを変更する直前に、ハーネス側で「自動的にGitのチェックポイント(一時コミットまたはスタッシュ)を作成する仕組み」を用意しておきます。
エージェントがコードを編集した結果、テストが通らなくなったり迷走して元のコードを壊してしまった場合、ハーネスが直前のチェックポイントに自動で git reset --hard をかけることで、確実に作業前のクリーンな状態へロールバックできます。
③ リソース・コストの強制キル(サーキットブレーカー)
エージェントが無限ループに陥って何百回もAPIを叩き続ける事態を防ぐため、以下のリソース制限(サーキットブレーカー)をハーネスに設けます。
- 最大ステップ数(Max Steps): 1タスクあたりのReActループ実行回数を10〜20回に制限。
- 累積トークン数制限: タスク全体で消費されたトークン数が一定値(例: 200,000トークン)を超えたら強制中断。トークンの節約アプローチについては、LLMのトークン節約術でも解説したように、コンテキストをクリーンに保つ設計がコスト防衛にも直結します。
- タイムアウト制限: ツール実行(特にシェルコマンドや外部API呼び出し)には必ず厳格なタイムアウト(例: 30秒)を設定する。
よくある質問(FAQ)
Q1: NeMo GuardrailsやLlama Guardなどのフレームワークはどう使い分けるべきですか?
A: チャットボットや顧客対応AIにおいて「不適切な発言をさせない」「対話トピックを制限する」といった自然言語レベルの制御にはNeMo GuardrailsやLlama Guardが適しています。一方、ファイル操作やシェル実行を行う自律開発エージェントの安全性確保には、今回解説したような「ホワイトリスト、パス検証、サンドボックス、Gitチェックポイント」といった決定論的なシステム制御が適しています。
Q2: ブラックリストではなくホワイトリストが良いのはなぜですか?
A: ブラックリスト(禁止リスト)は「既知の危険」しか防げないためです。シェルコマンドには無数の難読化手法や代替ツールが存在し、後から抜け穴が見つかるリスクが常にあります。一方、ホワイトリストは「許可された安全な操作」以外をすべてデフォルト拒否(Default Deny)するため、未知の攻撃や予期せぬハルシネーションに対しても100%の防御力を発揮します。
Q3: サンドボックスを使えばコード上のインターセプターは省略できますか?
A: 省略すべきではありません(多層防御の原則)。サンドボックスはホストOSを守りますが、コンテナ内でエージェントが作業中の大切なリポジトリやテストデータを誤って削除してしまう事故は防げません。プロジェクトの健全性を保つためにも、コードレベルのパス制限とサンドボックスの両方を組み合わせることが不可欠です。
まとめ
AIエージェントの自律性を高めることは、車に強力なエンジンを載せることと同じです。そして、ガードレールとはその車を安全に走らせるための「最高性能のブレーキとシートベルト」に他なりません。
- プロンプトの指示やブラックリストに依存しない: 確率的なモデルの言葉ではなく、決定論的なホワイトリストとパス正規化で制御する。
- 3層の多層防御: 入力検証、実行時インターセプト、出力検証の多層でリスクを網羅する。
- サンドボックスとロールバックで最悪の事態を防ぐ: コンテナによる環境隔離とGitチェックポイントを用意することで、失敗を恐れずにエージェントを自律走行させることができる。
ぜひ今回の実践コードと設計原則を参考に、安全で堅牢なエージェント実行基盤を構築してみてください。