AIエージェントの開発を進める中で、「システムプロンプトの言い回しを少し調整したら、今まで成功していたタスクがなぜか失敗するようになった」「新しいツールを追加したけれど、全体として賢くなったのか劣化(リグレッション)したのか客観的に判断できない」と悩んだ経験はないでしょうか?
従来のWeb開発であれば、コードを変更した際に単体テスト(Unit Test)や結合テストを実行して品質を保証します。しかし、出力が確率的に揺らぐLLMエージェントにおいて、数回手動でプロンプトを試すだけの「感覚的な確認(Vibe Check)」で本番リリースするのはあまりに危険です。
そこで現代の自律エージェント開発において不可欠となっているのが、エージェントの性能・信頼性を自動かつ定量的に測定する「評価ハーネス(Evaluation Harness / Evals)」です。この記事では、ツール呼び出しアサーションからLLM-as-a-Judge、pytestによるCI自動テストの実装コードまで、現場で使える評価設計を徹底解説します。
なぜAIエージェントに「評価ハーネス」が必要なのか?
エージェントのプロンプトやコードを改善しようとするとき、開発者が最も頻繁に直面するのが「モグラ叩き(Whack-a-mole)」現象です。ある特定のプロンプトの不具合を直そうとして指示を追加すると、別の既存タスクで指示が衝突し、意図しない失敗が連鎖してしまいます。
以前書いたハーネスエンジニアリング解説記事でも触れたように、「モデルが天井を決め、ハーネスが床を決める」という原則において、その床(信頼性の最低水準)が保たれているかを検証する唯一の手段が評価ハーネスです。
- リグレッション(性能劣化)の即座な検知: ハーネス側のPythonコード修正やプロンプト更新を行った際、既存のタスク完遂率を落としていないかを自動で検知できます。
- モデル乗り換え・コスト最適化の検証: 高価なモデルから軽量モデル(例: GPT-4oからGPT-4o-mini、Claude SonnetからHaiku)へ切り替えた際、どの程度精度が維持できるかを数値(Pass@1率など)で客観比較できます。
- CI/CDへの統合による開発サイクルの加速: プルリクエストごとに自動テストを回すことで、チーム開発でも安心してエージェントの改善をマージできるようになります。
「手動で動かして動いたからOK」を卒業し、自動テストとして継続的にエージェントを評価する仕組みを構築することこそが、プロダクション品質への決定的な分水嶺となります。
評価ハーネスの「3層テストピラミッド」
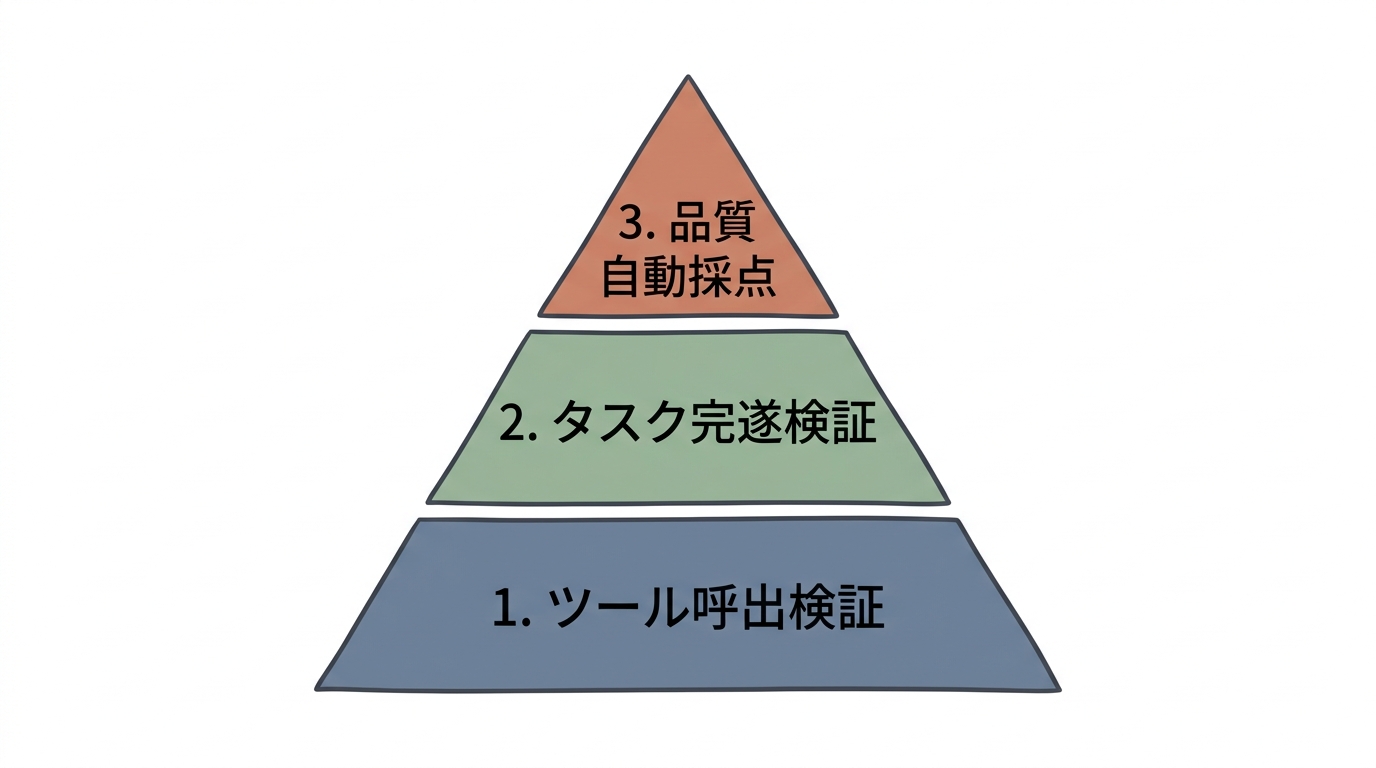
AIエージェントの評価は、通常のソフトウェアテストと同様に「実行コストが低く高速なテスト」から「実環境に近い総合的なテスト」へと段階的に構築するピラミッド構造が理想的です。
① 第1層:ツール呼出検証(Unit Eval)
最も基礎的かつ高速なテストです。「特定のユーザー入力に対して、モデルが期待通りのツールを正しい引数(JSONスキーマ)で呼び出したか」を検証します。実際の外部APIやシェルコマンドを実行せず、モデルの推論結果だけをアサーションするため、1テスト数秒以内・低コストで完了します。
② 第2層:タスク完遂・状態検証(Task Completion Eval)
エージェントをサンドボックス環境で実際に自律走行させ、タスク終了後に「期待通りの状態(State)になっているか」を決定論的にアサーションします。例えば「コードのバグを修正せよ」というタスクであれば、エージェント終了後に `pytest` やコンパイラを実行し、テストが全件パスしたかどうかで成否(Pass/Fail)を判定します。
③ 第3層:品質自動採点(LLM-as-a-Judge)
「要約のわかりやすさ」「レポートの論理性」「丁寧なトーン」など、従来のコードアサーションでは合否を判定できない主観的なアウトプットを、別の高性能LLM(ジャッジ役)を使って自動採点させる手法です。事前に明確な採点ルーブリック(評価基準)をプロンプトとして定義し、1〜5点のスコアや合格判定を出力させます。
エージェント評価手法の比較
それぞれの評価アプローチの特性と使い分けを整理したのが以下の比較表です。
| 評価レベル | 判定の決定論性 | 実行コスト / 速度 | 主な検証対象 | CI組み込み適性 |
|---|---|---|---|---|
| Unit Eval(ツール検証) | 高(スキーマ・引数一致) | 極めて低 / 超高速 | Tool Callingの正確性・不要呼び出しの有無 | 常時実行(PRごと) |
| Task Eval(状態検証) | 高(テスト通過・ファイル実在) | 中〜高 / 数十秒〜数分 | リファクタリング、バグ修正、データ加工の完遂 | 夜間実行 / 重要PR時 |
| LLM-as-a-Judge(品質採点) | 中(モデルの評価ゆらぎあり) | 中(追加のLLM呼出コスト) | 回答の自然さ、要件充足度、安全性 | リリース前検証 |
| 人手評価(Human Eval) | 最高(人間の真の満足度) | 極めて高 / 極めて遅い | UI/UXの快適さ、総合的な業務受入判定 | 定期レビュー(週次・月次) |
💡 あわせて読みたい
実践!pytestで書くAIエージェント自動テスト
それでは、以前実装したPython自作AIエージェントを対象に、実際に `pytest` で実行できる評価ハーネスのコードを構築してみましょう。
※本テストコードは pytest および openai>=1.0.0 を使用します。事前に pip install pytest "openai>=1.0.0" を実行してください。
① ツール呼出検証(Unit Eval)のテストコード
まずは「計算が必要なプロンプトに対して、確実に calculate ツールを呼んでいるか」を検証するテストです。
import json
import pytest
from openai import OpenAI

client = OpenAI()

# テスト対象のツール定義(抜粋)
TOOLS = [
    {
        "type": "function",
        "function": {
            "name": "calculate",
            "description": "数式を計算して結果を返します。",
            "parameters": {
                "type": "object",
                "properties": {
                    "expression": {"type": "string", "description": "数式"}
                },
                "required": ["expression"]
            }
        }
    }
]

def test_agent_tool_selection():
    """エージェントが適切なツールと引数を選択できるかを検証(Unit Eval)"""
    prompt = "1500円の商品に10%の消費税を加えた合計金額を計算してください。"

    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[
            {"role": "system", "content": "計算が必要な場合は必ず calculate ツールを使用してください。"},
            {"role": "user", "content": prompt}
        ],
        tools=TOOLS,
        tool_choice="auto",
        temperature=0.0  # 評価時は決定論性を高めるため temperature を 0 に設定
    )

    msg = response.choices[0].message

    # 1. ツール呼び出しが発生していることをアサーション
    assert msg.tool_calls is not None, "ツール呼び出しが発生しませんでした。"
    assert len(msg.tool_calls) == 1, "想定外の複数ツール呼び出しが発生しました。"

    tool_call = msg.tool_calls[0]
    # 2. 正しい関数名が選ばれているかを検証
    assert tool_call.function.name == "calculate", f"誤ったツールが選択されました: {tool_call.function.name}"

    # 3. 引数のスキーマと内容を検証
    args = json.loads(tool_call.function.arguments)
    assert "expression" in args, "必須引数 'expression' が欠落しています。"
    assert "1500" in args["expression"], "引数に元の金額が含まれていません。"
② タスク完遂と状態変化のテスト(Task Eval)
次に、エージェントにファイルを作成させ、期待通りのファイルと中身が生成されたかを検証する決定論的テストです。
import os
from your_agent_module import run_agent  # 以前自作したエージェント関数

def test_file_generation_task(tmp_path):
    """エージェントがファイル作成タスクを正しく完遂できるか検証(Task Eval)"""
    target_file = tmp_path / "summary.txt"
    task = f"'{target_file}' という名前のファイルを作成し、中に 'Hello Evals' と書き込んでください。"

    # エージェントを実行
    final_output = run_agent(task, max_steps=3)

    # 状態のアサーション(ファイルが物理的に生成され、内容が一致するか)
    assert os.path.exists(target_file), "指定されたファイルが生成されませんでした。"

    with open(target_file, "r", encoding="utf-8") as f:
        content = f.read()

    assert "Hello Evals" in content, f"ファイルの内容が一致しません: {content}"
③ LLM-as-a-Judgeによる品質評価ヘルパー
最後に、主観的なテキスト品質を上位モデルに評価させるヘルパー関数の例です。
def judge_with_llm(user_prompt: str, agent_answer: str, rubric: str) -> bool:
    """LLM-as-a-Judge による合否判定ヘルパー"""
    judge_prompt = f"""
あなたは公平な評価者です。以下の評価基準(ルーブリック)に基づいて、エージェントの回答を評価してください。

【ユーザーの要求】
{user_prompt}

【エージェントの回答】
{agent_answer}

【評価基準】
{rubric}

評価基準を完全に満たしている場合は 'PASS'、そうでない場合は 'FAIL' とだけ1行目に出力してください。
2行目にはその理由を簡潔に記述してください。
"""
    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[{"role": "user", "content": judge_prompt}],
        temperature=0.0
    )
    result_text = response.choices[0].message.content.strip()
    first_line = result_text.splitlines()[0].upper()
    return "PASS" in first_line
これらのテストを pytest tests/ で一括実行することで、プロンプトやコードを改修した直後に「既存機能が壊れていないか」をコマンド1発で確認できるようになります。
実務で陥りがちなEvalsの落とし穴とアンチパターン
評価ハーネスの導入において、多くのチームが直面する典型的な落とし穴を事前に把握しておきましょう。
アンチパターン1: テストケースへの「過学習(Overfitting to Evals)」
数個のテストケースを通すためだけに、システムプロンプトに「特定のキーワードが含まれていた場合はこうせよ」といった条件分岐を無数に書き足してしまうパターンです。テストスコアは上がりますが、未知のプロンプトに対する汎化性能が激しく劣化します。テストケースは最低でも数十件用意し、定期的に新しいバリエーションを追加することが不可欠です。
アンチパターン2: CIの実行時間とAPIコストの爆発
1つのPRごとに重厚なタスク完遂テスト(1実行で数分〜数千トークン消費)を何百件も回してしまうと、CIの完了まで数時間待ちになり、API利用料金も跳ね上がります。
実務では、「PRごとのCIでは軽量なUnit Eval(ツール引数検証)のみを高速実行し、重厚なTask Evalは夜間のバッチ実行(Nightly Evals)に回す」という階層化運用が極めて効果的です。
アンチパターン3: 評価基準が曖昧なLLM Judgeのゆらぎ
「この回答を1〜10点で採点してください」と指示すると、同じモデルでも実行ごとに7点になったり8点になったりしてスコアが安定しません。LLM-as-a-Judgeを導入する際は、「1〜10点の採点」ではなく、「満たすべき条件を箇条書きで定義し、すべて満たせばPASS、1つでも欠けていればFAIL」という二値判定(Binary Classification)に倒すことで、判定の再現性を劇的に高めることができます。
よくある質問(FAQ)
Q1: SWE-benchのような巨大な公開ベンチマークを自社で導入すべきですか?
A: 一般的なAIモデルの研究開発でなければ不要です。実務において重要なのは「自社のプロダクトや業務で頻出するタスクセット」を20〜30件集めたプライベートなテストスイート(In-house Evals)です。汎用スコアよりも、自社の実務タスクにおける完遂率の方がはるかに信頼できる指標となります。
Q2: プロンプト変更時に何件くらいのテストケースを用意すれば安心ですか?
A: 最初は小さく「過去に起きた代表的な失敗事例5〜10件」から始めるのがおすすめです。新しいバグが見つかるたびに、それを再現するテストケースをEvalsに追加していく(リグレッションテストの蓄積)ことで、チーム全体の資産として評価ハーネスが育っていきます。
Q3: LangSmithやPromptfooなどの専用評価ツールは使うべきですか?
A: チームでプロンプトのバージョン管理や評価結果のダッシュボード共有を行いたい場合は非常に有用です。一方で、まずは今回紹介したように `pytest` だけで最小限のテストを自作してみると、「評価ハーネスで何をアサーションすべきか」の本質が明確に理解できます。
まとめ
AIエージェントの開発を「当てずっぽうのプロンプト調整」から「再現性のある本格的なソフトウェア工学」へと昇華させる鍵が、評価ハーネス(Evals)です。
- Vibe Checkから定量評価へ: 感覚的な動作確認ではなく、Pass@1やタスク完遂率という数値で品質を可視化する。
- 3層のテストピラミッド: 高速なツール検証(Unit Eval)、実環境の状態検証(Task Eval)、主観品質のLLM-as-a-Judgeを適切に組み合わせる。
- CI自動テストでリグレッションを防ぐ: プロンプトやハーネスのコード改修を安全に進めるために、日々の開発サイクルにテストを組み込む。
ぜひ今回の `pytest` コードをベースに、まずは数件のテストケースから評価ハーネスを構築し、自信を持ってエージェントを本番運用できる体制を整えてみてください。