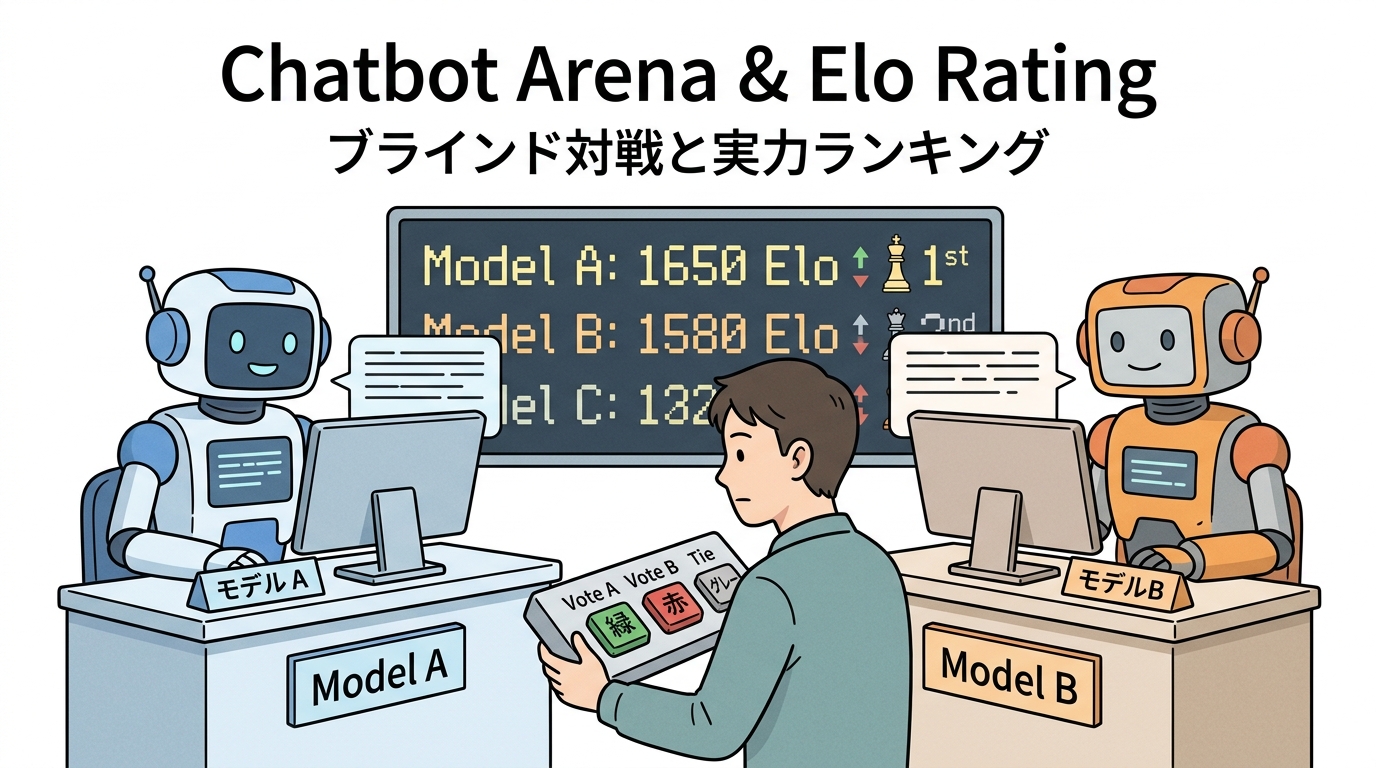
新しいLLM(大規模言語モデル)が登場したとき、開発者コミュニティやX(旧Twitter)で真っ先に「ついに〇〇がChatbot Arenaで1位に躍り出た!」「GPT-4o超えを達成!」と大騒ぎになるのを目にしたことはないでしょうか?「そもそもChatbot Arenaって何?」「なぜ他の学術ベンチマークより信頼されているの?」と疑問に感じたエンジニアの方も多いはずです。
前回の第6回:MT-BenchとLLM-as-a-Judgeでは、GPT-4を審査員にして対話品質を自動採点する仕組みを解説しました。連載第7回となる今回は、AI審査員ではなく「世界中の生身の人間ユーザーによる数十万件のブラインド対決」を集計し、チェス界の数学的アルゴリズムで強さを順位付けする世界最高峰のリーダーボード、LMSYS Chatbot ArenaとEloレーティングを徹底解剖します。親記事のLLM評価指標の完全総覧【全体俯瞰編】でも、人間主観評価の絶対的基準として位置づけた必読テーマです。
結論から言えば、「Chatbot Arenaは、モデル名を完全に隠したブラインドA/Bテストによってブランド先入観とベンチマーク汚染を完全に排除し、Eloレーティング(数学的実力差モデル)によって『人間にとって本当に使いやすく賢いモデル』を炙り出す最も信頼性の高いランキング」です。この記事では、ブラインド対戦の巧妙な設計から、中学生の数学でも直感的に理解できるEloレーティングの計算ステップまで、わかりやすく紐解いていきます!
Chatbot Arenaとは?「モデル名を隠す」ブラインド対戦の威力
ベンチマークハック(カンニング)を不可能にする唯一の仕組み
MMLUやGSM8kといった従来の学術ベンチマークには、近年ある深刻な問題が付きまとっていました。それが「データ汚染(Data Contamination)」と「ベンチマークハック」です。
テスト問題が事前にインターネット上で公開されているため、モデルの事前学習データに問題と解答が紛れ込んでしまい、「テストの解き方を覚えたのではなく、単に過去問を丸暗記して高得点を出しているだけではないか?」という疑念を払拭できなかったのです。
この不正や過学習の壁を完璧に打ち破ったのが、UCバークレー校などの研究者コミュニティLMSYSが立ち上げたChatbot Arenaでした。世界中の一般ユーザーが、プロンプトのテストベンチとして自由にWebサイト上で対話を行い、そのリアルタイムな対決ログをもとにランキングを更新しています。
先入観をゼロにする「3ステップのブラインド評価」
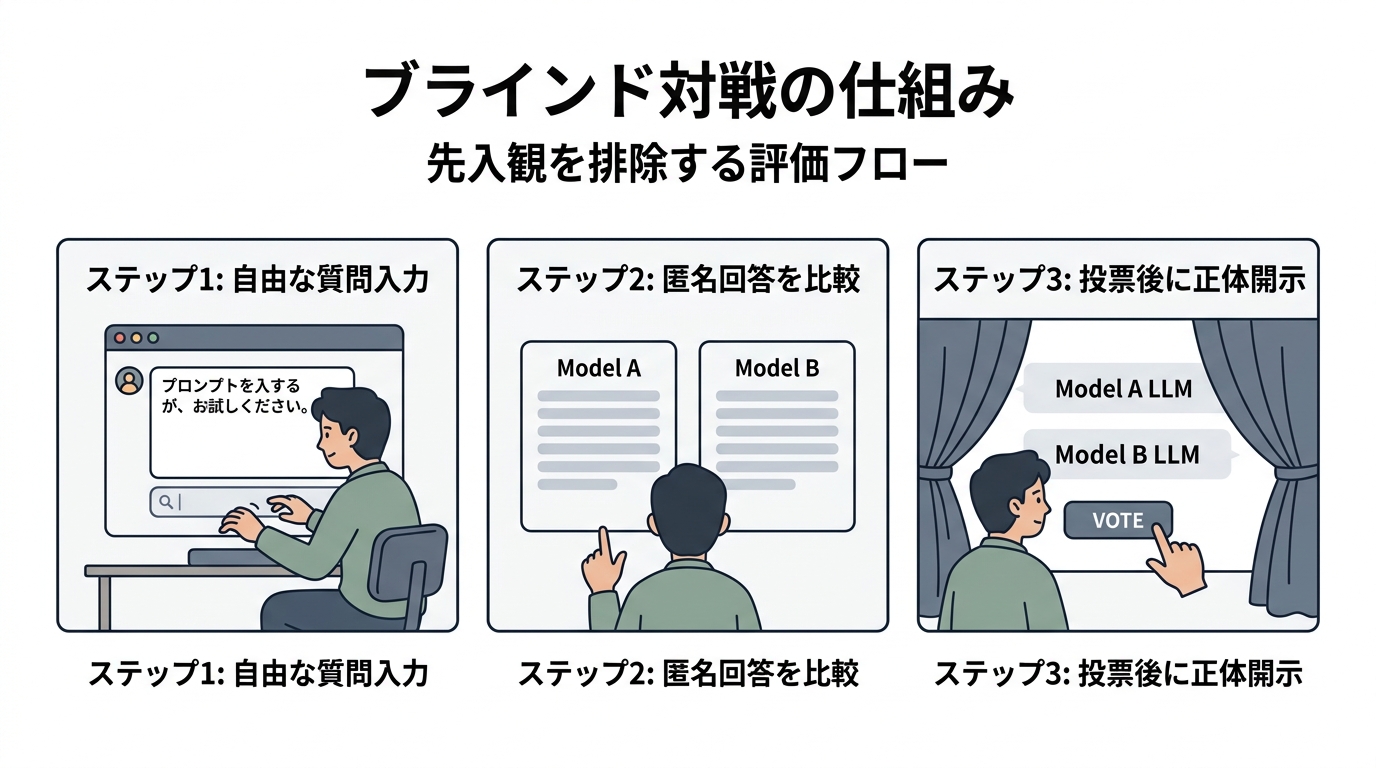
Chatbot Arenaの対戦プロセスは、心理学や医学の治験で使われる「二重盲検法」の思想を取り入れた、極めて厳密なブラインドテストになっています。
- ステップ1(自由な質問入力): ユーザーは対戦画面の入力フォームに、任意のプロンプトを自由に入力します(難解なPythonコードのデバッグ、創作小説の執筆、人生相談、哲学的な問いなど、ジャンルは一切自由)。
- ステップ2(覆面モデルによる同時回答): システムが裏側でランダムに選んだ2つのモデル(「Model A」と「Model B」とだけ表示)が、同時に回答を出力します。この時点では、どちらがGPT-4oなのか、Claude 3.5 Sonnetなのか、オープンソースモデルなのかは一切分かりません。
- ステップ3(投票後に初めて正体開示): ユーザーが「Model Aが良い」「Model Bが良い」「引き分け」「両方とも酷い」のいずれかの投票ボタンを押したその瞬間、初めてカーテンが開き、両者の正体(モデル名)が開示されます。
「OpenAIの製品だから賢いに違いない」「オープンソースだから少し劣るはず」といった人間のブランドバイアスや先入観が100%排除されるため、純粋な回答の品質だけで勝敗が決まります。
【数学の核心】Elo(イロ)レーティングの計算方法をシミュレーション
チェス界で磨かれた「実力差を数値化する」数学アルゴリズム
集まった膨大な対戦結果から、各モデルの実力をどのように1つの数値(レーティング)に集約しているのでしょうか?ここで採用されているのが、物理学者アーパード・エロ(Arpad Elo)氏が考案したEloレーティングシステムです。
チェスや将棋、オンラインゲームのランクマッチで広く使われているこの仕組みの最大の特徴は、「対戦相手の強さに応じて、勝敗時のスコア増減幅が自動的に調整される」点にあります。
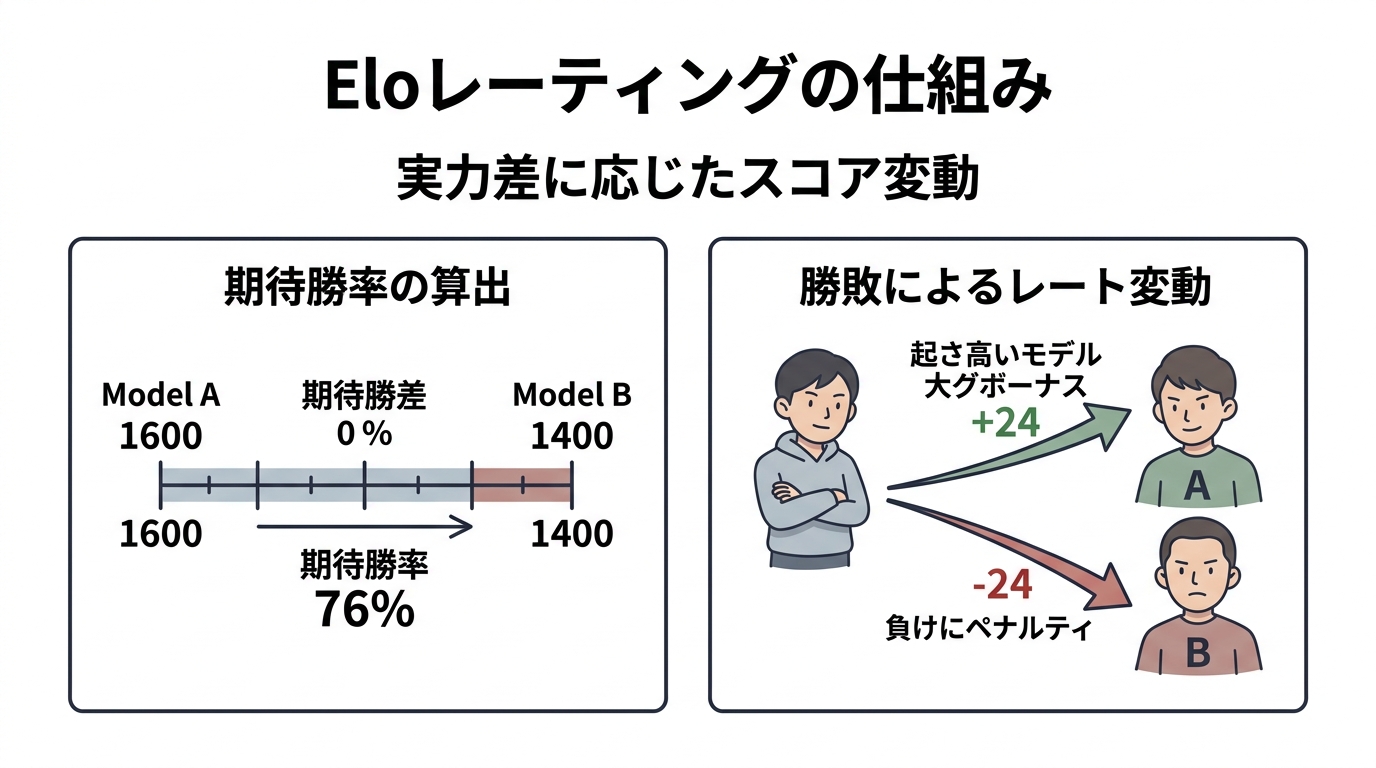
ステップ1:事前の「期待勝率」を計算する
Eloシステムでは、試合を行う前に両者の現在のレーティング差から「確率的にどちらが勝つ可能性が高いか(期待勝率)」を計算します。モデルA(レート RA)とモデルB(レート RB)の対戦において、モデルAが勝利する期待勝率 EA は以下のロジックで求められます。
【期待勝率の計算式】
EA = 1 / (1 + 10(RB – RA) / 400)
※400という定数は、チェス界の標準的なスケーリング係数です。「レート差が400ある場合、上位側の期待勝率が約91%になる」ように調整されています。
具体例で計算してみましょう。王者モデルA(レート1600)と、新興モデルB(レート1400)が対戦するとします。レート差は 200 です。
- 指数部分: (1400 – 1600) / 400 = -200 / 400 = -0.5
- 10-0.5 ≒ 0.3162
- モデルAの期待勝率 EA = 1 / (1 + 0.3162) ≒ 0.760(76.0%)
- モデルBの期待勝率 EB = 1 – 0.760 = 0.240(24.0%)
試合前の確率計算では、格上のモデルAが約76%の確率で勝つと予測されました。
ステップ2:実際の試合結果をもとにレートを更新する
試合が終了した後、実際の勝敗結果(S)と事前の期待勝率(E)の「ズレ」をもとに、新しいレーティング(R’)を計算します。更新式は非常にシンプルです。
【レート更新式】
R’A = RA + K × (SA – EA)
※Kは更新の重み(Kファクター。通常K=32などが用いられます)。SAは実際の試合結果(勝利: 1.0、引き分け: 0.5、敗北: 0.0)。
ここで、2つのシナリオを比較してみると、Eloレーティングの美しさがよく分かります。
| シナリオ | モデルA(格上: 1600)の変動 | モデルB(格下: 1400)の変動 |
|---|---|---|
| ① 順当にモデルAが勝利 |
+32 × (1.0 – 0.76) = +7.68 新レート: 1607.7 |
+32 × (0.0 – 0.24) = -7.68 新レート: 1392.3 |
| ② 格下のモデルBが勝利(大番狂わせ!) |
+32 × (0.0 – 0.76) = -24.32! 新レート: 1575.7 |
+32 × (1.0 – 0.24) = +24.32! 新レート: 1424.3 |
いかがでしょうか。格上が勝っても「勝って当然」なのでわずか+7.7ポイントしか増えませんが、格下が格上を倒すジャイアントキリングを起こすと、一気に+24.3ポイントものボーナスを獲得できます。この自己調整ロジックが何十万回も繰り返されることで、全モデルのレーティングが完璧な実力値へと収束していくのです。
💡 あわせて読みたい
大規模ログを処理する「Bradley-Terryモデル」と最尤推定(MLE)
なお、実際のChatbot Arenaの集計では、時系列に沿って1試合ずつ更新する逐次Elo方式だけでなく、統計モデルであるBradley-Terryモデルと最尤推定(Maximum Likelihood Estimation:MLE)を用いて、過去の全対戦ログから大域的な最適レーティングを一括算出しています。
さらに、ブートストラップ法(リサンプリング)によって「95%信頼区間」を算出しているため、「モデルAとモデルBの差が統計的に有意な差なのか、それとも誤差の範囲内なのか」を厳密に判定できる学術的な堅牢性を備えています。
実務でどう見る?エンジニア目線でのChatbot Arena活用法
「体感の賢さ」と最も一致するリーダーボード
実務でLLMの選定を行うエンジニアにとって、Chatbot Arenaの総合ランキングは「最もユーザー満足度と相関する頼れる指標」です。
MMLUやMATHのスコアがどんなに高くても、Chatbot Arenaで下位に沈んでいるモデルは、実際のユーザーから「回答がぶっきらぼう」「日本語の言い回しが不自然」「質問の意図を汲んでくれない」と低評価を受けている証拠です。エンドユーザー向けチャットボットや接客AIのモデル選定では、学術テストよりもまずArenaスコアの上位モデルを優先して候補に挙げるのが定石です。
実務で注意すべき「Arenaの3つの落とし穴」
ただし、盲信は禁物です。エンジニアとしてArenaランキングを見る際は、以下の3つの特性を頭に入れておく必要があります。
- 1. スタイルバイアス(長文・美文優遇): 人間ユーザーも審査員AIと同様に、文字数が多く箇条書きで丁寧に装飾された回答に好意的な票を入れやすい傾向があります。簡潔さを求める業務では別個の検証が必要です。
- 2. カテゴリ別リーダーボードの確認: 総合ランキングだけでなく、画面上部のタブから「Coding(プログラミング)」「Hard Prompts(難問)」「Japanese(日本語)」などのサブカテゴリで絞り込んで順位を確認することが極めて重要です。
- 3. 速度とコストは考慮されていない: Arenaのレーティングは「回答の質」のみを反映しており、レイテンシ(生成速度)やAPI利用料は一切加味されていません。運用設計では第13回で解説する「スループット・コスト指標」との総合判断が不可欠です。
まとめ
今回は、LLMの主観評価における世界最強の指標「Chatbot Arena」と「Eloレーティング」の数学的仕組みを解説しました。要点を振り返ってみましょう。
- Chatbot Arena: モデル名を完全に隠したブラインドA/Bテストにより、ブランドの先入観や過去問暗記(汚染)を排除した最も信頼できるリーダーボード。
- Eloレーティング: レート差に基づく「期待勝率」を計算し、波乱の結果(ジャイアントキリング)には大きなスコア変動を与えることで、真の実力値へ自動収束するアルゴリズム。
- 学術的堅牢性: Bradley-Terryモデルと最尤推定(MLE)を用い、何十万もの対戦ログから統計的信頼区間(95% CI)を算出している。
- 実務での付き合い方: ユーザー体験(UX)に直結するモデル選定の最有力候補として参照しつつ、日本語・コーディングなどのカテゴリ別ランキングやコストと合わせて総合判断する。
人間の主観によるガチンコ対決をマスターしたところで、次回は対話の「ルール厳守力」を機械的に白黒判定する「第8回:IFEval入門!文字数制限やJSON出力を自動検証する指示追従ベンチマーク」に進みます!こちらもぜひ楽しみにしていてくださいね。
参考リンク・公式ドキュメント
- 📊 LMSYS Chatbot Arena 公式リーダーボード(対戦プラットフォーム)
- 📄 Zheng et al. (2023) — Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (原著論文)
- 📄 Chiang et al. (2024) — Chatbot Arena: An Open Platform for Evaluating LLMs by Human Preference
- 🌐 LMSYS / FastChat 公式GitHub
- 📰 片田舎釣り好きエンジニアの研究室 — LLMの評価指標・ベンチマーク完全総覧【全体俯瞰編】