最新のLLM(大規模言語モデル)の発表論文や性能比較表を見ていると、「MMLUやGSM8kでは90%以上のハイスコアが並んでいるのに、GPQAの欄だけスコアが50%〜60%台に激減している…」といった光景を目にしたことはないでしょうか?「そもそもGPQAって何の略?」「BBHとはどういうテストなの?」と疑問に感じたエンジニアの方も多いはずです。
前回の第4回:GSM8kとMATHで測る思考力では、小学生レベルの文章題から数学オリンピック難問まで、段階的な推論力を測る数学ベンチマークを解説しました。連載第5回となる今回は、最先端フロンティアモデルの「真の知能限界」を浮き彫りにする最高峰ベンチマーク、GPQA(Google-Proof Q&A)とBBH(BIG-bench Hard)を徹底解説します。親記事のLLM評価指標の完全総覧【全体俯瞰編】でも、知能テストの極限指標として位置づけた必読テーマです。
結論から言えば、「GPQAは一般人がGoogle検索を駆使して30分調べても解けない博士(PhD)レベルの極限テストであり、BBHは初期LLMが手も足も出なかった複合アルゴリズム思考テスト」です。一般的な知識ベンチマークが軒並み飽和(満点近く)した現在、OpenAI o1やClaude 3.5 Sonnet、Gemini 1.5 Proなどの最新モデルが競い合う主戦場がここにあります。今回はその過酷な出題設計と実務での見方を紐解いていきましょう!
GPQAとは?「Google検索で30分調べても解けない」博士レベルの極限問答
専門分野のPhD取得者が設計した448問の難関テスト
GPQA(A Graduate-Level Google-Proof Q&A Benchmark)は、2023年にニューヨーク大学(NYU)の研究チームらによって開発された、生物学・物理学・化学の専門知識と高度な多段階推論を問うベンチマークです。
出題数は厳選された448問(高品質なメインセットであるGPQA Diamondは198問)。問題のすべてが各分野の博士課程学生やPhD(博士号)保持者によって作成・検証されています。
なぜ「Google-Proof(検索耐性)」と呼ばれるのか?
GPQAの最大の特徴は、その名の通り「Google検索耐性(Google-Proof)」を徹底的に担保している点にあります。
通常の知識問題であれば、問題文に含まれる特徴的なキーワードを検索窓に入力すれば、Wikipediaや学術論文のアブストラクトから答えが見つかりますよね。しかしGPQAでは、単に検索しただけでは絶対にヒットしないように問題が設計されています。
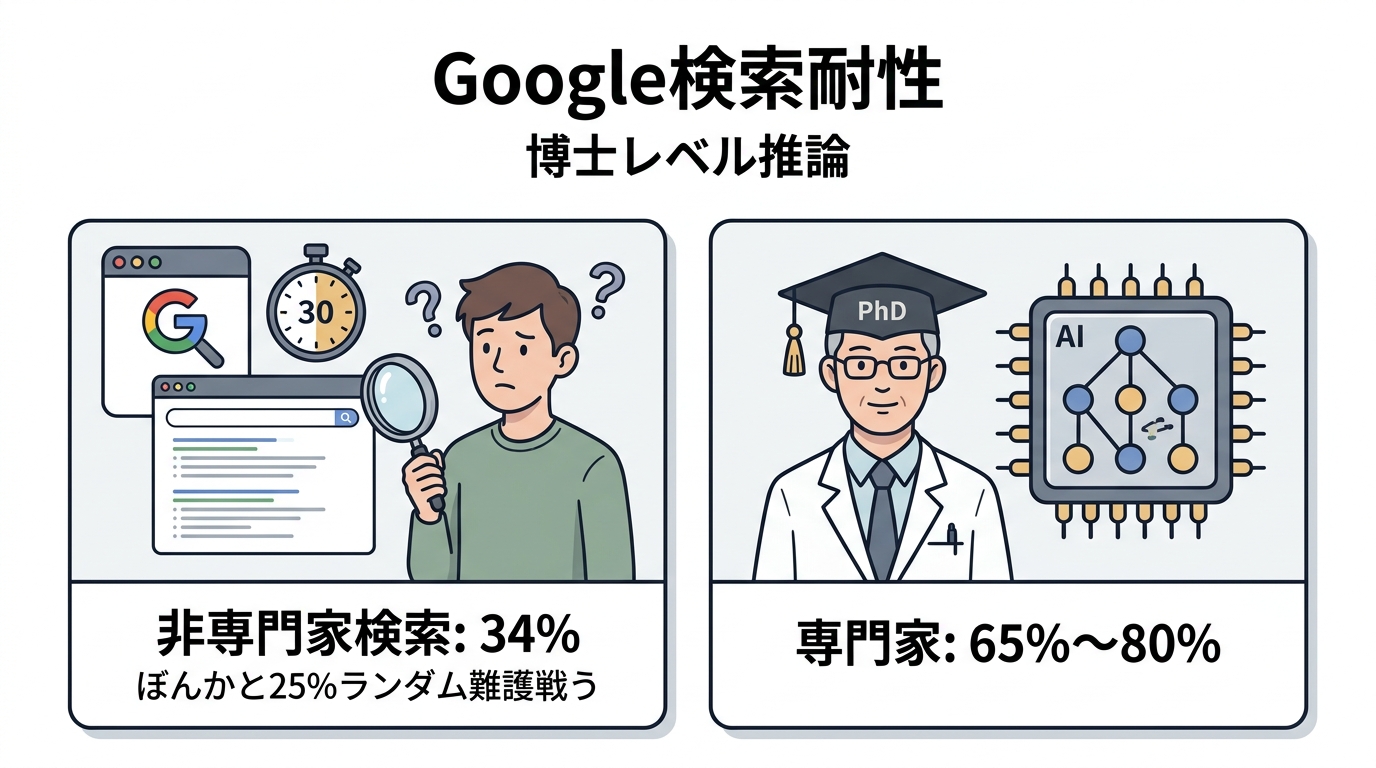
研究チームによる実証実験では、非専門家(専門分野外の人)にGoogle検索を30分間自由に使い放題で解かせても、正解率はわずか34%程度にとどまりました。4択問題であるため、何も考えずに当てずっぽうで選んだ場合の期待値(25%)と大差ない数字です。
一方で、その分野の専門家(専門領域のPhD保持者)がじっくり解いた場合は約65%〜80%の正解率を出します。つまり、「小手先のWeb検索や暗記知識ではなく、基礎原理を深く理解した上での複合的な論理展開」ができなければ絶対に解けないテストなのです。
【出題シミュレーション】GPQAの出題イメージ
単なる知識ではなく「多段の思考トラップ」を仕掛けた問題構成
GPQAでどのような推論が求められるのか、生化学・薬理学分野を模した出題イメージを見てみましょう(実際の出題意図をわかりやすく噛み砕いた例です)。
【GPQAの出題イメージ例(生化学・酵素反応)】
問: ある新規キナーゼ酵素Kに対する競合阻害剤X(阻害定数 Ki = 2.0 nM)が存在する。酵素Kの活性中心近傍のアミノ酸残基Tyr124をPheに変異させた変異体K_mutを作成したところ、基質ATPに対する見かけのKm値は野生型の3倍に増加したが、阻害剤Xに対する親和性は野生型の10分の1に低下した。基質ATP濃度が野生型Kmの2倍、阻害剤X濃度が10 nMの条件下において、変異体K_mutの反応速度は野生型酵素の反応速度と比較してどのように変化するか?
- (A) 約0.45倍に低下する
- (B) 約1.32倍に増加する
- (C) 約2.15倍に増加する
- (D) ほぼ同一(変化率5%未満)
この問題を解くためには、以下のような複数の専門的思考ステップを完璧に連鎖させる必要があります。
- 変異によるパラメータ変動の整理: Km_mut = 3 × Km_wt、Ki_mut = 10 × Ki_wt(Ki = 20 nM)を正しく立式する。
- ミカエリス・メンテン式の展開: 競合阻害存在下での反応速度式
v = Vmax × [S] / ([S] + Km × (1 + [I]/Ki))に野生型と変異体の各パラメータをそれぞれ代入する。 - 相対比率の計算: 野生型の阻害比率と変異体の阻害比率の差を計算し、Vmaxが不変である前提のもとで最終的な速度比
v_mut / v_wtを導出する。
検索エンジンで「キナーゼ Tyr124Phe」と調べても、この架空の実験条件の計算結果はどこにも転がっていません。公式をただ暗記しているだけでも駄目で、途中で符号や比率を1箇所でも取り違えれば、見事に用意された誤答選択肢(ディストラクター)に引っかかるよう巧妙にトラップが張られています。
BBH(BIG-bench Hard)とは?言語モデルが沈黙した23の難関タスク
巨大ベンチマーク「BIG-bench」から抽出された精鋭問題
GPQAが「専門分野の最高峰」であるのに対し、論理推論・アルゴリズム思考の限界を測定するのがBBH(BIG-bench Hard)です。
Googleをはじめとする440以上の研究機関が参加した超巨大プロジェクト「BIG-bench(Beyond the Imitation Game Benchmark)」には、200種類以上の多様なタスクが含まれていました。しかし、2022年時点の最先端モデル(PaLM 540Bなど)であっても、人間の平均スコアを大きく下回る苦手分野が数多く存在したのです。
そこで研究チーム(Suzgun et al., 2022)は、当時のLLMが全く歯が立たなかった(正解率が低く人間の平均を下回った)特に難関な23種類のタスクを厳選し、「BIG-bench Hard(BBH)」としてパッケージ化しました。
BBHを構成する23タスクの代表例
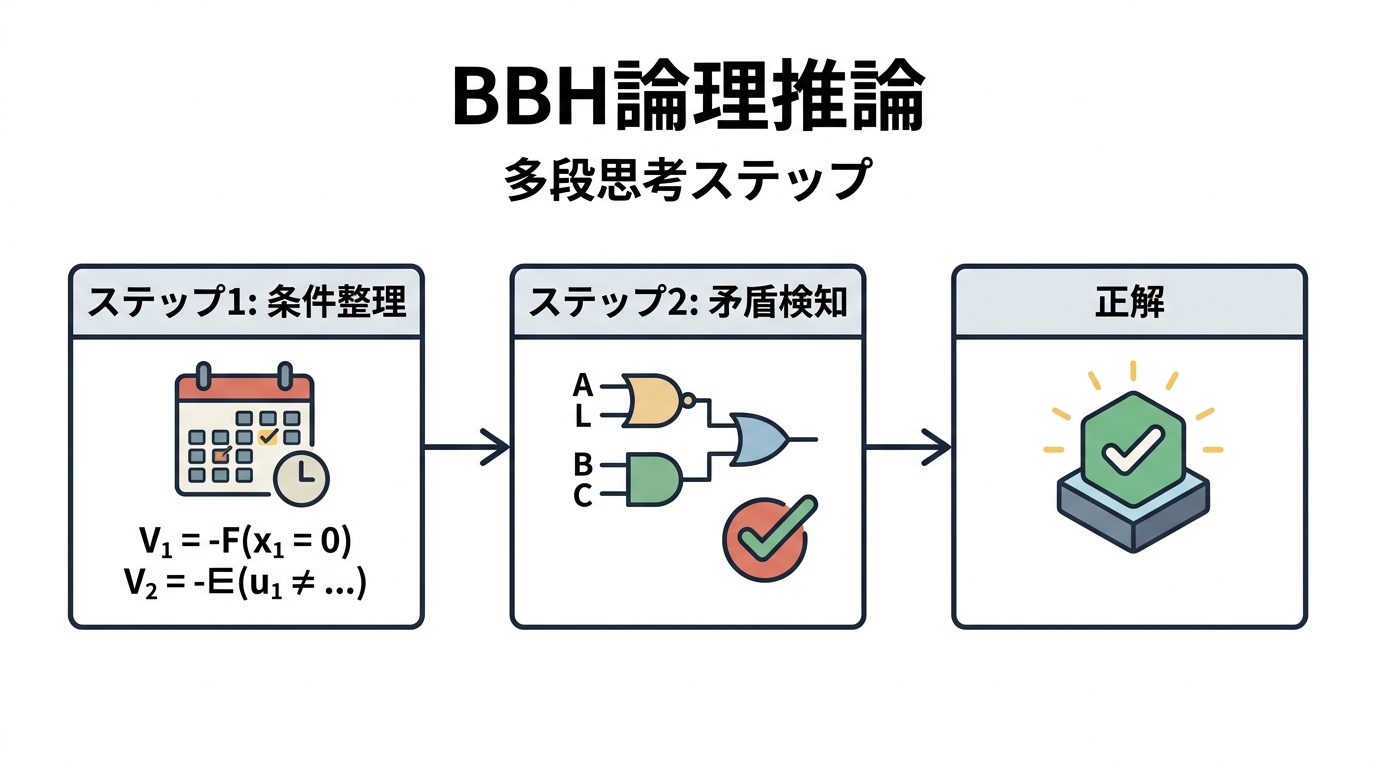
BBHに含まれる23タスクは、単なる知識テストではなく「複雑な手順をルール通りに正確に実行できるか」を問うアルゴリズム的な課題で構成されています。
| タスク名 | 内容と求められる能力 |
|---|---|
| Temporal Sequences(時間順序推論) | 「午前10時に会議、11時半にランチ、13時に外出…」という複雑な日程変更ログから、特定時刻の空き状況や矛盾を特定する。 |
| Boolean Expressions(ブール論理式評価) | 「not (True and not (False or True))」といった多重にネストされた論理演算式を優先順位通りに評価し、True/Falseを判定する。 |
| Geometric Shapes(幾何図形の追跡) | SVGコードやテキストで記述された一連の描画コマンド(右に移動、90度回転など)から、最終的に描かれる図形を予測する。 |
| Web of Lies(嘘つきパズル) | 「AはBが嘘つきだと言い、BはCが正直だと言い…」という多段の証言連鎖から、特定の人物が真実を述べているかを判定する。 |
これらのタスクは、従来の言語モデルのように「次の単語を確率的に予測するだけ」では、3ステップ目あたりで内部状態が破綻してしまい、正解率がほぼゼロに近い状態に陥っていました。
💡 あわせて読みたい
なぜ現代のフロンティアモデル開発でGPQAとBBHが重視されるのか?
CoT(思考の連鎖)と「推論モデル」の登場による劇的ブレークスルー
BBHの研究において最も世界を驚かせた発見の一つが、「Chain-of-Thought(CoT:思考の連鎖プロンプティング)を導入した瞬間に、スコアが劇的に跳ね上がった」という事実です。
思考ステップを出力させずに一発で答えを出させると0点に近かった難関タスクが、モデル自身に「ステップ1…ステップ2…」と途中経過を書き出させるだけで、人間の平均を軽々と抜き去る性能を発揮したのです。
そして2024年後半以降、OpenAIの「o1」シリーズをはじめとする推論特化型モデル(Test-Time Computeを活用し、内部で自己検証と試行錯誤を行うモデル)の登場により、GPQAのスコア競争は新たな次元へと突入しました。
人間PhD超え?GPQAで70%〜80%を叩き出す意味
かつてGPT-4の初期バージョンですら30%台半ば(非専門家の検索スコアと同等)に留まっていたGPQA Diamondにおいて、近年のフロンティアモデルは70%〜80%という驚異的なハイスコアを記録するようになっています。
専門分野の人間PhDが解いて65%〜80%ですから、ベンチマーク上の数字だけを見れば「特定分野の博士号取得者と同等以上の推論精度」に達しつつあることを意味します。
MMLUのような標準テストでは「全モデルが90点台」で団子状態になってしまうのに対し、GPQAやBBHを使えば、「どのモデルが真に複雑な多段推論を粘り強く解き切れるか」が明確に可視化できるため、各社の最重要指標として採用されているのです。
実務でどう見る?エンジニア目線でのGPQA・BBH活用法
日常のWebアプリ開発ではオーバースペック?
ここまでの話を聞くと、「GPQAで高得点なモデルを選べば、どんな開発現場でも最強なのでは?」と思うかもしれませんよね。
しかし、釣り好きエンジニアとしての現場目線で言えば、「一般的なWeb開発や社内FAQボットの用途では、GPQAの差はほとんど体感できない」というのが率直な実感です。
ユーザーからの問い合わせ文を要約したり、定型的なSQLクエリを生成したり、社内Wikiから該当箇所を引用するようなタスクであれば、MMLUで80点台を出せる軽量モデル(GPT-4o miniやClaude 3.5 Haikuなど)で十二分に実用的な成果が出せます。GPQAでハイスコアを出す超弩級モデルを使うと、レイテンシ(応答時間)や推論コストが跳ね上がってしまうデメリットの方が目立ちます。
GPQA・BBHスコアを注視すべき「3つの実務領域」
では、エンジニアがGPQAやBBHのスコアを真剣に見るべきなのはどのような場面でしょうか?具体的には以下の3つの領域です。
- 1. 自律型AIエージェントの構築: 5ステップ〜10ステップ以上にわたり、ツール呼び出し(Web検索、API実行、DB更新)を自律的に繰り返すエージェントでは、BBHで測られる「手順遵守と例外処理の粘り強さ」がシステムの成否を分けます。
- 2. 大規模リファクタリングやアーキテクチャ設計: 依存関係が複雑に絡み合った数千行のレガシーコードを解析し、副作用を起こさずにモジュール分割を設計する作業は、まさにBBH的な高度論理パズルです。
- 3. バイオ・創薬・材料開発・高度特許分析: 専門的な学術文献を複数突き合わせ、未解決の仮説を検証するような研究開発(R&D)領域では、GPQAで証明された「博士レベルの概念連結力」が本領を発揮します。
まとめ
今回は、LLMの推論限界を試す最高峰の難関ベンチマーク「GPQA」と「BBH」について、その過酷な設計哲学から出題ロジック、実務での見極め方までを解説しました。要点を振り返ってみましょう。
- GPQA(Google-Proof Q&A): 生物・物理・化学のPhD保持者が作成した448問。非専門家がGoogle検索を30分駆使しても正解率34%にしかならない極限の検索耐性テスト。
- BBH(BIG-bench Hard): BIG-benchの中から初期LLMが全滅した難関23タスクを抽出。日程パズルやブール論理など、多段階の手順実行・アルゴリズム推論力を測定する。
- 推論モデルの躍進: 思考の連鎖(CoT)やTest-Time Computeの導入により、最新モデルはGPQAで人間専門家水準(70%〜80%)に到達し、性能差を測る試金石となっている。
- 実務での付き合い方: 通常の要約やFAQでは軽量モデルで十分。自律エージェント、複雑なコード設計、高度な学術・特許分析など「多段階の思考破綻が許されない現場」で真価を発揮する。
知識と論理推論の最前線を押さえたところで、次回からは連載の第3弾「対話品質・実用評価編」へと進みます!第6回は、実際のチャットボットとしての会話力とユーザビリティをAI自身が評価する「第6回:MT-BenchとLLM-as-a-Judge!AIがAIを採点する革新的評価手法」を解説します。お楽しみに!
💡 あわせて読みたい
参考リンク・公式ドキュメント
- 📄 Rein et al. (2023) — GPQA: A Graduate-Level Google-Proof Q&A Benchmark (原著論文)
- 📄 Suzgun et al. (2022) — Challenging BIG-bench Tasks and Whether Chain-of-Thought Can Solve Them (BBH原著論文)
- 🌐 idavidrein / gpqa 公式GitHubリポジトリ
- 🌐 suzgunmirac / BIG-bench-Hard 公式GitHubリポジトリ
- 📰 片田舎釣り好きエンジニアの研究室 — LLMの評価指標・ベンチマーク完全総覧【全体俯瞰編】