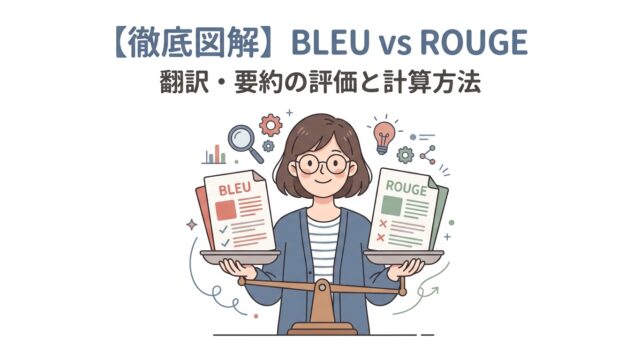
AI・機械学習 BLEUとROUGEの違いと計算方法!機械翻訳・要約の評価指標を図解 機械翻訳向けのBLEUと文章要約向けのROUGEの計算アルゴリズムと違いを図解。LLM出力評価における使い分けと限界をエンジニア向けに解説。 2026.09.08 AI・機械学習技術・プログラミング
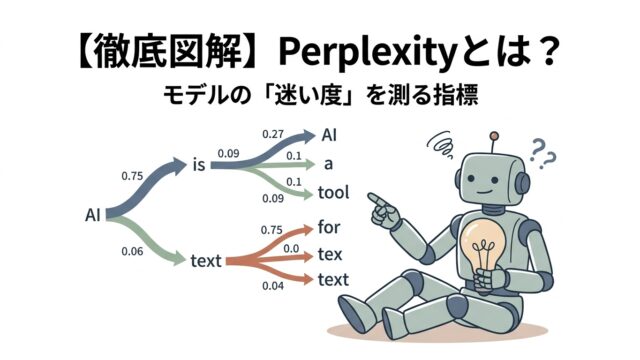
AI・機械学習 Perplexity(PPL)とは?計算方法と具体例でわかるLLM評価指標 LLMの予測性能を測る基本指標Perplexity(PPL)の数学的定義と直感的意味を図解解説。モデル比較での見方や注意点をエンジニア向けに整理。 2026.09.07 AI・機械学習技術・プログラミング
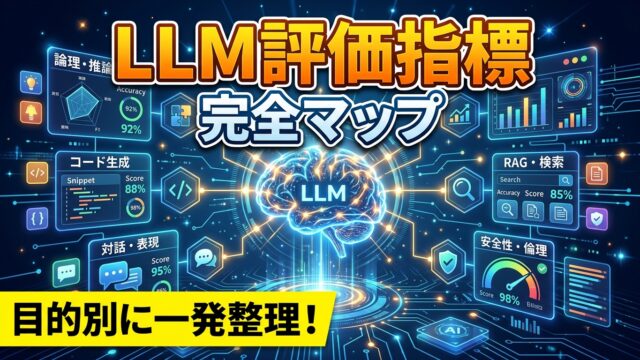
AI・機械学習 LLMの評価指標・ベンチマーク完全総覧!目的別カテゴリマップと実務での選び方【全体俯瞰編】 LLMベンチマークの全体像を体系化。知識・推論・対話・コードなど目的別の評価指標マップと、自社開発での評価指標の選び方を網羅した完全ガイド。 2026.09.03 AI・機械学習AI活用技術・プログラミング
 AI・機械学習 AI・機械学習
 AI・機械学習
 AI・機械学習