「半導体チップやFPGAの回路設計(RTL設計)をやってみたいけれど、VerilogやVHDLを手書きするのはハードルが高すぎる……」
「タイミング制約を満たすために、何日もかけてフリップフロップ(レジスタ)の段数を手動で挿入し直す作業にうんざりしている」
カスタムアクセラレータやエッジAIチップの重要性が爆発的に高まる中、多くのソフトウェアエンジニアやハードウェア設計者がこの「回路設計の開発生産性の低さ」に頭を抱えています。
こうした中、Googleがオープンソース(Apache 2.0)として公開し、開発コミュニティで大きな注目を集めているのが、次世代ハードウェア合成ツールチェーン「XLS(Accelerated HW Synthesis)」です。
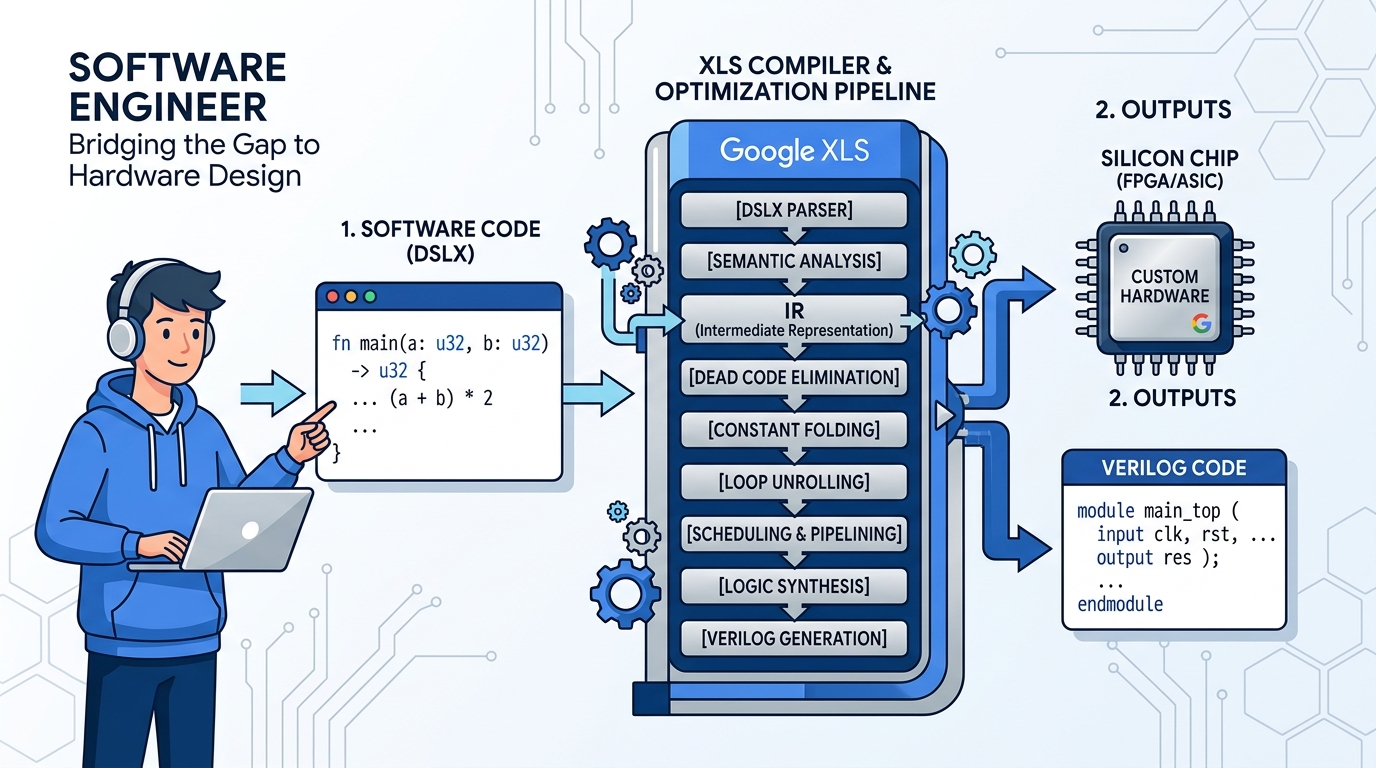
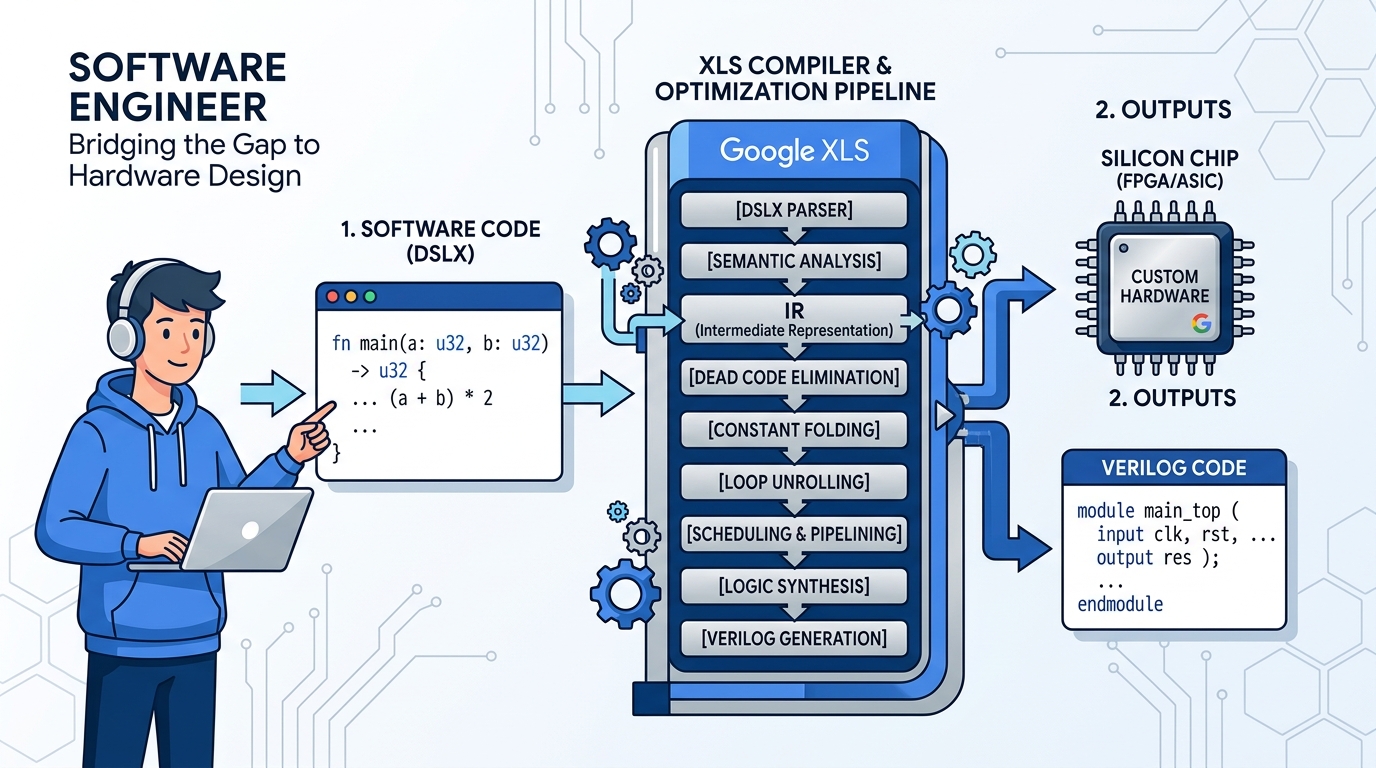
XLSは、Rustにインスパイアされた独自言語「DSLX」でソフトウェアのようにロジックを記述するだけで、コンパイラが自動的に遅延解析を行い、指定した周波数(クロック)に応じた最適段数のパイプライン化されたVerilog/SystemVerilogを完全自動生成します。単なる構想や実験作にとどまらず、Google内部のTPU開発や画像処理IPの実装でも培われた知見が惜しみなく投入されています。
本記事では、XLSが従来のHLS(高位合成)と何が決定的に違うのかという設計哲学から、BazelやDockerを用いた環境構築、加算器・積和演算(MAC)のDSLX実装コード、生成されたSystemVerilogの差分比較、そして現場でハマるアンチパターンまで完全網羅して徹底解説します!
XLSとは何か——「ソフトウェアの言葉でハードウェアを設計する」アプローチ
従来の半導体設計(RTL設計)は、VerilogやSystemVerilogを用いて、クロックの立ち上がりごとにレジスタ間でデータがどう流れるかを1サイクル単位で厳密に手書きする必要がありました。これはソフトウェアで言えば、アセンブラでCPUレジスタを手動管理しているような状態です。
XLS(Accelerated HW Synthesis)は、このレイヤーを一段引き上げ、「ソフトウェアエンジニアが関数型言語の感覚でアルゴリズムを書けば、コンパイラが最適なハードウェア回路へ落とし込む」ことを実現するツールチェーンです。
- フロントエンド言語「DSLX」: Rustに極めて近い構文を持つ、副作用のない純粋関数型DSL。型推論、ジェネリクス、静的配列、単体テスト機能を標準装備。
- 中間表現「XLS-IR」: LLVMに似たSSA(静的単一代入)形式のデータフローグラフ。ビット幅の最適化や不要演算の削除を数学的に実行。
- バックエンド「Codegen」: ターゲットとするプロセスルール(SkyWater 130nmやASAP7など)の遅延ライブラリに基づき、回路を自動でパイプライン分割してSystemVerilogを出力。
【図解】従来のC/C++ HLSとの違い:なぜXLSは「ブラックボックス」にならないのか?
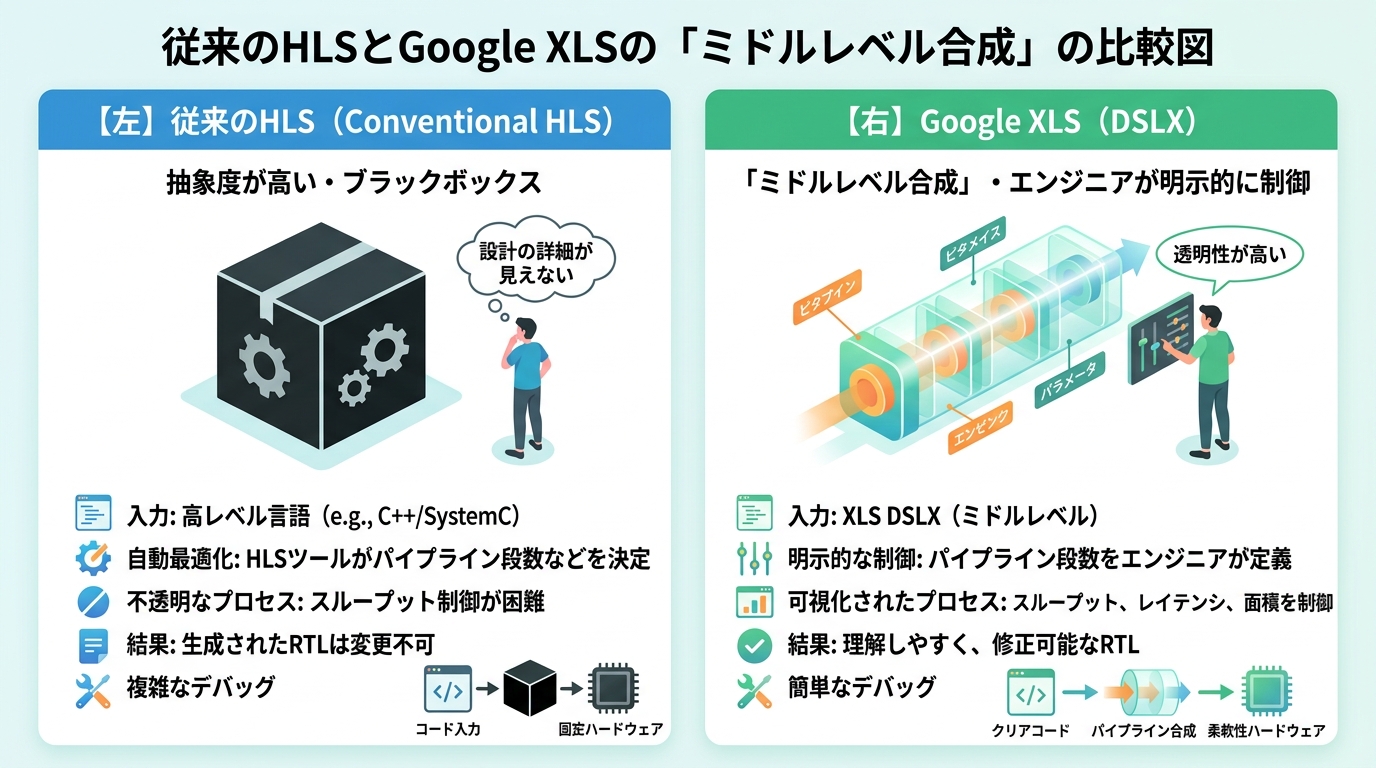
「高級言語からVerilogを生成する」という試み自体は、Vivado HLSやCatapultなどの「高位合成(HLS: High-Level Synthesis)」として20年以上前から存在しています。しかし、従来のHLSは現場のハードウェアエンジニアから敬遠されることも少なくありませんでした。その最大の原因は「C/C++という言語自体がハードウェア設計に向いていないこと」にあります。
| 比較項目 | 従来のC/C++ HLS(Vivado等) | Google XLS(DSLX) |
|---|---|---|
| 記述言語 | C / C++ / SystemC | DSLX(Rustライクな独自DSL) |
| ポインタ・参照 | あり(エイリアス解析が難解) | 完全排除(値渡しのみ) |
| 副作用・グローバル状態 | あり(未定義動作や競合のリスク) | 完全排除(純粋関数型) |
| パイプライン制御 | #pragma HLS PIPELINE などの指示文依存(思い通りに展開されないことが多い) | コンパイラが数学的最適化 (クロック遅延モデルから自動スケジューリング) |
| デバッグとテスト | 重いRTLシミュレータが必須 | DSLX単体でミリ秒単位の即時テスト実行が可能 |
| 設計の制御性 | ブラックボックスになりやすい(高位) | ミドルレベル合成(制御性と抽象度の黄金比) |
C/C++にはポインタやグローバル変数があるため、コンパイラは「この2つのメモリアクセスが同時に起きる可能性があるか」を静的に証明できず、保守的(低速)な回路しか生成できませんでした。一方、DSLXはポインタも副作用もないため、コンパイラは完全なデータフロー有向非巡回グラフ(DAG)を構築でき、極限まで無駄のないハードウェアを数学的・決定論的に合成できるのです。
【実践】加算器・積和演算(MAC)のDSLXコードと単体テスト
百聞は一見にしかずです。AIアクセラレータの中核演算である「積和演算(MAC: Multiply-Accumulate / $A imes B + C$)」をDSLXで記述してみましょう。8ビット整数2つの積を取り、16ビットのアキュムレータに加算する回路です。
1. DSLXコードの実装(mac.x)
// 8ビット乗算 + 16ビット加算を行う積和演算(MAC)ユニット
fn mac(a: u8, b: u8, c: u16) -> u16 {
    // 明示的な型キャストを行い、オーバーフローを防ぐ
    let product = (a as u16) * (b as u16);
    product + c
}

// 組み込みの単体テスト(ハードウェア記述と同時にテストを書ける)
#[test]
fn test_mac() {
    // 3 * 4 + 10 = 22
    let result = mac(u8:3, u8:4, u16:10);
    assert_eq(result, u16:22);

    // 最大値境界テスト: 255 * 255 + 0 = 65025
    let max_test = mac(u8:255, u8:255, u16:0);
    assert_eq(max_test, u16:65025);
}
Rustを書いたことがあるエンジニアなら、一目で理解できる簡潔さです。ビット幅が u8 や u16 のように明示され、#[test] アトリビュートによって回路の論理検証コードを同一ファイル内に記述できます。
2. ソフトウェアとしての高速シミュレーション実行
ハードウェアのシミュレータ(ModelSimやVerilator等)を立ち上げる必要はありません。XLSのインタープリタを使って、ソフトウェアとして瞬時にテストを実行できます:
# DSLXの単体テストを実行
bazel run //xls/dslx:interpreter_main -- /workspace/mac.x

# 実行結果:
# [ RUN UNITTEST  ] test_mac
# [            OK ] test_mac
# [===============] 1 test(s) ran; 0 failed; 0 skipped.
【Verilog生成比較】手書き不要!自動パイプライン化の衝撃
ここからがXLSの真骨頂です。この mac.x を、200MHzで動作させる「2段パイプライン構成のSystemVerilog」へと自動変換します。
1. DSLXからXLS-IRへのコンパイル
# DSLXを中間表現(IR)へ変換
bazel run //xls/dslx/ir_converter:ir_converter_main -- /workspace/mac.x > /workspace/mac.ir
2. Codegenによるパイプライン化Verilog生成
# 2段パイプライン(pipeline_stages=2)を指定してSystemVerilogを出力
bazel run //xls/tools:codegen_main -- \
  --input_ir_path=/workspace/mac.ir \
  --top=mac \
  --generator=pipeline \
  --pipeline_stages=2 \
  --delay_model="asap7" \
  --output_verilog_path=/workspace/mac.sv
生成されたSystemVerilogコード(mac.svの抜粋)
module mac(
  input wire clk,
  input wire [7:0] a,
  input wire [7:0] b,
  input wire [15:0] c,
  output wire [15:0] out
);
  // Pipeline Stage 0
  wire [15:0] p0_a_ext = {8'h00, a};
  wire [15:0] p0_b_ext = {8'h00, b};
  wire [15:0] p0_prod = p0_a_ext * p0_b_ext;

  // Auto-inserted Pipeline Registers
  reg [15:0] p1_prod_reg;
  reg [15:0] p1_c_reg;

  always_ff @(posedge clk) begin
    p1_prod_reg <= p0_prod;
    p1_c_reg    <= c;
  end

  // Pipeline Stage 1
  wire [15:0] p1_sum = p1_prod_reg + p1_c_reg;
  assign out = p1_sum;
endmodule注目すべきは、クロック clk に同期するパイプラインレジスタ(p1_prod_reg、p1_c_reg)が完全に自動生成されている点です。
手書きのRTL設計では、「クロック周波数を100MHzから400MHzに引き上げたい」となった場合、回路全体の遅延を見直してレジスタを挿入し直し、全ステージのタイミングを手動で同期させなければなりませんでした。しかしXLSなら、コマンドライン引数を --pipeline_stages=4 に変えて再コンパイルするだけで、最適な4段パイプライン回路が一瞬で再生成されます。これがハードウェア開発の生産性を桁違いに高める理由です。
現場エンジニアがハマる3大落とし穴とアンチパターン
ソフトウェア開発の感覚でDSLXを書き始めると、ハードウェア特有の制約によってエラーに直面することがあります。事前に知っておくべき3つの落とし穴を解説します。
① 動的な終了条件を持つループの禁止
DSLXでは while (condition) や、実行時入力によってループ回数が変わる動的ループは記述できません。ハードウェアは物理的なシリコン回路として焼き付けられるため、コンパイル時にすべてのループが「固定回数で完全にアンロール(展開)」できなければならないからです。反復処理を行う場合は、コンパイル時定数を用いた for (i, acc) in range(u32:0, u32:8) のような有界ループを使用します。
② 暗黙の型変換(Implicit Cast)への過信
C言語などでは uint8_t と uint16_t の演算時に自動で格上げ(プロモーション)が行われますが、DSLXは極めて厳格な型安全を採用しています。(a as u16) * (b as u16) のように、乗算を行う前に明示的に目的のビット幅へキャストしないと、演算途中でオーバーフローを起こして上位ビットが切り捨てられます。ハードウェアのビット幅意識をコード上で明確に表現することが求められます。
③ 遅延モデル(Delay Model)の未指定
codegen_main を実行する際、--delay_model を指定しないと、コンパイラは物理的なゲート遅延を見積もることができず、最適でないステージ分割を行ってしまいます。実務では asap7(オープンソースの7nm予測プロセス)や sky130(SkyWater 130nmオープンプロセス)などの適切な遅延プロファイルを必ず指定してください。
よくある質問(FAQ)
Q1: Bazelをローカルにインストールするのが大変です。手軽に試す方法は?
A. 公式のDockerイメージを利用するのが最も手軽です。
Google XLSのリポジトリにはコンテナ環境が用意されており、docker run で起動するだけで、Bazelやコンパイラツールチェーンがすべて揃った環境ですぐにDSLXのコンパイルとテストを実行できます。
Q2: XLSで生成されたVerilogは商用ASICやFPGAでそのまま使えますか?
A. はい、標準的な論理合成ツール(Synopsys Design Compiler, Yosys, Vivado等)にそのまま流し込めます。
XLSが出力するのは標準的なIEEE準拠のSystemVerilogコードであるため、既存のEDAツールチェーンやオープンソースASIC設計フロー(OpenLane等)と完全にシームレスに統合可能です。
Q3: ChiselやSpinalHDLといった他のハードウェア記述DSLとの違いは?
A. 「サイクル精度の記述」か「自動スケジューリング」かの違いです。
Chisel(Scalaベース)などは人間がサイクルごとのレジスタ配置を明示的にプログラミングする「ハードウェア構築言語(HCL)」です。一方、XLSは純粋なアルゴリズム仕様から「クロックサイクルとパイプライン段数そのものをコンパイラが自動決定する」という点で、より高次の自動化を目指しています。
まとめ:ソフトウェアとハードウェアの境界が溶ける未来へ
今回は、Googleが開発するオープンソースのハードウェア合成ツールチェーン「XLS」の全貌を、コード実装とVerilog生成の比較を交えて解説しました。
- XLSの本質: 副作用のない関数型DSL「DSLX」を採用することで、従来のHLSが抱えていたポインタやメモリ競合のブラックボックス化を完全克服。
- ソフトウェア感覚の高速検証: インタープリタにより、ミリ秒単位で単体テスト(
#[test])を実行できる圧倒的なアジリティ。 - 自動パイプライン化の威力: 周波数やステージ数のフラグを変更するだけで、最適なフリップフロップ配置を含むSystemVerilogを瞬時に再生成。
- エンジニアの可能性: ソフトウェア開発者が自分専用のAI推論アクセラレータや暗号化コプロセッサを自作できる時代が現実になりつつある。
AIモデルの進化と専用チップの融合が進む中、以前解説したAnthropicのModel Hardware Standard (MHS)のように、ハードウェアとソフトウェアの協調設計はエンジニアにとって最大の競争領域になりつつあります。ぜひ本記事のコードを足がかりに、XLSの洗練されたシリコン合成の世界を体験してみてください!
💡 あわせて読みたい:ハードウェアとAIモデルの標準化動向
Anthropicが提唱するModel Hardware Standard (MHS) とは?AIモデル開発の標準化規格を解説
💡 あわせて読みたい:爆速推論を実現するロボットAIの幾何モデル