「ChatGPTやClaudeなどの大規模言語モデル(LLM)をいくらスケールアップしても、人類が夢見るAGI(汎用人工知能)には永遠に到達できないのではないか?」
日頃からAIモデルを触っているエンジニアの方なら、モデルが驚くほど賢い回答を返す一方で、小学生でも間違えないような物理的な空間感覚や、簡単な重力・接触のシミュレーションで呆気なくボロを出す瞬間に直面したようなことが一度はあるのではないでしょうか?
結論から言えば、2026年8月に産総研(AIST)の片岡裕雄氏をはじめ、スタンフォード大学、オックスフォード大学、Google DeepMind、カーネギーメロン大学(CMU)、Meta FAIRなど、世界を代表するトップAI研究者21名が共同で発表した記念碑的ホワイトペーパー「Visual General Intelligence(VGI: 視覚汎用知能)」は、まさにこの「言語偏重のAI開発」に強烈な一石を投じる内容となっています。
以前当ブログで執筆したLLMの推論能力の限界と課題に関する考察でも触れましたが、テキスト記号の確率予測だけに頼った知能には、物理世界との「接地(Grounding)」が決定的に欠けています。この記事では、なぜ今世界トップの研究者たちが「言語から視覚へ」と舵を切ろうとしているのか、提唱されたVGIの全体像と実務エンジニアが知っておくべきパラダイムシフトを分かりやすく解説していきますね!
なぜ「言語モデル(LLM)だけではAGIに到達できない」と言われるのか?
現在、OpenAIやAnthropicをはじめとするメガテック各社は、Web上の膨大なテキストデータを巨大なTransformerに読み込ませ、計算リソースを注ぎ込む「スケーリング則」によって急速な進化を遂げてきました。しかし、このアプローチには根本的な限界が横たわっていると著者らは指摘します。
カンブリア爆発に学ぶ「眼」の誕生と知能の起源
生命の進化の歴史を振り返ると、生物に高度な「眼(視覚システム)」が誕生したのは、今から約5億年前のカンブリア紀にまで遡ります。眼の誕生によって生物は周囲の空間、光、障害物、捕食者の動きを瞬時に知覚できるようになり、これが生命の爆発的な多様化(カンブリア爆発)を駆動したと言われていますよね。
一方で、人類が文字や体系的な言語、英語や日本語といった自然言語を操るようになったのは、生物の歴史から見ればごく最近(数万年〜数千年前)の出来事に過ぎません。私たち人間も、言葉を1つも話せない赤ん坊のころから、手足をバタつかせ、物を落とし、見つめるという「視覚と身体の相互作用」を通じて、重力や奥行き、物体の永続性といった物理世界の基本ルールを自然に体得しています。
言語は人間が圧縮した記号に過ぎないという決定的な壁
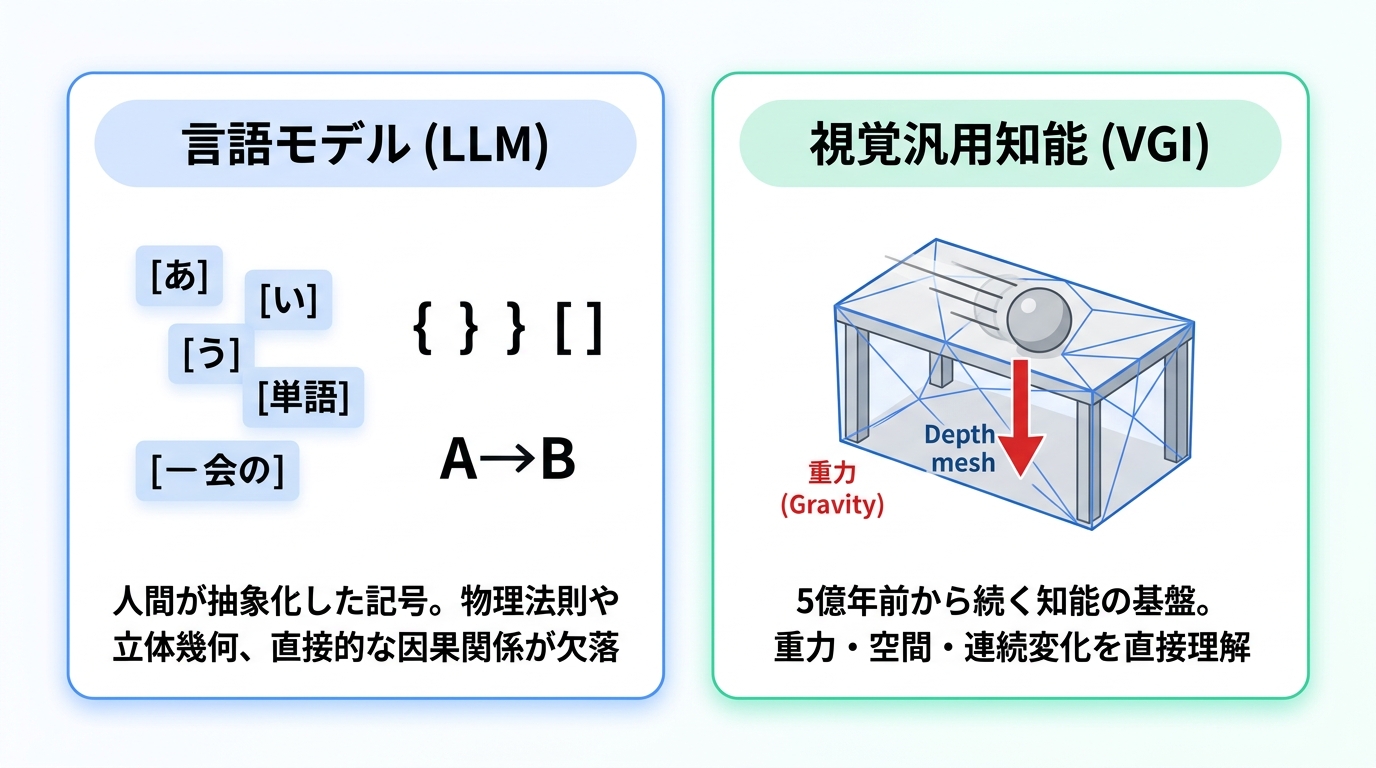
つまり、自然言語とは「人間が認知した物理世界の膨大な情報の中から、ごく一部を抽出して圧縮したシンボル体系」に過ぎないのです。テキストの中には、3次元の幾何構造やミリ単位の連続的な力加減、光と影の相互作用といった生々しい物理現実そのものは存在しません。
- 言語の限界(圧縮の代償): 言語は高度に抽象化されているため論理や要約には強い反面、物理世界の立体構造や空間的因果関係を直接表現することができません。
- 視覚の豊かさ(非記号の連続信号): 視覚はピクセルという膨大な連続データであり、言語のように都合よく定義されたトークン階層を持ちません。だからこそ、視覚から直接学習することでしか得られない「世界の内部モデル」が存在するのです。
「言葉の意味をいくらこねくり回しても、物理世界そのものを体験したことのない脳は、本当の意味で世界を理解できない」。これこそが、VGI(視覚汎用知能)が提起する最大の問題意識なのです。
21名の世界的AI研究者が提唱する「VGI(Visual General Intelligence)」とは?
では、論文で提唱されている「VGI(Visual General Intelligence)」とは一体どのような概念なのでしょうか?単に「画像認識の精度が上がったモデル」や「LLMの頭にカメラをくっつけただけのマルチモーダルモデル(VLM)」とは何が違うのでしょうか。
日米欧トップ21名が集結した歴史的ホワイトペーパー
このホワイトペーパーの特筆すべき点は、産総研の片岡裕雄氏らをはじめ、スタンフォード大のJiajun Wu氏、Meta FAIRのZhuang Liu氏、Google DeepMindのRobert Geirhos氏、CMUのDeva Ramanan氏など、コンピュータビジョン(CV)の歴史を築いてきた最前線の研究者21名が所属の枠を超えて集結した点にあります。
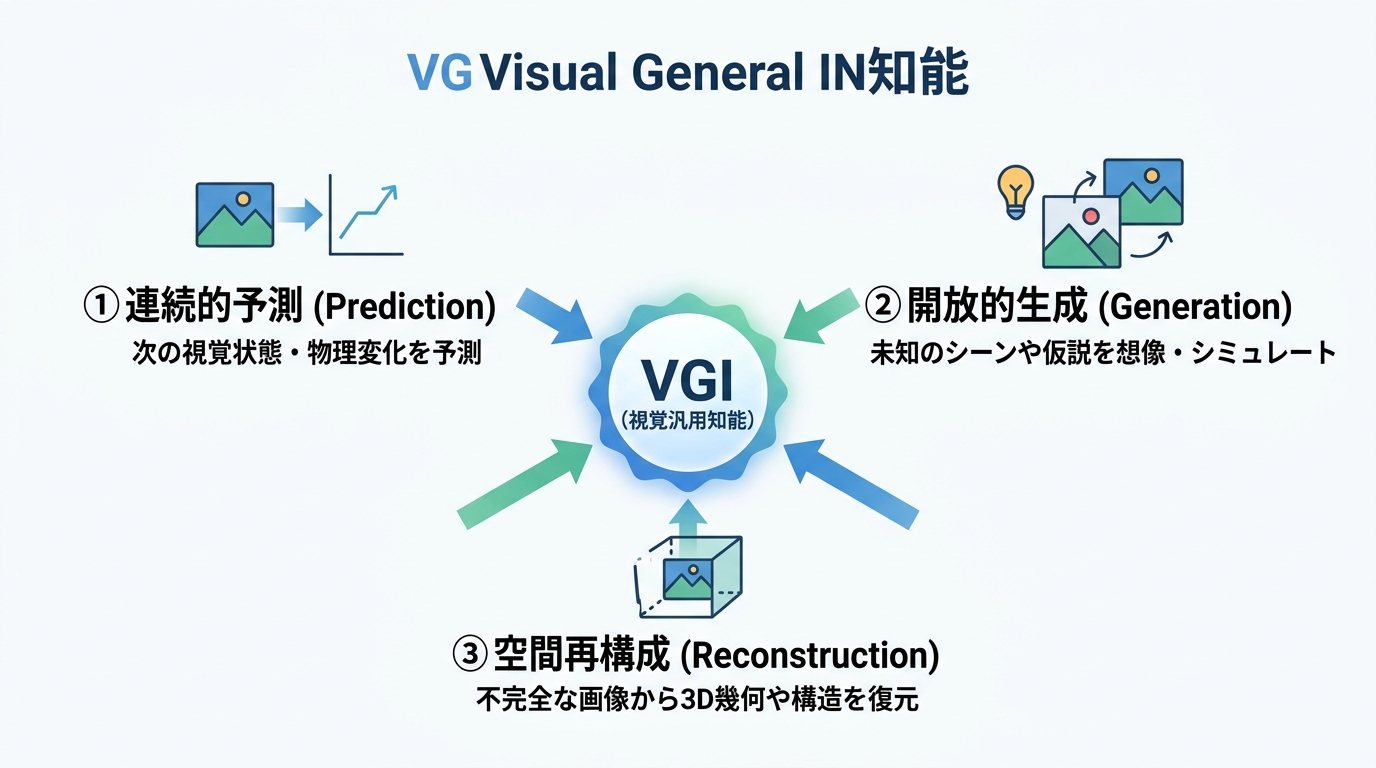
CVPR 2026で開催された「VGI Workshop」での議論をベースにまとめられた本稿は、単一のモデル構造を押し付けるのではなく、「AGI時代においてコンピュータビジョンが目指すべき指針」を多角的な視点から体系化しています。著者らは、VGIを「視覚的な体験を通じて世界の構造を自ら発見・検証し、未来を予測し、未知の可能性を想像し、新しい状況に適応できる知能」と定義しています。
VGIを駆動する3つの柱(予測・生成・再構成)
ホワイトペーパーにおいて、視覚から知能を創発させるための核心的メカニズムとして提示されているのが、以下の3つの相補的な学習オペレーションです。
- ① 連続的予測(Sequential Prediction): 次に来る視覚状態を予測する自己回帰モデル。言語におけるNext-Token Predictionと同様に、「次どうなるか」を正確に予測するためには、物体、動き、遮蔽、物理法則を深く理解しなければならず、これが世界モデルの核となります。
- ② 開放的生成(Open-ended Generation): 未知のシーンやあり得べき未来を想像する生成能力。単なる画像出力にとどまらず、エージェントが頭の中で「もしこう動いたらどうなるか?」という反実仮想(Counterfactuals)をシミュレーションするための思考エンジンとなります。
- ③ 空間再構成(Spatial Reconstruction): 不完全な2D画像から、背後にある3次元・4次元の立体構造や物理的因果関係を復元する能力。空間の整合性や物体の実体を捉えるための必須機能です。
💡 あわせて読みたい
これら3つの機能が組み合わさることで、AIは単なる「画像の説明係」から「物理空間を能動的に理解して動く知能」へと進化するわけですね。
動画生成モデルは「世界モデル」へ進化する?トップ研究者たちの視点
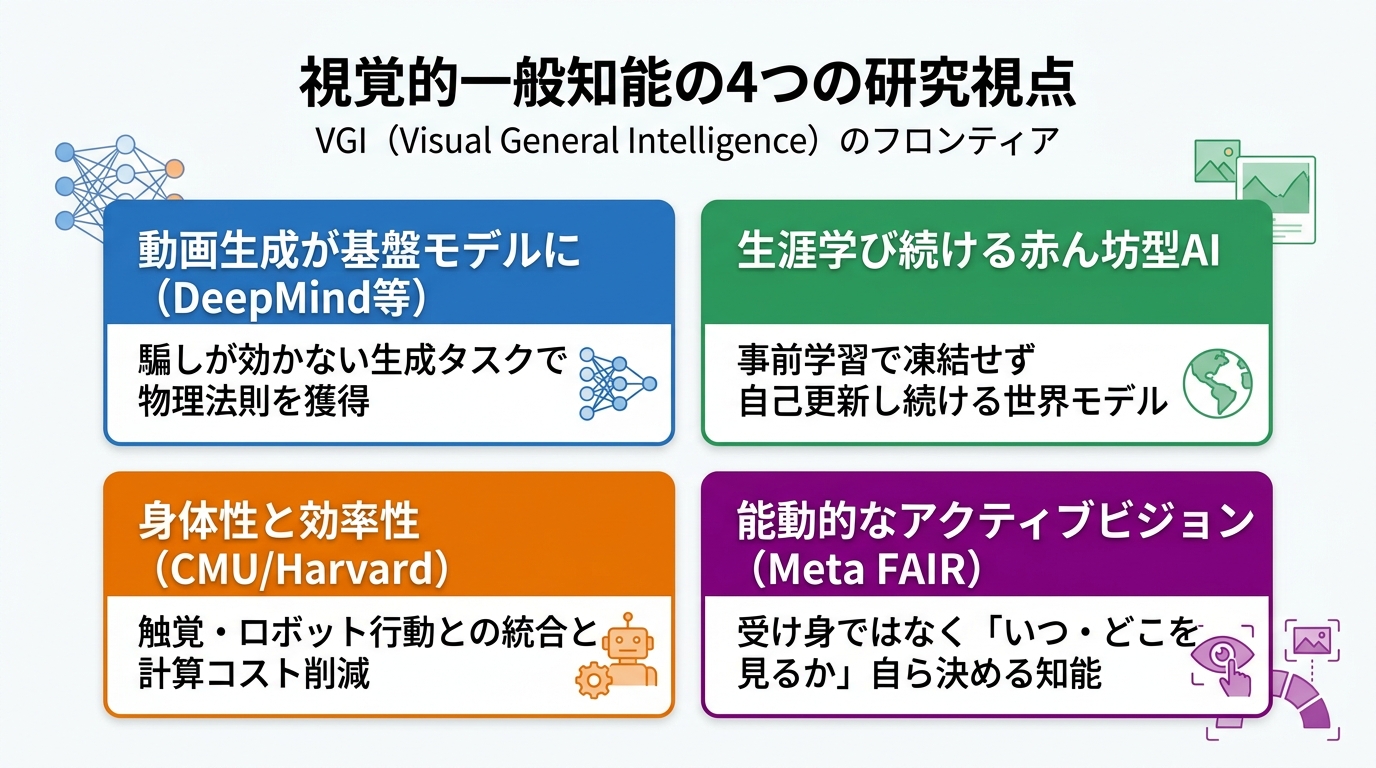
本論文の非常に面白いところは、21名の一流研究者たちがそれぞれの専門分野から「VGIをどう実現すべきか」という白熱した持論(Bets)を展開している点です。現場のエンジニアにとっても目からウロコな4つの重要視点を紹介します。
「動画生成」が判別タスクを圧倒する理由(ショートカットの排除)
Google DeepMindのRobert Geirhos氏は、「動画生成モデルこそが次世代の視覚基盤モデルになる」と力説しています。従来の画像分類(ImageNetなど)では、AIは「背景の緑色を見て牛と答える」といった安易なズル(ショートカット学習)をしてしまいがちでした。
しかし、動画生成というタスクではズルが一切通用しません。背景、物体、陰影、テクスチャ、カメラの視点移動、物体の運動を完璧に整合させなければ破綻してしまうため、モデルは学習の過程で「物理法則そのもの」を内包せざるを得ないのです。実際にVeo 3などの最新動画生成モデルでは、明示的に学習させていないセグメンテーションや迷路探索といった視覚推論能力が勝手に創発し始めていることが報告されています。
一度きりの学習から「生涯にわたる自律的適応」へ
また、アムステルダム大学のYuki M. Asano氏やCMUのDeva Ramanan氏、Meta FAIRのZhuang Liu氏らが提起する視点も痛烈です。
- 生涯自律学習(Lifelong Learning): 現在のAIは「巨大データで一度学習して固定(Freeze)する」のが常識ですが、現実世界で動く知能は、赤ん坊のように一生を通じて新しい視覚体験から自己を更新し続けなければならない。
- 身体性と触覚の統合(Embodied AI): ロボティクスにおいて視覚は単独で存在するのではなく、足腰の自己受容感覚や指先の触覚、モーターのトルクと不可分に結びつくことで真の知能になる。
- アクティブビジョン(能動的知覚): 与えられた画像をただ受動的に眺めるのではなく、「次は何を見るべきか」「どこに注目してどの解像度で精査すべきか」をモデル自身が能動的に決めるべきである。
OpenAIが動画生成モデルSoraの商用展開において膨大な推論コストの壁に直面した事例にも触れられており、単にモデルを巨大化するだけでなく、3D表現や効率的な状態保持(メモリー構造)を再導入することの切実さも語られています。
エンジニア視点での示唆:LLMブームの次に来る「フィジカルAI」の波
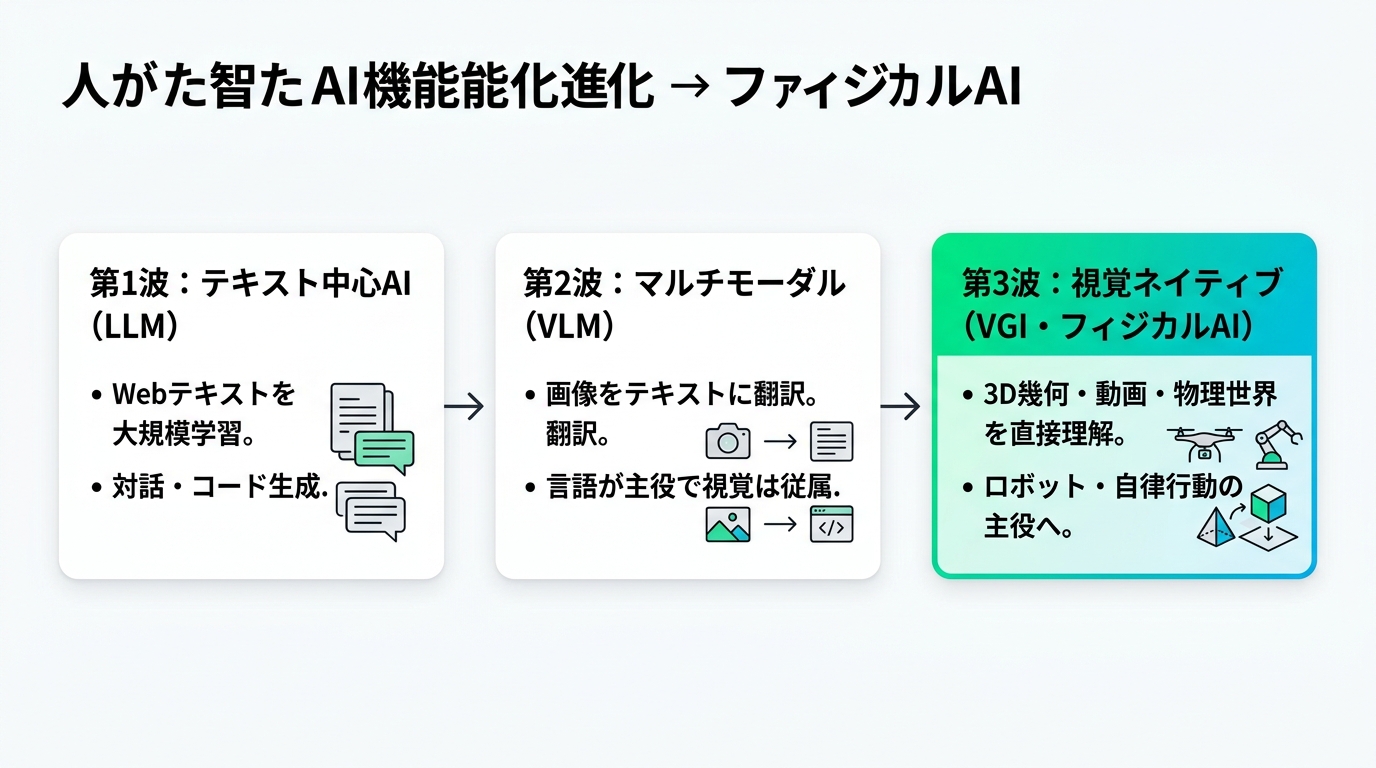
このホワイトペーパーが私たち現場のソフトウェアエンジニアやAI開発者にもたらす教訓は何でしょうか?それは、AI開発の主戦場が確実に「テキスト処理」から「フィジカルAI(物理世界を相手にするAI)」へと移行しつつあるという確信です。
「言語のオマケとしての画像」から「視覚ネイティブな知能」への逆転
これまでのマルチモーダルAI(GPT-4Vなど)は、基本的に「LLMという巨大なテキスト脳があり、そこに視覚エンコーダー(CLIP等)を後付けして、画像を無理やりテキストトークンに翻訳して流し込む」という主従関係でした。つまり、主役はあくまで言語だったのです。
しかしVGIが提唱するのは、この主従関係の完全な逆転です。「物理世界を捉える視覚・空間知覚こそが知能のOS(基本基盤)であり、言語はその上に乗るコミュニケーション用インターフェースに過ぎない」という考え方ですね。先日解説したロボット制御モデル「GAM」のように、3D幾何や動画予測をポリシーの土台にする動きは、まさにこのパラダイムシフトの先駆けと言えます。
実世界応用を見据えたエンジニアの生存戦略
今後、自動運転、人型ロボット、ドローン、スマートグラス(空間コンピューティング)、工場の自動化などを手がけるエンジニアにとって、「プロンプトエンジニアリング」や「テキストRAG」のスキルだけでは差別化が難しくなっていくでしょう。
これからは、「3D点群やデプスマップの扱い」「動画生成モデルを用いた物理シミュレーション」「ロボットアームやエッジデバイスでの超低遅延推論アーキテクチャ」といった、実世界の空間・物理に根ざしたエンジニアリング能力が圧倒的な強みになっていくはずです。
まとめ
今回は、世界のトップ研究者21名が提示した注目のホワイトペーパー「Visual General Intelligence(VGI: 視覚汎用知能)」の内容と、それが示唆する未来のAIアーキテクチャについて解説しました。要点を振り返ってみましょう。
- 言語の壁: テキストは人間が圧縮した記号に過ぎず、物理法則や3D幾何が欠落しているため、LLMのスケールアップだけでは真の物理世界理解(AGI)に到達できない。
- VGI(視覚汎用知能)の定義: 視覚的な体験を通じて世界の構造を自ら学び、予測・生成・再構成を統合して未知の環境に適応する新しい知能の枠組み。
- 動画生成=世界モデル: ショートカットを許さない動画生成タスクを通じて、モデルは物理法則や因果関係を自然に内包する。
- フィジカルAIへの大転換: 言語の従属物としての画像認識から、視覚と空間幾何を中核に据えた「視覚ネイティブな知能」へとパラダイムが移り変わる。
「言葉を覚える前に、まず世界を目で見つめ、手で触れて理解する」。人間の成長と同じプロセスをAIにも辿らせようというVGIのアプローチは、どこか原点回帰のようでありながら、極めて本質的でワクワクさせられますよね。物理空間で動くAIの未来に興味がある方は、ぜひ公開されたarXiv論文の原典にも目を通してみてはいかがでしょうか!
💡 あわせて読みたい
💡 あわせて読みたい