「量子コンピュータや量子多体系のシミュレーションって、状態空間が指数関数的に爆発してしまって計算が追いつかない…」そんな壁にぶつかったことはないでしょうか?
そんな中、2026年8月に発表されたレビュー論文『Quantum Monte Carlo in the Age of Many-Body Quantum Information』が、この分野に大きな示唆を与えています。
この記事を読むと、長年使われてきた「量子モンテカルロ法(QMC)」が、現代の量子情報科学の発展に合わせてどのように進化し、エンタングルメントなどの複雑な「非線形」な性質を計算できるようになったのかがわかります。
量子モンテカルロ法(QMC)と多体系物理学の現在地
量子モンテカルロ法(QMC)は、強相関量子多体系(たくさんの量子が互いに強く影響を及ぼし合うシステム)を研究するための強力な数値計算ツールです。簡単に言えば、確率的な乱数(モンテカルロサンプリング)を用いて、本来なら巨大すぎて計算できない量子状態の性質を近似的に求める手法です。
これまでQMCは、磁化やエネルギーといった「線形な観測量」を計算するために使われてきました。しかし近年、量子情報科学が発展したことで、物理学が知りたい情報はより深く、複雑になっています。以前書いたLLMの内部状態に関する記事でも触れたように、システム全体の振る舞いを理解するには、表面的な出力だけでなく「内部で情報がどう絡み合っているか」を解き明かす必要があります。量子物理学におけるその「絡み合い」の指標が、エンタングルメントなどの量子情報量です。
- 線形観測量の限界:エネルギーやスピンの向きだけでは、トポロジカルな性質や量子もつれの深さを測ることができません。
- 非線形診断の必要性:現代の物理学では、エンタングルメント・エントロピーや「量子マジック(非スタビライザー性)」といった、密度行列の2乗以上に依存する非線形な指標が不可欠になっています。
- QMCの拡張:本論文は、QMCがこうした非線形な量子情報量を抽出できるように、いかにアルゴリズムを拡張してきたかを体系的にまとめています。
つまり、単なる「状態の測定」から「情報の構造の診断」へと、QMCの役割が大きくシフトしているのです。
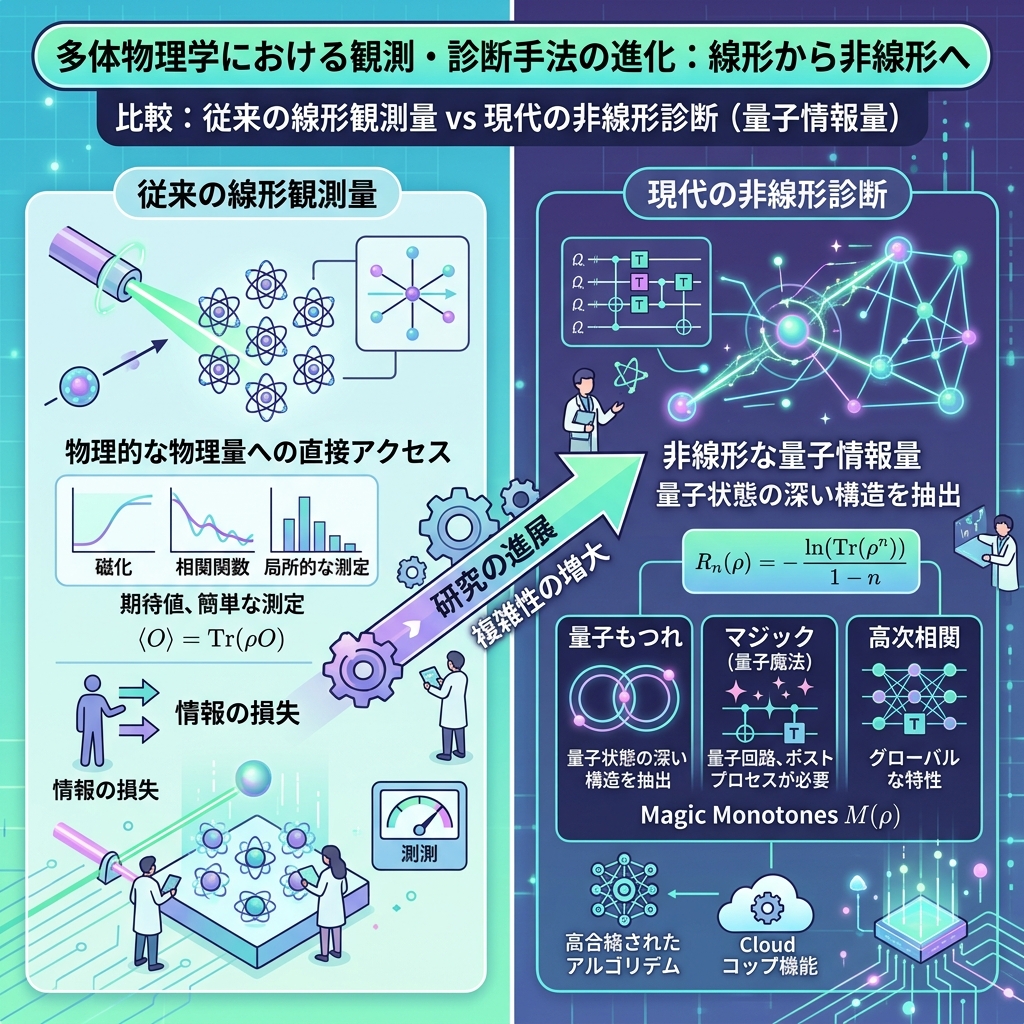
【図解】線形観測量から非線形な「量子情報量」への進化
従来の観測手法の限界
従来のQMCで計算していたのは、主に⟨O⟩=Tr(ρO) の形で表される線形な観測量でした。これは実験室で直接測定できる物理量に対応しています。しかし、この方法では「量子もつれ」のような、複数の状態間の相関の背後にある深い構造を取り逃がしてしまいます。
新たな非線形診断ツールたち
現代のQMCアルゴリズムでは、以下のような非線形な量子情報量を計算できるようになっています。
- エンタングルメント・エントロピー:システムがどれくらい「もつれて」いるかの基本指標。
- レニイ・ネガティビティ(Rényi Negativities):ノイズが混ざった状態(混合状態)における、純粋な量子もつれを測る指標。
- スタビライザー・エントロピー(量子マジック):システムが古典コンピュータでどれくらいシミュレーションしにくいか(量子特有の計算能力の源泉)を測る指標。
これらはすべて密度行列 ρ の非線形な関数(ρ2 や ρn など)として定義されるため、従来のストレートな計算手法では求めることができませんでした。
💡 あわせて読みたい
【図解】エンタングルメント・エントロピーをどう計算する?
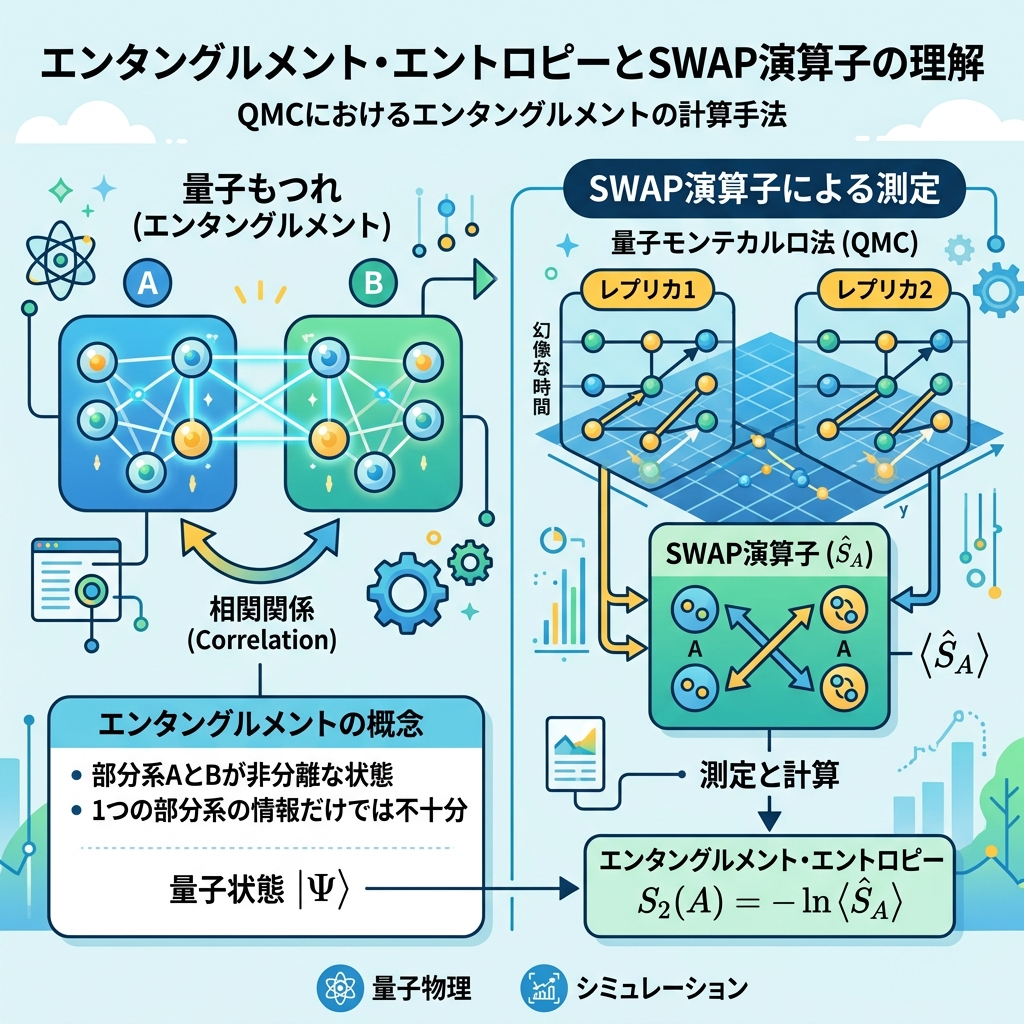
では、QMCはどのようにしてこれら非線形な量を計算しているのでしょうか。最も代表的な「レニイ・エンタングルメント・エントロピー」の計算手法である「SWAP演算子法」を例に見てみましょう。
非線形な量(例えば qTr(ρ2)q)を計算する際のトリックは、「同じシステム(レプリカ)をコンピュータ上に複数用意する」というアプローチです。
例えば qnn=2 のレニイ・エントロピーを計算したい場合、完全に独立した2つのコピー(レプリカ1とレプリカ2)をQMC上で同時にシミュレーションします。そして、特定の領域 qAq について、レプリカ1とレプリカ2の「状態を入れ替える(SWAPする)」という特殊な観測を行います。
このSWAP演算子の期待値を測定することで、驚くべきことに Tr(ρA2) という非線形な値が、QMCにおける線形な期待値計算に帰着されます。この「レプリカ・トリック」と高度なサンプリング技術の組み合わせにより、以前は不可能と思われていた巨大な量子多体系のエンタングルメントが計算できるようになったのです。
研究の最前線と今後の展望
このQMCの進化により、量子スピン液体のようなエキゾチックな物質の相転移や、デコヒーレンス(量子性が失われる現象)が多体系に与える影響など、これまでは理論上の概念だったものを数値的に検証できるようになりました。
今後の課題としては、フェルミオン(電子など)のシステムにおける「符号問題」をいかに回避しながらこれらの情報量を計算するか、また、機械学習モデル(テンソルネットワークやニューラルネットワーク量子状態)とQMCをどう融合させるかが鍵になるでしょう。
個人的には、これらの高度なシミュレーション技術が成熟することで、いずれは量子アルゴリズムの開発や量子エラー訂正の設計など、よりエンジニアリングに近い領域へと直接的な恩恵をもたらすと期待しています。
まとめ
今回は、レビュー論文『Quantum Monte Carlo in the Age of Many-Body Quantum Information』をもとに、QMCの進化について解説しました。要点は以下の通りです。
- QMCは線形な物理量の測定から、エンタングルメントなどの非線形な「量子情報量」の診断ツールへと進化した。
- レプリカを用いて状態を入れ替える「SWAP演算子」などの巧妙なトリックにより、計算不可能に見えた指標が算出可能になった。
- 量子マジックや混合状態のエンタングルメントなど、量子計算の優位性を探るための指標も計算可能になりつつある。
量子力学と情報理論、そして数値計算技術が融合していくこの分野は、今後も目が離せません。興味がある方は、ぜひ元の論文もチェックしてみてください。