「AIコーディングのベンチマークで90%以上のスコアを出している最先端モデルを、自社のGitHubリポジトリに連れてきてバグ修正を任せてみたら、関連ファイルを1つも見つけられずに迷子になり、全く見当違いなパッチを出して沈黙した…」—— CursorやClaude Code、Devinなどの自律コーディングツールを現場に導入しようとしたエンジニアなら、誰もが一度は直面する深いギャップです。
前回の第9回:HumanEvalとPass@kでは、単一ファイルのPython関数をユニットテストで自動採点する仕組みを解説しました。しかし、現実の開発現場にあるコードは、1ファイル数十行のパズル問題ではありません。何千何万行ものファイル群、複雑に絡み合うクラス設計、過去の遺産(レガシーコード)、そして何百もの既存テストスイートが存在する「生きたソフトウェア」です。
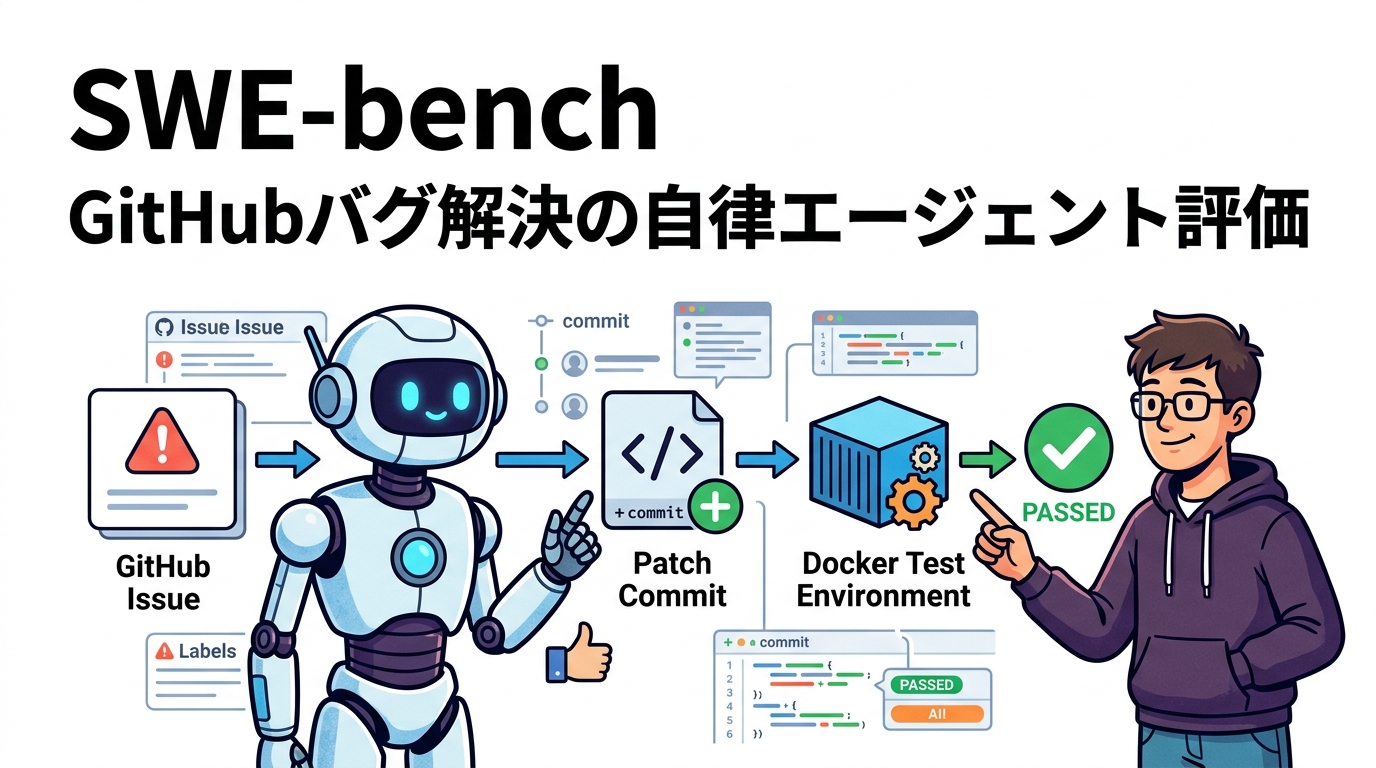
この「実務リポジトリにおける本物のバグIssueを、AIが独力で調査・修正・検証できるか」を極限までリアルにテストする業界標準の金字塔として2023年末にプリンストン大学が発表したのが「SWE-bench(Software Engineering Benchmark)」です。親記事のLLM評価指標の完全総覧【全体俯瞰編】でも、自律ソフトウェアエンジニアリング能力を測る究極の登竜門として位置づけました。
結論から言うと、「SWE-benchは、実在する人気オープンソース(Djangoやsympy等)の過去のGitHub IssueをAIに渡し、隔離されたDocker環境でパッチを適用して『バグが直り、かつ他のテストを1つも壊していないか』を厳格判定する、現在最も過酷で実用的なエンジニアリング・ベンチマーク」です。
この記事では、なぜ初期のGPT-4がわずか1.96%しか解けなかったのか、FAIL_TO_PASSとPASS_TO_PASSによる鉄壁の合否ロジック、そしてOpenAIと共同開発された「SWE-bench Verified」の最新動向までを、現場プログラマの視点からわかりやすく紐解きます!
SWE-benchとは何か?1関数の「お遊び」から「実務リポジトリ」への大跳躍
HumanEvalとSWE-benchの決定的な違い
従来のHumanEval[第9回]や競合する各種コーディングテストは、いわば「学校の小テスト」でした。問題文と関数の引数がすべて1つの画面に提示されており、外部ライブラリも使わず、アルゴリズムを数行〜数十行補完するだけで満点が取れます。
しかし、本番の実務開発で求められるタスクは全く異なります。SWE-benchが突きつけるのは、以下のような冷酷な現実です。
| 比較項目 | HumanEval[関数単体補完) | SWE-bench(実務リポジトリ解決) |
|---|---|---|
| 対象の規模 | 1ファイル(数十行) | リポジトリ全体(数万〜数十万行) |
| 入力情報 | 関数のDocstringと入出力例 | 人間のユーザーが書いた曖昧なGitHub Issue |
| 修正箇所の特定 | 指定された関数の内部のみ | どのファイルのどの行を直すべきかすら不明 |
| 出力フォーマット | Pythonコードブロック | git diff 形式の統合パッチ(.patch) |
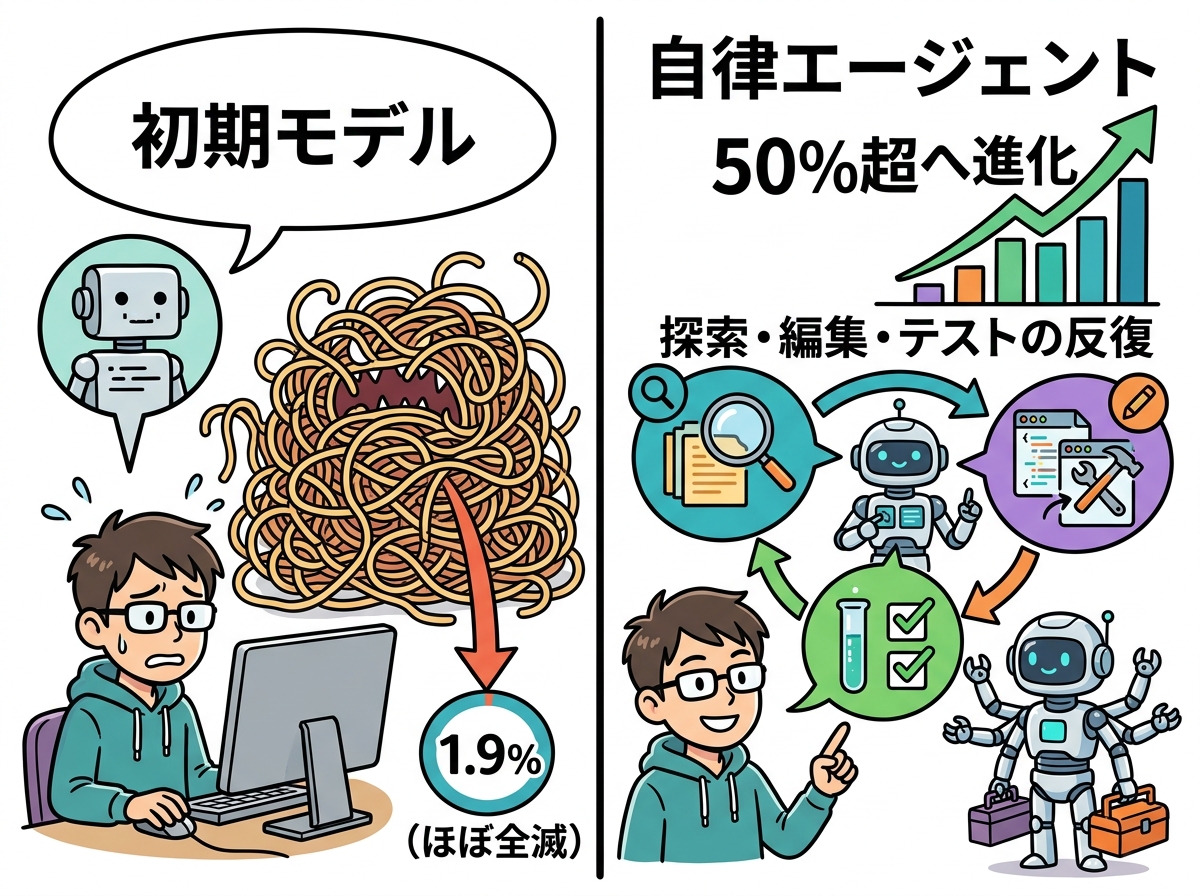
| 初期GPT-4の正解率 | 約 67% 〜 80% | わずか 1.96%(ほぼ全滅) |
HumanEvalでどれだけ優等生であっても、巨大なリポジトリに放り込まれると「どのファイルにバグがあるのか」を探すだけでコンテキストウィンドウを使い果たしてクラッシュしてしまいます。この壁を突きつけたことが、AI開発の歴史における最大の転換点となりました。
対象リポジトリ:Djangoからpytestまで実在する12のOSS
SWE-benchのデータセット(フルセット全2,294件)は、世界中の開発者が日々愛用している代表的なPythonオープンソースプロジェクトの実リポジトリから収集されています。
- Webフレームワーク:
django(超巨大かつ複雑なアーキテクチャ) - 機械学習・数値計算:
scikit-learn,sympy - ネットワーク・開発基盤:
requests,pytest,sphinx,flask,pylintなど
人工的に作られたトイプロブレムではなく、「かつて世界中のプログラマが実際に頭を抱え、Issueを立て、PRで議論してマージされた本物の修正履歴」そのものが問題集になっているのです。
【合否の核心】Docker環境と2段階テスト(FAIL_TO_PASS / PASS_TO_PASS)
AIにテストコードを書かせない理由
ベンチマークの公正性を保つ上で、SWE-benchは非常に賢い設計を採用しています。それは「AIには一切テストコードを書かせず、テストの実行環境(Dockerコンテナ)も完全に隔離する」という点です。
もしAI自身にテストを書かせてしまうと、「自分の生成したバグ入りコードが通るようにテストコードの方を書き換える(アサーションを削除する)」というチート(自己都合判定)が容易に起きてしまいます。そこでSWE-benchでは、オリジナルのPRを作成した人間のエンジニアがコミットした「正解のテストスイート」をサーバー側が隠し持ち、厳格にテストを実行します。
2大テスト関門:FAIL_TO_PASS と PASS_TO_PASS
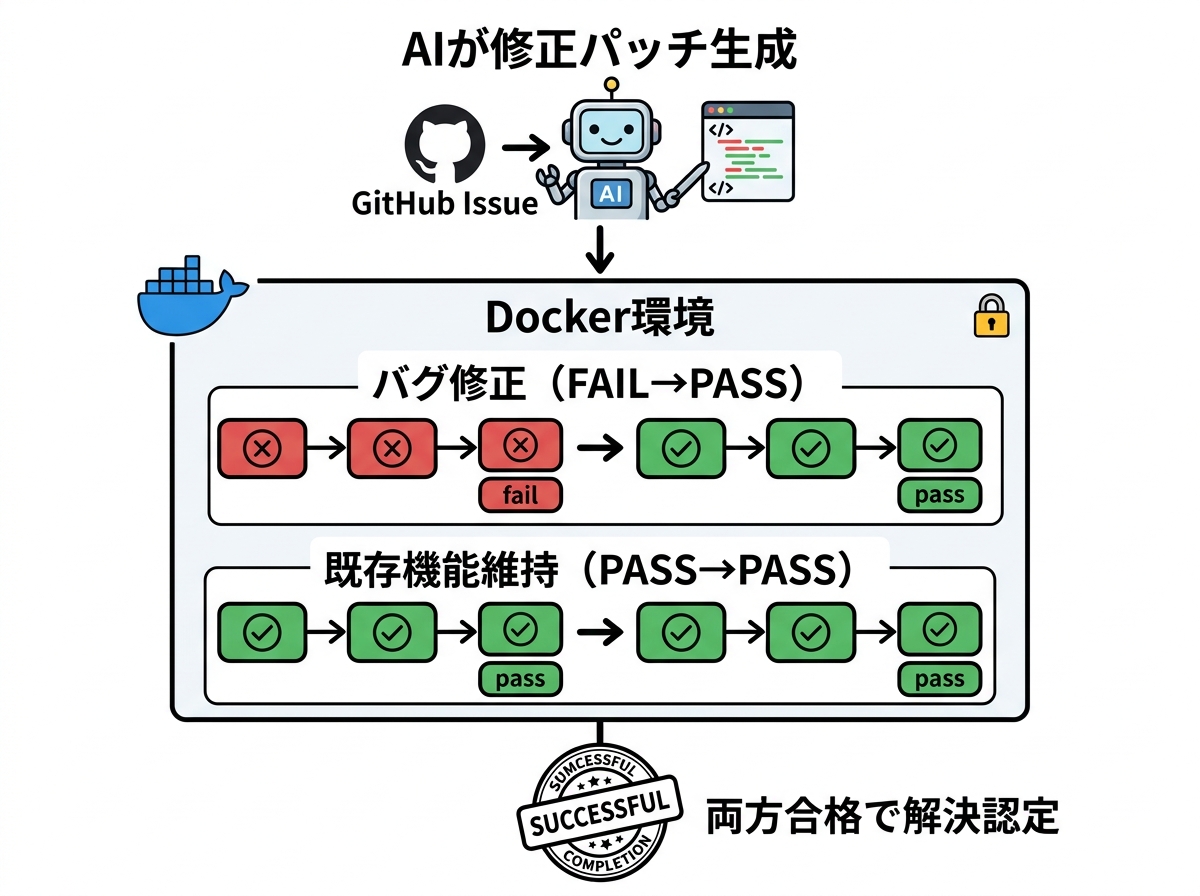
AIが出力した git diff パッチは、対象リポジトリの該当コミットが再現されたDockerコンテナに git apply で適用され、以下の2つのテストスイートが自動実行されます。
【SWE-benchの厳格な合否判定ルール】
- 関門1:FAIL_TO_PASS(バグが本当に直ったかの検証)
修正前のコードベースでは「赤(Fail)」だった再現テストが、パッチ適用後に「緑(Pass)」に転じること。1つでもコケたら即座に不合格。 - 関門2:PASS_TO_PASS(他の既存機能を壊していないかの検証)
リポジトリに元々存在していた数千〜数万の既存テスト群を実行し、修正前も修正後も「緑(Pass)」のままであること。バグは直ったが別の機能にデグレード(リグレッション破壊)を引き起こした場合は即座に不合格。
👉 関門1と関門2の「両方を100%パスした時のみ」、そのタスクは【Resolved(解決済み)】と認定されます。
実務の現場でも、「Issueのバグは直したけれど、他のAPIが全部動かなくなって本番障害を起こした」という修正は0点どころかマイナスですよね。SWE-benchはこの現場のソフトウェアエンジニアリング原則をそのまま自動判定ロジックに落とし込んでいるのです。
SWE-bench Lite と SWE-bench Verified の決定的な違い
フルセットが直面した「コストとノイズの壁」
SWE-benchのフルセット(2,294問)は素晴らしいベンチマークでしたが、普及にあたって2つの巨大な課題がありました。
- 実行コストの爆発: Djangoなどの巨大リポジトリで数万件のテストスイートを2,294問分Docker実行すると、1回のモデル評価だけで数十万円〜百万円以上の計算リソースと丸数日の時間がかかる。
- 人間のIssueの曖昧さ(ノイズ): 2,294問の中には、「Issueの説明文が2行しかなく、何がしたいのか人間でもエスパー不可能なもの」や、「環境依存・外部ネットワーク接続が必要でDocker内で再現困難なテスト」が少なからず混ざっていた。
現在の業界標準:500問の「SWE-bench Verified」
この課題を解決するため、2つの派生版が生み出されました。
| バージョン | 問題数 | 特徴と位置づけ |
|---|---|---|
| SWE-bench Full | 2,294問 | 元祖の全量セット。評価コストが極めて高いため現在フルランする企業は少数。 |
| SWE-bench Lite | 300問 | 自己完結性が高く評価しやすいタスクを機械的に300問サンプリングした軽量版。手軽な研究比較用。 |
| SWE-bench Verified | 500問 | OpenAIの研究チームとプロの人間のソフトウェアエンジニアが全問を精査。曖昧なIssueや不完全なテストを完全除外した【現在の業界公式ゴールドスタンダード】。 |
現在、Anthropic(Claude 3.5 Sonnet)、OpenAI(o1 / GPT-4o)、Cognition(Devin)などが公式発表で競い合っている数字は、ほぼ例外なくこの「SWE-bench Verified」の解決率(Resolved %)です。
歴史的ブレイクスルー:1.96%から50%超えへ導いた「エージェント技術」
なぜ単体のLLMでは解けなかったのか?
2023年秋の登場当初、GPT-4に「Issueの文章」と「関連しそうなコード」をそのままプロンプトに入れてパッチを出力させても、わずか1.96%しか正解できませんでした。なぜなら、実務開発は「一撃のプロンプト」で解ける性質のものではないからです。
人間がバグを直すときの行動を思い出してください。
- Issueを読んでエラーメッセージや怪しいキーワードを特定する。
git grepやファイル検索で関連ファイルを複数洗い出す。- コードを読み進め、関数呼び出しのトレースや型定義を追う。
- 仮のコードを書き換えてみて、ローカルテストを実行する。
- エラーログを見て「あ、ここじゃなくて呼び出し元の設定が原因か」と気付き、別のファイルを直す。
この「探索 → 編集 → テスト実行 → 反省・修正」という複数ターンの試行錯誤(フィードバックループ)がなければ、どれだけ知能の高いLLMでも実務のIssueは解けません。
SWE-agent、Claude Code、Cursorが切り拓いた境地
このブレイクスルーをもたらしたのが「エージェント型アーキテクチャ(Agentic Workflow)」です。
LLMにBashコマンド実行、ファイル検索(ripgrep)、差分ビューア、ディレクトリ閲覧などのツールを与え、自律的にコマンドを叩いてエラーを自己修正しながら解かせる「SWE-agent」や「Claude Code」などのフレームワークが登場したことで、スコアは1年足らずで10% → 30% → 50%超へと垂直立ち上がりを遂げました。
実務での活用法:開発チームがAIツールを選定する3大チェックポイント
1. 単一ファイル補完とリポジトリエージェントの使い分け
エディタのタイピング中にリアルタイムで数行をサジェストする用途(GitHub Copilot等)には、前回のHumanEval[Pass@1)の応答速度と精度が重要です。一方で、「このIssueをまるごと直しておいて」とバックグラウンドで自律作業を任せる用途には、SWE-bench Verifiedのスコアが唯一無二の性能指標になります。
2. ソリューションリークと過学習(ベンチマーク汚染)の警戒
SWE-benchのIssueは公開GitHubから採られているため、「学習データに修正PRのコードが含まれていたのではないか(データ汚染)」という議論が常にあります。実務でモデルを選ぶ際は、ベンチマークの公称値だけでなく、「自社の非公開プライベートリポジトリ」でPoC(概念実証)を行い、社内独自のIssueで再現性をテストすることが不可欠です。
3. 人間とAIの役割分担(Human-in-the-Loop)
現在トップレベルのAIエージェントでも、SWE-bench Verifiedのスコアは50%前後です。裏を返せば、「2問に1問はバグ修正に失敗するか、微妙なパッチを出してくる」ということです。したがって、自社でAIエージェントを本番導入する際は、いきなり自動コミット&デプロイさせるのではなく、「AIがブランチを切ってPRを作成し、最終的なレビューとマージは人間エンジニアが行う」というセーフティネット設計が鉄則となります。
なお、こうした自律エージェントを長時間実行する際のAPIトークン消費とコスト最適化については、以前まとめたLLMのトークン節約術でも実践テクニックを詳しく紹介しています。
よくある質問(FAQ)
Q1: SWE-benchのスコアが高いモデルは、Python以外の言語(TypeScriptやGo、Rustなど)でも優秀ですか?
A: 高い相関がありますが、完全に同等ではありません。SWE-benchの標準リポジトリはPythonですが、ファイル探索の戦略、リグレッション防止の論理思考、エラーログの読解力といった「メタ的なエンジニアリング能力」は言語を問わず転移します。なお、多言語のソフトウェア工学評価向けには、SWE-benchをJavaやC++、JavaScriptに拡張した派生ベンチマークも登場し始めています。
Q2: SWE-benchが100%になったら、人間のソフトウェアエンジニアは不要になりますか?
A: 不要にはなりません。SWE-benchは「すでに誰かがIssueとして症状や再現手順を言語化してくれた後のバグ修正」をテストしています。しかし現実のエンジニアリングにおいて最も難しく価値が高いのは、「ユーザーが本当に困っている潜在ニーズの発見」「ビジネス要件からアーキテクチャへの落とし込み」「仕様自体の設計」「他部署との合意形成」といった上流工程です。AIエージェントはエンジニアの仕事を奪うのではなく、「Issue修正という手作業を爆速で片付けてくれる最強のジュニアパートナー」として機能します。
まとめ
今回は、LLMの実務ソフトウェア開発能力を測る最前線ベンチマーク「SWE-bench」について、その過酷な判定メカニズムとエージェント技術による進化の軌跡を解説しました。要点を振り返ってみましょう。
- 実務リポジトリ解決: 1ファイルの関数補完[HumanEval]を脱却し、Djangoなど実在する巨大OSSのGitHub Issueを自律解決できるかを測るベンチマーク。
- 鉄壁の2段階テスト: Docker環境でパッチを適用し、「バグ再現テストが通る(FAIL_TO_PASS)」かつ「既存機能が一切壊れていない(PASS_TO_PASS)」の両方を満たして初めてResolved(合格)。
- SWE-bench Verified: 人間のプロエンジニアが500問を厳選・検証した、現在の業界標準ゴールドスタンダード。
- エージェントの勝利: 一撃の生成では解けず、ファイル探索・テスト実行・自己修正を自律的に繰り返す「ReActエージェント」によって正解率が飛躍的に進化。
コード生成と実務リポジトリ開発の評価指標を制覇したところで、連載第4弾「実務タスク・特化領域指標編」のラストを飾る次回は、社内ナレッジ活用の最重要アーキテクチャであるRAGの評価フレームワーク「第11回:RAGASの4大指標と計算方法!社内文書QAシステムの精度(忠実性・関連性)を数値化する実践ガイド」を徹底解説します。お楽しみに!