LLM(大規模言語モデル)を自社の業務システムやAPI連携に組み込んで開発していると、誰もが一度は頭を抱えるトラブルがあります。それが「プロンプトに『JSON形式のみで出力して』『500文字以内で要約して』とあれほど厳命したのに、余計な挨拶文がついたり文字数をオーバーしたりして後続のプログラムがエラー落ちする…」という現象です。
前回の第7回:Chatbot ArenaとEloレーティングでは、人間の主観による会話の心地よさや総合的な知能ランキングを解説しました。しかし、システム開発の現場において最も切実なのは、「会話が上手いか」以上に「定められたフォーマットや制約条件(文字数・形式・禁止事項)を1ミリの狂いもなく厳守できるか」というルール厳守力です。
この「指示追従能力(Instruction Following)」を、AI審査員の主観を一切挟まず、Pythonプログラムで100%白黒判定する画期的なベンチマークとして2023年末にGoogle Researchが発表したのが「IFEval:Instruction-Following Evaluation」です。親記事のLLM評価指標の完全総覧【全体俯瞰編】でも、実務・システム運用の最重要ゲートキーパーとして位置づけました。
結論から言えば、「IFEvalは、文字数・JSON形式・禁止語など『プログラムで客観的に合否判定できる約25種類の制約』をモデルがどれだけ忠実に守れるかをテストする、エンジニアにとって最も実用的で嘘のつけないベンチマーク」です。この記事では、IFEvalの過酷な採点ロジックから、Strict/Loose判定の決定的な違い、実務でのモデル選定基準までを詳しく解説します!
IFEvalとは何か?「客観的に検証可能な指示」だけをテストする新基準
なぜAI審査員(LLM-as-a-Judge)を使わないのか?
第6回で解説した「LLM-as-a-Judge」は柔軟な文章評価ができる反面、位置バイアスや冗長性バイアスといった主観のブレがどうしても残るという課題がありました。
しかし、システムの入力・出力に求められる要件は、「なんとなく良い感じ」ではなく「ルールを守れているか否か(True or False)」の二者択一です。例えば「JSON形式で返せ」という指示に対し、先頭に「承知しました!」という挨拶が1行混ざっただけで、APIのJSONパーサーは即座に例外エラー(SyntaxError)を吐いてクラッシュしますよね。
そこでIFEvalでは、採点にLLMを一切使いません。正規表現、文字数カウント、構文パース(JSON/XML)、形態素解析といったPythonの決定論的プログラムのみを用いて、合否をミリ単位で機械判定します。主観や採点のブレが完全にゼロである点が、他のあらゆる対話ベンチマークと一線を画す最大の特徴です。
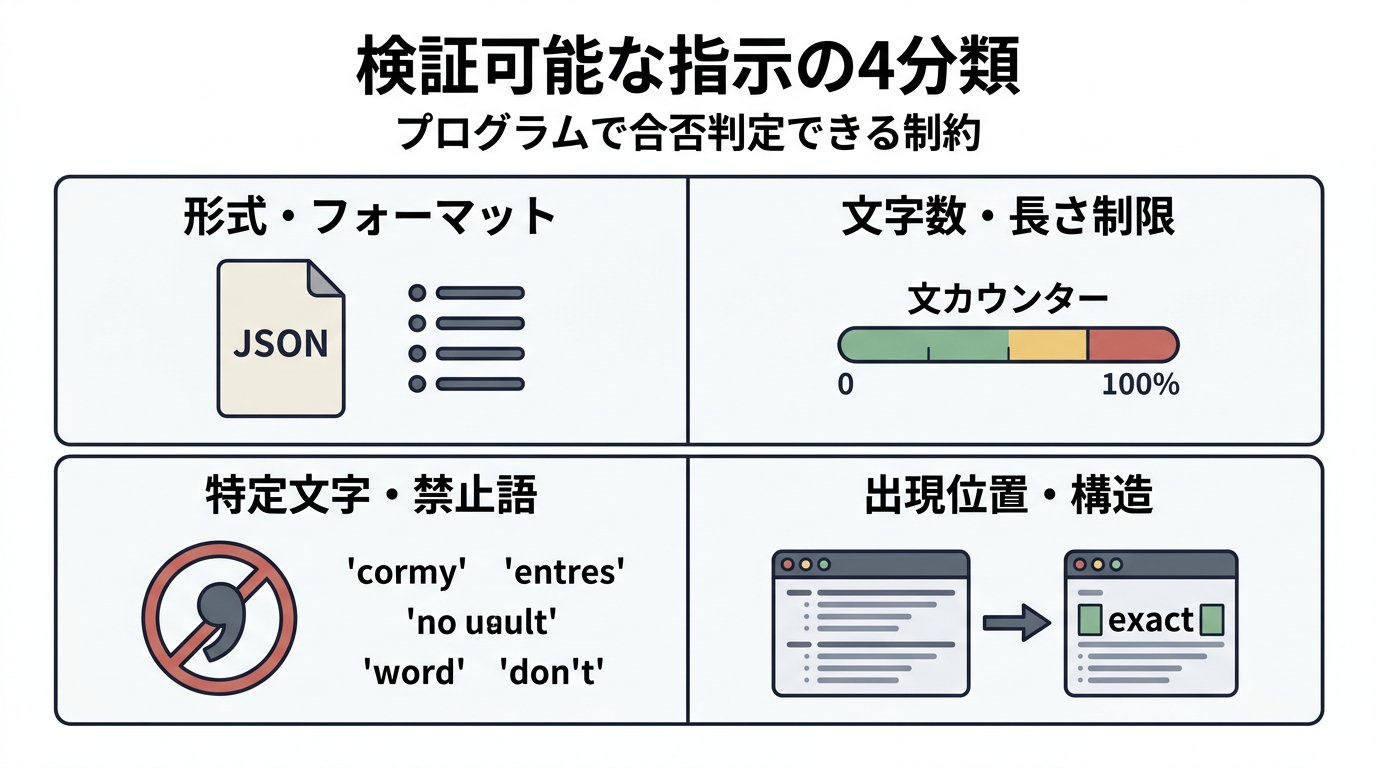
IFEvalが課す「検証可能な制約」の4大分類(約25種類)
IFEvalには、合計500問以上のプロンプトが含まれており、それぞれに以下のような「機械的に検証可能な指示(Verifiable Instructions)」が1〜3個組み合わされて出題されます。
| 制約カテゴリ | 具体的な指示の例 | 機械判定の仕組み |
|---|---|---|
| 形式・フォーマット | 「キー名が指定されたJSONのみで出力せよ」「箇条書きを正確に4項目出力せよ」 | json.loads() の成否、箇条書き記号(* や -)の個数カウント |
| 文字数・長さ制限 | 「300語以上400語以内で書け」「段落数をきっかり2つにせよ」 | 単語分割(トークンではなく語数)の長さ比較、改行コード(\n\n)のカウント |
| 文字・単語の禁止 | 「カンマ(,)を一切使わずに書け」「単語『AI』を含めずに解説せよ」 | 正規表現による禁止文字の完全一致検索(1箇所でもヒットしたら不合格) |
| 構造・出現位置 | 「回答の末尾を必ず『以上で報告を終わります。』で締めくくれ」 | 文字列の末尾一致(endswith)検証 |
人間からすれば「カンマを使わずに文章を書くなんて簡単じゃないか」と思える制約でも、確率的に次のトークンを紡ぎ出すLLMにとっては極めて難易度が高く、モデルの自己統制力が如実に炙り出されます。
【採点の核心】Strict判定 vs Loose判定の違い
一文字の余計な挨拶でも容赦なく落とす「Strict Accuracy」
IFEvalのスコアシートを見るとき、必ず「Strict」と「Loose」という2つの数字が並んでいます。この違いを理解しておくことは実務上とても重要です。
Strict(厳格)判定では、モデルが出力した生のテキスト全体に対してプログラム検証をかけます。たとえ中身のJSONが完璧であっても、前後に「以下がご要望のJSONデータです:」「何かあればまた質問してください!」といった前置きや後置きが1文字でも混ざっていれば、即座に「不合格(Fail)」と判定されます。
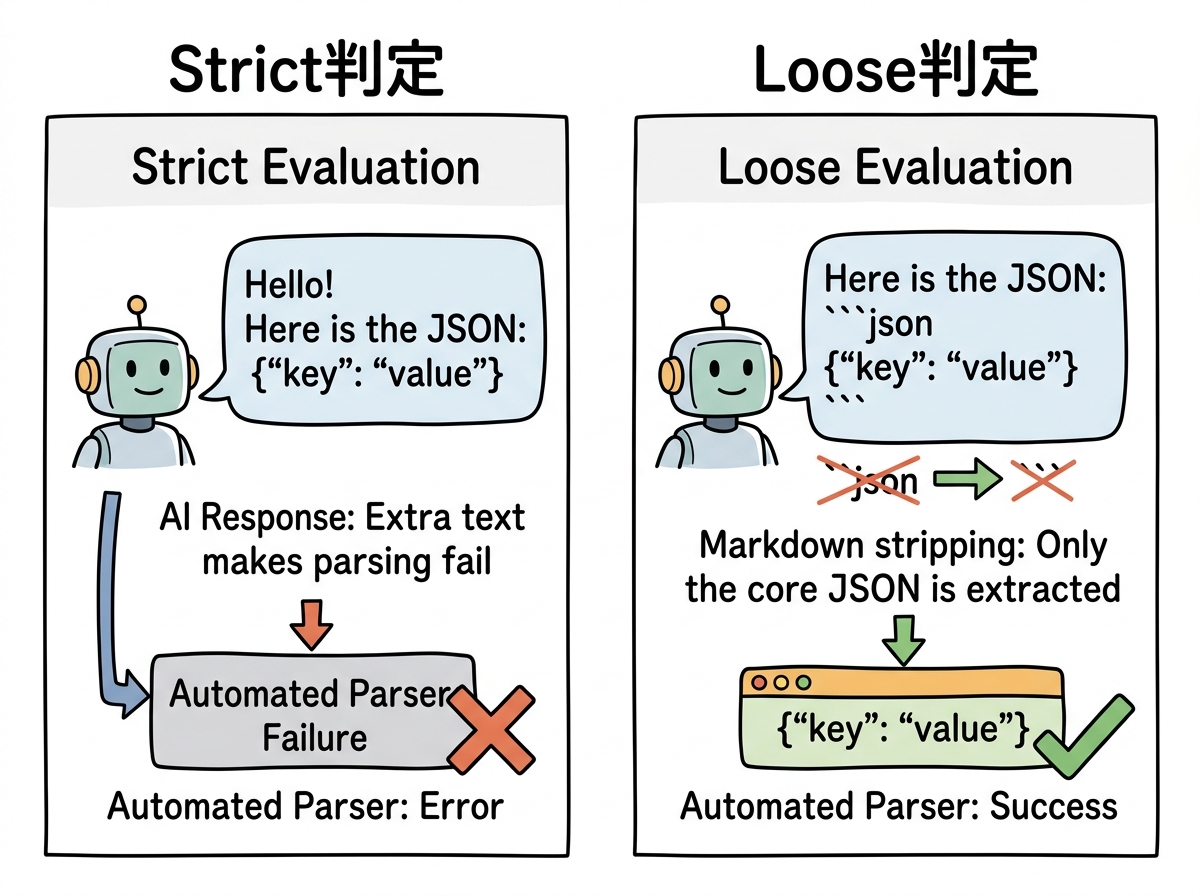
実質的な意図達成を認める「Loose Accuracy」
一方のLoose(寛容)判定では、実務の現場を考慮した前処理(プリプロセス)を施した上で合否を判定します。
具体的には、出力に含まれるMarkdownコードブロック(```json ... ```)の外側にあるテキストや、前後の定型的な挨拶文をスクリプトで自動的に削ぎ落とし、「抽出されたコアな回答部分が制約条件を満たしているか」を検証します。
【Strict vs Loose の判定シミュレーション】
指示: 「有効なJSONフォーマットのみを出力せよ。キーは ‘status’ と ‘code’ の2つを含めること。」
モデルの出力:
承知いたしました。以下を出力します。

{"status": "success", "code": 200}
- Strict判定: ❌ 不合格(全体を
json.loads()すると冒頭の日本語で構文エラーになるため) - Loose判定: ⭕️ 合格(正規表現で
{...}のJSON部分だけを抜き出してパースすれば成功するため)
最先端モデル(GPT-4oやClaude 3.5 Sonnetなど)であっても、StrictスコアはLooseスコアより5%〜10%ほど低くなる傾向があります。自社システムの実装が「正規表現で前処理を入れているか」「API直結で生テキストを流しているか」によって、どちらのスコアを重視すべきかが決まります。
💡 あわせて読みたい
実務でどう見る?エンジニア目線でのIFEval活用とモデル選定
MMLUが高くてもIFEvalが低いモデルは「システム組み込み事故」を起こす
学術知識を測るMMLU(第3回で解説)で85%以上の高得点を叩き出しているモデルでも、IFEvalのStrictスコアが60%前後に沈んでいるオープンソースモデルは珍しくありません。
こうしたモデルは「知識は豊富で長文解説は上手いが、システム側のプロンプトエンジニアリングで課したフォーマット制限(JSON・文字数・不要テキストの排除)を頻繁に破る」という特徴を持っています。チャット相手としては楽しめても、自律エージェントのツール呼び出し(Function Calling)や構造化データ抽出パイプラインに投入すると、パースエラーでパイプラインを止めてしまう事故が多発します。
実務システムに導入する際の3大ベストプラクティス
IFEvalスコアの知見を自社の開発に活かすための実践ポイントは以下の3点です。
- 1. Strict スコア75%以上をAPI組み込みの足切りラインにする: JSON抽出や自動DB登録など、後続システムへデータを渡す用途では、Strict Accuracyが75%(Looseで85%以上)出せるモデルを初期選定の必須条件にする。
- 2. プロンプト側の制約は2〜3個以内に絞る: IFEvalの実験データでも、指示の数が1個から3個に増えるだけで正解率が急激に低下することが示されています。一度に「JSONで」「カンマなしで」「300文字で」「敬語で」と制約を詰め込みすぎず、チェーン分割(パイプライン化)を検討する。
- 3. システム側でのサニタイズ(Loose前提設計)を怠らない: どんなに優秀なモデルでもStrictで100%を守り切るのは困難です。バックエンド側でMarkdownフェンス(“`)の除去や正規表現によるJSON抽出フォールバックを必ず実装しておく。
なお、プロンプトの文字数制約や出力トークン数の最適化によってAPIコストを最小化する具体的な実装テクニックについては、以前書いたLLMのトークン節約術でも詳しくまとめていますので、ぜひ併せて参考にしてみてください。
よくある質問(FAQ)
Q1: IFEvalのスコアは日本語プロンプトでもそのまま当てはまりますか?
A: 基本的な傾向(モデルの指示追従に対する自己統制力)は日本語でも強く相関しますが、完全一致ではありません。IFEvalの標準データセットは英語で作成されており、「単語数(Word Count)」などの制約判定ロジックが英語基準(スペース区切り)で組まれているためです。日本語環境で厳密に評価したい場合は、自社で「文字数(Character Count)」や「句読点制約」に合わせた日本語版テストセットを構築して評価することをおすすめします。
Q2: Structured Outputs(OpenAI等のJSONスキーマ強制)を使えばIFEvalは不要ですか?
A: 純粋なJSON構造の強制だけであれば、API側のスキーマ制約(Constrained Decoding)で100%解決できます。しかしIFEvalは、JSONだけでなく「否定の遵守(〜を含めるな)」「文脈に応じた長さ制約」「特定スタイルの厳守」といった、スキーマ機能だけでは制御できない『モデル自身の論理的自制心』を総合的に測定しているため、複雑な自律エージェント構築時の選定指標として依然として極めて重要です。
まとめ
今回は、LLMの指示追従力とルール厳守力をプログラムで機械判定する「IFEval」について、その判定メカニズムから実務での活用法までを解説しました。要点を振り返ってみましょう。
- IFEval:Instruction-Following Evaluation: AI審査員を使わず、約25種類の検証可能な制約(JSON、文字数、禁止文字等)をPythonプログラムで100%客観判定するベンチマーク。
- Strict vs Loose: 生テキストの完全遵守を求める「Strict」と、前後の余計な挨拶を除去して実質判定する「Loose」の2段階で評価される。
- 実務での重要性: MMLUやMATHが高くてもIFEvalが低いモデルはシステム組み込みでパースエラー事故を起こすため、API連携やエージェント用途の必須足切り指標となる。
- エンジニアの防衛策: プロンプト制約の詰め込みすぎを避け、バックエンド側での正規表現サニタイズ(Loose前提)を必ず組み込む。
対話品質とルール厳守力の指標をマスターしたところで、次回からは連載の第4弾「実務タスク・特化領域指標編」へと進みます!第9回は、エンジニアにとって最も身近なコード生成能力を測る金字塔「第9回:HumanEvalとPass@kの計算方法!AIコーディング評価の不偏推定量を理解する」を解説します。お楽しみに!