「GPT-2のモデルが22,580個分——それが7年間でのスケールアップだ」。2026年7月27日、Xにこんな書き出しで始まる記事が投稿されました。ウォータールー大学でインターンをしているaliさん(@waterloo_intern)が書いた「22580: From GPT2 to Kimi3, Explained」というタイトルのポストです。
この投稿は瞬く間に拡散し、650万ビュー・1.4万いいねを集めました。「今まで見たTransformerモデルの系譜解説で最高の出来」というリプライがつくほど、内容の密度と分かりやすさで話題になっています。本記事では、この解説を日本語でかみ砕きながら、GPT-2からKimi K3に至るLLMアーキテクチャの主要な変化を整理します。以前書いたLLMのトークン節約術でも触れましたが、LLMのコスト問題の根本にはアーキテクチャの課題があります。その本質が今回でよく分かるはずです。
GPT-2とは – 現代LLMの「基本形」を確認する
GPT-2(2019年、OpenAI)は1億2,400万パラメータのデコーダー専用Transformer(decoder-only Transformer)です。テキストを左から右に1トークンずつ生成する「次のトークン予測」で学習されており、現在主流のGPT系モデルすべてが基本的にこの設計を引き継いでいます。
アテンション機構:MHAとKVキャッシュ
GPT-2の核心はMulti-Head Attention(MHA:マルチヘッドアテンション)です。各Transformerブロックが複数の「アテンションヘッド」を持ち、それぞれが異なる視点でトークン間の関係性を学習します。12ブロック・12ヘッド・埋め込み次元768という構成です。
もう一つの重要な概念がKVキャッシュです。テキストを1トークンずつ生成する際、以前のトークンのKey・Valueベクトルを再計算しないよう保存しておく仕組みで、これがなければ生成のたびに全履歴を再計算する羽目になります。一方でKVキャッシュはシーケンス長に比例してメモリを消費するため、長文生成時のメモリボトルネックになるという課題を持っています。この「KVキャッシュをどう削減するか」が、以降のアーキテクチャ進化の一大テーマになっていきます。
7年間の主要技術の変遷 -何が変わり、何が変わらなかったか
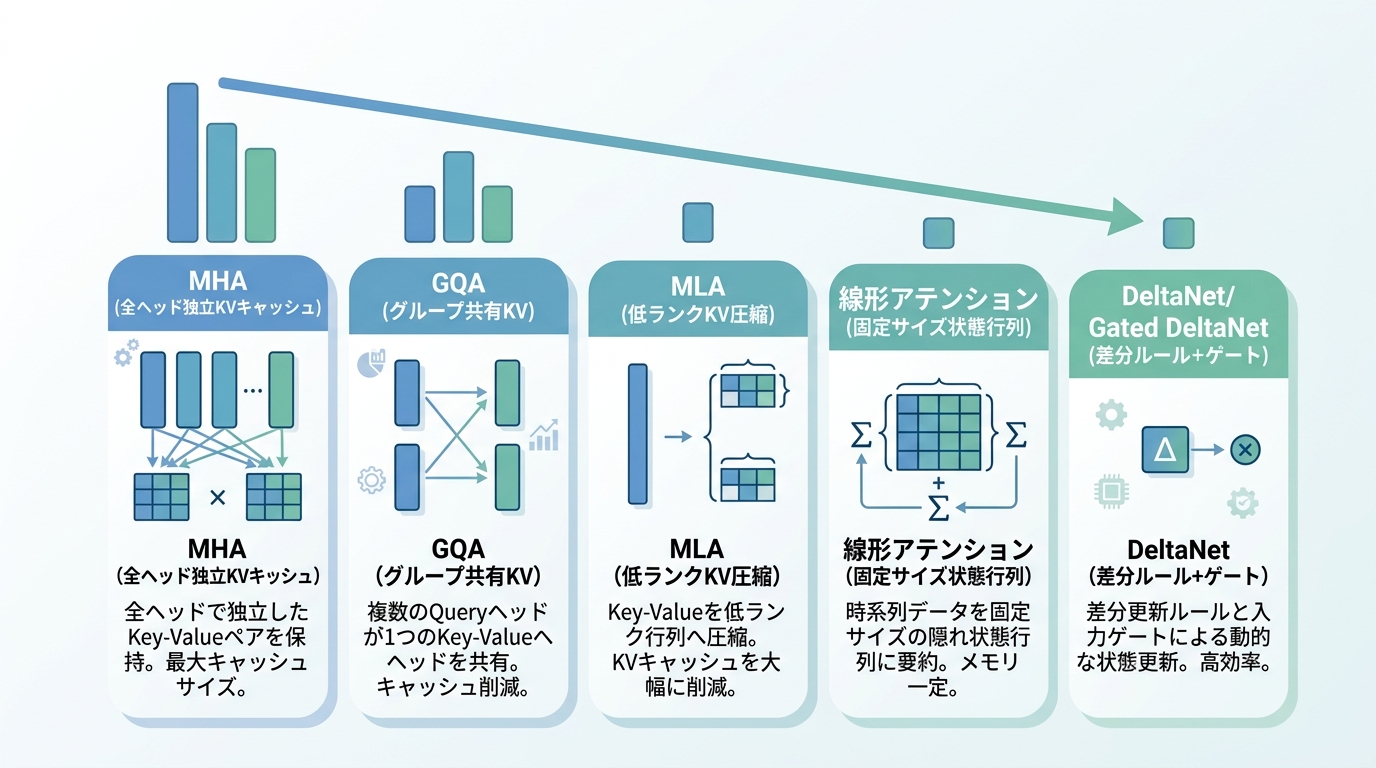
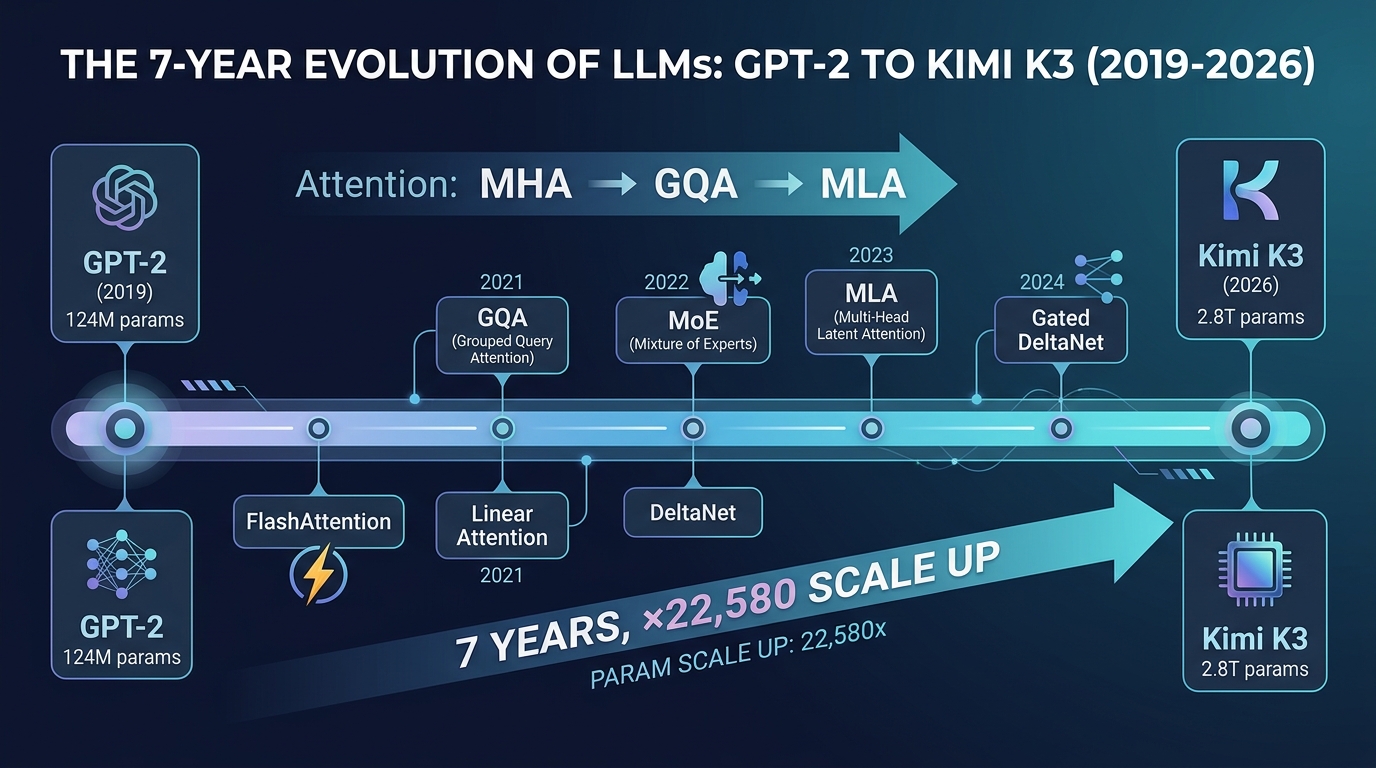
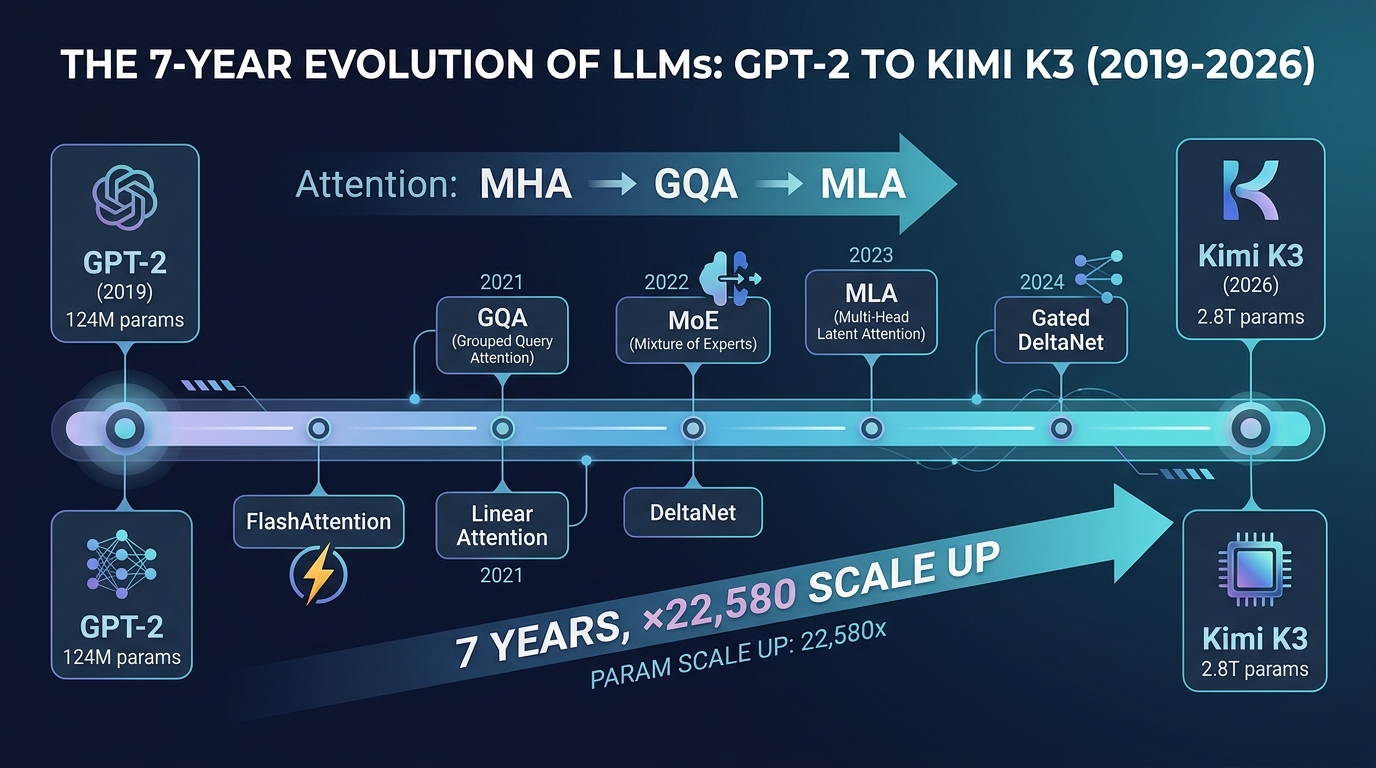
Kimi K3(2026年7月)は総パラメータ2.8兆(2.8T)を誇る巨大モデルです。GPT-2の1.24億パラメータと比べると、確かに22,580倍のスケールアップです。しかし単純に「大きくなっただけ」では、このスケールでまともに動かすことすらできません。そこで登場したのが以下の技術群です。
FlashAttention -「メモリの壁」を突破したアルゴリズム
2022年に発表されたFlashAttentionは、アーキテクチャの変更ではなくGPU上の計算の仕方を改善したアルゴリズムです。従来のAttention計算はN×Nの巨大な行列を一度にGPUのHBM(高帯域メモリ)に書き込む必要があり、シーケンス長の2乗に比例してI/O負荷が増えていました。FlashAttentionはGPUの高速な片上SRAMをタイル単位で活用し、HBMへの読み書きを最小化します。計算結果は数学的に同じでありながら、メモリ消費を系列長に対して線形に抑え、訓練・推論の両方を大幅に高速化しました。
GQA(Grouped Query Attention)-KVキャッシュを削減する現実解
MHAではすべてのアテンションヘッドが独立したKey・Valueを持つため、KVキャッシュが非常に大きくなります。Grouped Query Attention(GQA)は複数のQueryヘッドを1つのKey-Valueグループでシェアする設計で、精度をほぼ維持しながらKVキャッシュのサイズを大幅に削減します。現在のLlamaやQwenなど多くのOSSモデルに採用されている主流の方式です。
線形アテンションとDeltaNet -固定サイズキャッシュへの挑戦
GQAはキャッシュを減らしましたが、それでも系列長に比例して増え続けます。これを根本的に解決しようとするのが線形アテンション(Linear Attention)の発想です。通常のSoftmaxアテンションはq·kの積にSoftmaxを適用しますが、線形アテンションはqとkそれぞれにELU+1などの特徴マップを適用します。これにより計算の順序を入れ替えられるため(再結合可能)、過去のK・Vを固定サイズのD×Dの状態行列に畳み込んで保持できます。キャッシュが系列長に依存しなくなるのです。
ただしトレードオフがあります。Softmaxの代わりに使う特徴マップは表現力が低く、長い文脈での情報混濁(異なる情報が状態行列に混ざり合って区別できなくなる問題)が起きやすいのです。
この課題に取り組んだのがDeltaNetです。新しい情報を状態行列に加算するだけでなく、「今のキーが指している場所にある古い情報を差し引いてから、新しい情報を書き込む」差分更新ルール(Delta Rule)を採用しています。古い情報を明示的に消去して書き替えるため、状態行列の情報混濁が大幅に改善されます。
Gated DeltaNet -「忘れる」能力を追加する
DeltaNetはピンポイントに情報を書き替えられますが、「特定の置き換え先がある情報」しか消せません。話題が切り替わったとき複数の古い情報をまとめてクリアしたり、全体的にメモリを減衰させたりする能力がありませんでした。Gated DeltaNetはそこにゲート機構を追加し、コンテキストスイッチ時に状態全体を部分的に「忘れる」(減衰させる)能力を持たせています。これにより長文処理での文脈管理がさらに柔軟になりました。
Kimi K3のアーキテクチャ -すべての技術の集大成
Moonshot AIが2026年7月にリリースしたKimi K3は、これらの技術を巧みに組み合わせたモデルです。
- MoE(Mixture of Experts):総パラメータ2.8Tのうち推論時に活性化するのは104Bのみ。896個のエキスパートから16個を選択する設計で、巨大な知識を持ちながら推論コストを抑えています
- Kimi Delta Attention(KDA):線形アテンション(主にGated DeltaNet系)をベースにした独自のアテンション機構。93層のうち69層がKDA層です
- Gated MLA層:DeepSeekが採用したMulti-Head Latent Attention(KVを低ランク圧縮)を応用。残り24層に使用されています
- コンテキスト長100万トークン:線形アテンションの固定サイズキャッシュがあってこそ実用的なサイズで実現できている仕様です
要するにKimi K3は「69層のGated DeltaNet系で高速・大容量な文脈管理を行い、24層のフルアテンション層で正確な長距離参照を補完する」ハイブリッド設計です。KVキャッシュの総量は純粋なMHAと比べて約75%削減されており、100万トークンのコンテキストを現実的なGPUリソースで扱えるようになっています。
「スケールだけではない」Kimi K3の本質
GPT-2からKimi K3への22,580倍というスケールアップは確かに印象的な数字ですが、aliさんの解説が指摘しているように、規模拡大と同時にアーキテクチャの質的な変化が積み重なっていることが重要です。
エンジニアとして特に注目すべき点は、「KVキャッシュという具体的な課題」に対してGQA・線形アテンション・DeltaNet・MLAと複数のアプローチが並行して研究され、現在はそれらを組み合わせたハイブリッド設計が主流になっている点です。どれか一つが「正解」ではなく、トレードオフを理解した上でアーキテクチャを組み合わせる設計思想が進んでいます。
また実務的な観点から言えば、Kimi K3はオープンウェイトとして公開されており、Hugging Faceからアクセス可能です。ただし推論には大規模なGPUクラスタが必要で、個人・小規模チームが直接動かすのは現時点では現実的ではありません。一方でKimi K3の技術(Gated DeltaNetなど)は小規模モデルにも応用可能であり、今後の量子化・蒸留技術と組み合わさることで実用的な場面が広がる可能性があります。
まとめ
- GPT-2(124M params)からKimi K3(2.8T params)まで7年間で22,580倍のスケールアップが達成された
- 単なる規模拡大ではなく、FlashAttention・GQA・線形アテンション・DeltaNet・Gated DeltaNet・MoEという技術の積み重ねがあって初めて実用化できた規模である
- LLMの課題解決の中心にはKVキャッシュの削減という明確なテーマがあり、各技術はそのトレードオフを別の方向から解決しようとしている
- Kimi K3は線形アテンションとフルアテンションのハイブリッド設計(3:1比率)を採用し、KVキャッシュ約75%削減と100万トークンのコンテキスト長を両立させている
7年前のGPT-2が今のモデルを見たら「同じTransformerとは思えない」と感じるかもしれません。それほど中身は変わっています。LLMの技術進化に追いつくのは大変ですが、こうした系譜を整理しておくと次の技術変化の文脈もつかみやすくなります。aliさんの原文(英語)はかなりの密度で数式・実装コードまで踏み込んでいるので、英語に自信がある方はぜひ元ポストも読んでみてください。
💡 あわせて読みたい
LLMを実務で使う際のコスト管理についてはこちらも参考にどうぞ。
参考リンク・関連情報
- 🐦 ali (@waterloo_intern) 「22580: From GPT2 to Kimi3, Explained」— 元ポスト
- 🤖 Kimi K3 — Moonshot AI 公式サイト
- 💻 GitHub — MoonshotAI/Kimi-K3(公式リポジトリ)
- 📄 FlashAttention論文(arXiv)
- 📘 GQA: Training Generalized Multi-Query Transformer Models(arXiv)
- 📘 DeltaNet論文(Parallelizing Linear Transformers with the Delta Rule)(arXiv)