技術・プログラミング

AI・機械学習

TruthfulQAとHaluEvalで暴くLLMの嘘!ハルシネーションと迷信トラップの測定法

LLMのもっともらしい嘘や迷信への迎合を暴くTruthfulQAとHaluEvalの測定手法。817問のトラップに対する真実性と有用性の2軸評価(MC1/MC2)や、ハルシネーションを見抜く自動評価の仕組みを整理します。
AI活用

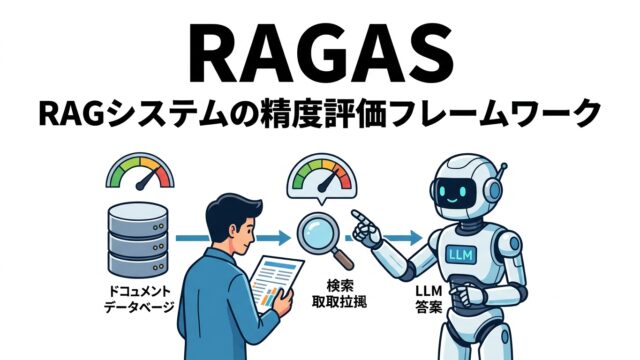
RAGASの4大指標と計算方法!社内文書QAの精度とハルシネーションを数値化する実践ガイド

RAGシステムの回答精度とハルシネーションを数値化するRAGASの評価手法。Faithfulness(忠実性)、Answer Relevance、検索適合率など4大指標によるボトルネック診断と自動評価手順を整理します。
AI・機械学習

Jev徹底解剖|BERTとの違い・System 1の仕組みと導入手順

文章生成を捨てたAI「Jev」を徹底解剖!エンコーダ型BERTとの決定的な違いや並列サンプラーの仕組み、実務ユースケース、Pythonでの導入手順と最小実行コードまで現役エンジニアがわかりやすく解説。判断処理の高速化に必見です。
AI・機械学習

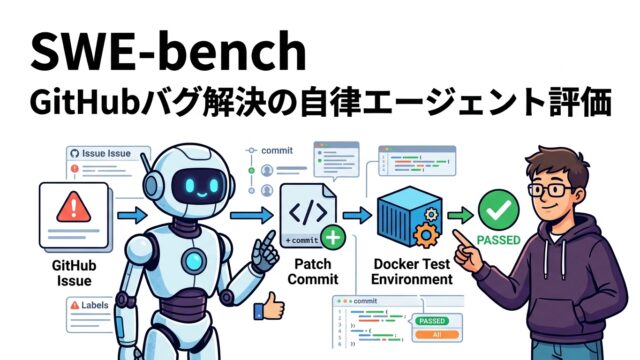
SWE-benchとは?GitHubのバグIssueをAIが自律解決できるか測る最前線

実在するOSSリポジトリのGitHub IssueをAIが自律解決できるか測るSWE-benchの全貌。Docker分離環境でのパッチ適用、FAIL_TO_PASSとPASS_TO_PASSの2段階テストによる合否判定ロジックを整理します。
AI・機械学習

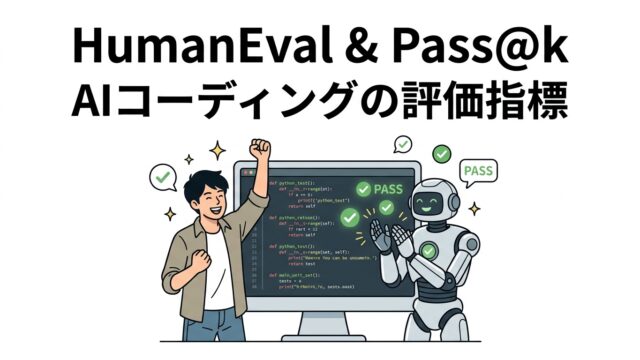
HumanEvalとPass@kの計算方法!AIコーディング評価の不偏推定量を徹底解説

AIのコード生成精度を実行テストで評価するHumanEvalの仕組み。OpenAIの164問のテストセットを対象に、サンプリングによるPass@k(Pass@1/10/100)の不偏推定量計算式や測定の留意点を整理します。
AI・機械学習

IFEval入門!文字数制限やJSON出力を自動テストする指示追従ベンチマーク

LLMが指定ルールを厳守できるかを自動検証するIFEvalの仕組み。JSON形式指定や文字数制限など約25種の制約に対し、余計な挨拶文の混入も落とすStrict判定と実質的達成を見るLoose判定の測定基準を紐解きます。
AI・機械学習

Chatbot ArenaのEloレーティング計算方法!ブラインド対戦でLLMの実力を数値化する数学的仕組み

モデル名を伏せたブラインド対戦でLLMの実力を評価するChatbot Arenaの仕組み。チェス由来のEloレーティング算出法、期待勝率と試合結果によるレート更新、Bradley-Terryモデルによる順位決定の数理を紐解きます。
AI・機械学習

MT-BenchとLLM-as-a-Judgeの仕組み!GPT-4による自動採点と3大バイアスの克服法

MT-BenchとLLM-as-a-Judgeの仕組みを解説!GPT-4等による自動採点のルーブリック設計や、2ターン対話による文脈追従力のテスト法、位置・冗長性・自己選好の3大バイアスを順序スワップで克服する実務手法を網羅。
AI・機械学習

GPQAとBBHの凄さ!最先端LLMの推論限界を暴く博士レベルベンチマーク

最先端LLMの推論限界を検証するGPQAとBBHの出題構造を紐解くガイド。博士号保持者が設計したGoogle検索耐性を持つ448問の極限テストや、言語モデルが躓く23の難関タスクからAIの実力を見極める視点を示します。
AI・機械学習

GSM8kとMATHで測るLLMの思考力!小学校算数から数学難問までの解法ステップ検証

LLMの思考力を測る「GSM8k」と「MATH」を徹底比較。算数文章題から難関数学まで、CoT(思考の連鎖)の役割や、計算ミスを防ぐ「LLM立式+Python実行」の実務アーキテクチャを分かりやすく解説します。